LoRA - 적은 파라미터로 모델을 조정하는 원리
고정된 기본 가중치와 작은 보정 행렬로 학습할 파라미터를 줄이는 LoRA의 원리, 파라미터 계산, 병합 및 QLoRA와 RAG의 차이를 설명합니다.
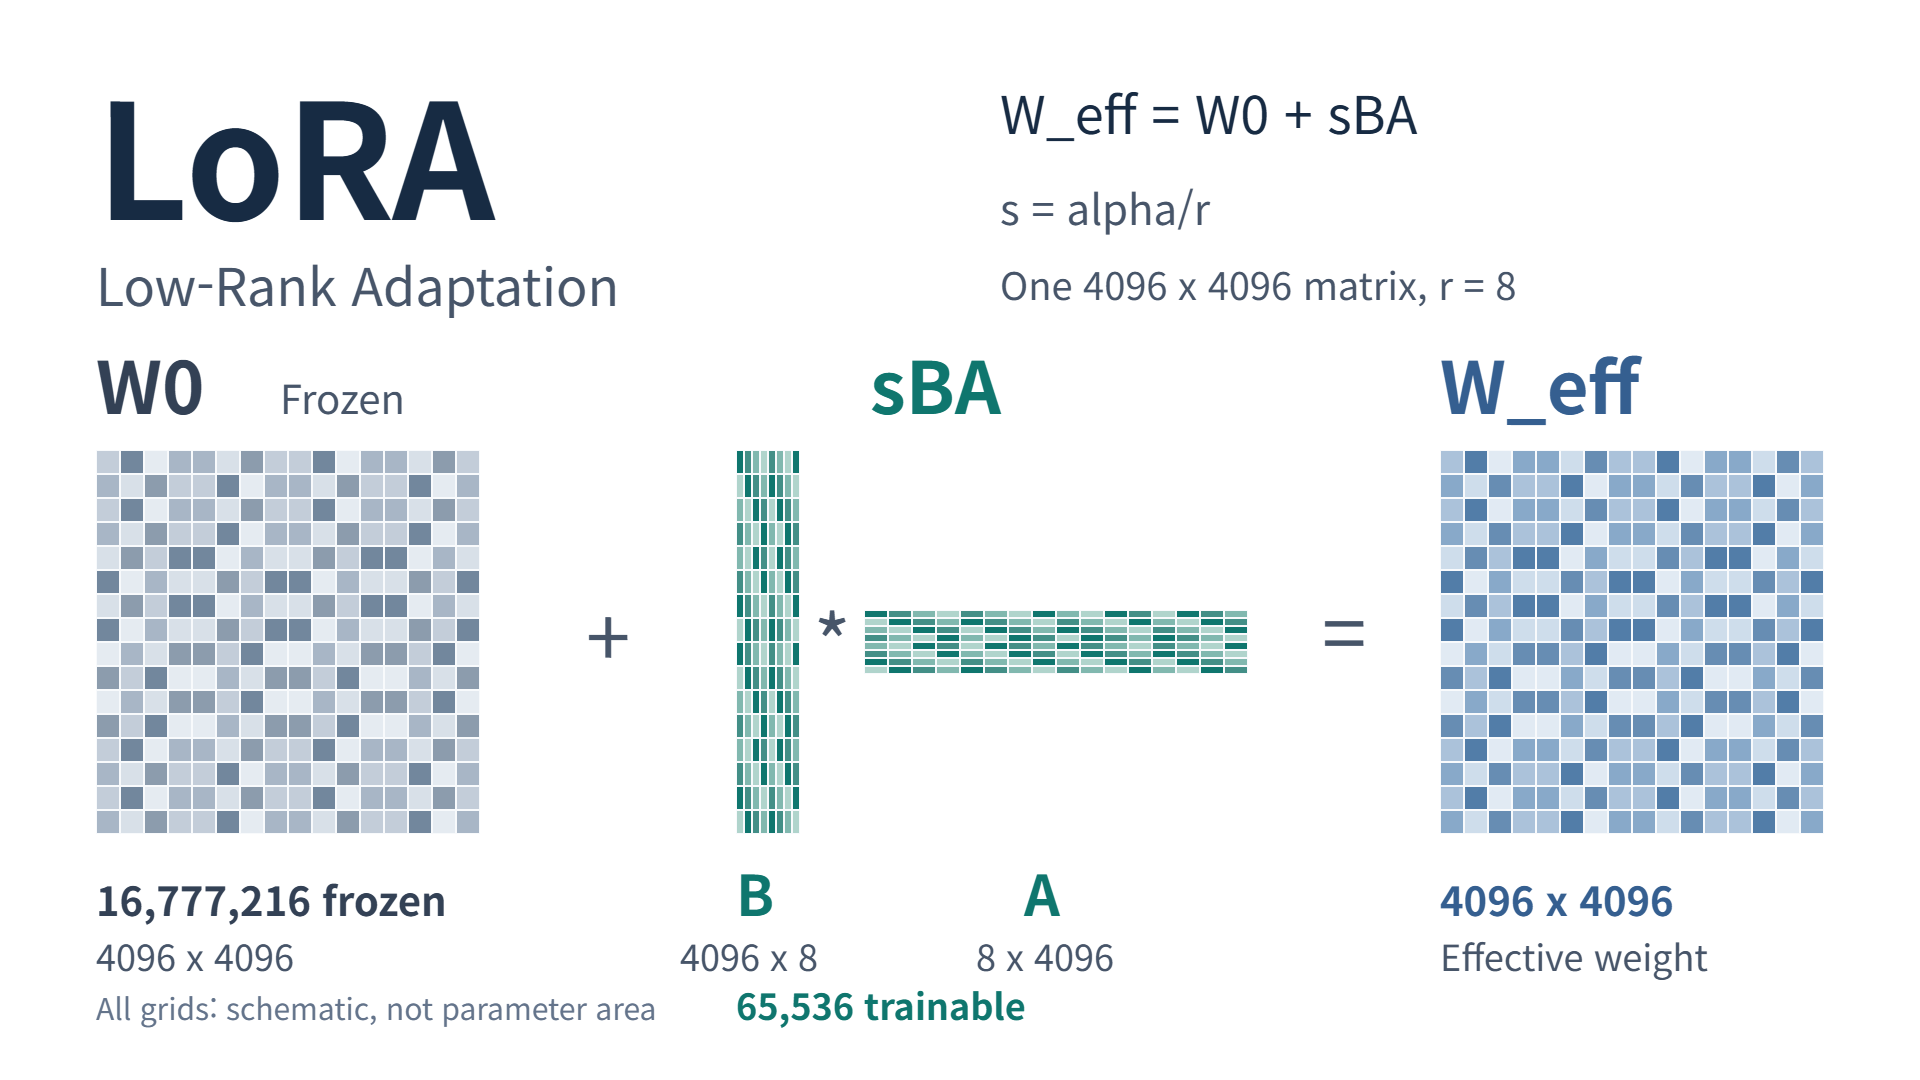
LLM이 공개 운영 보고서를 읽고 요약은 잘하지만, 요청한 분류 기준이나 출력 형식을 반복해서 놓친다면 어떻게 조정해야 할까요? 지시문과 예시를 바꾸는 방법부터 모델을 추가로 학습시키는 방법까지 선택지가 있습니다. 이때 큰 모델의 모든 가중치를 다시 학습하는 부담을 줄이는 방법 중 하나가 LoRA(Low-Rank Adaptation)입니다.
LoRA는 기존 모델을 작게 압축하는 대신, 기본 가중치는 고정하고 작은 두 행렬로 보정량을 학습합니다. 이 차이를 잡으면 학습 파라미터가 줄어드는 이유와 기본 모델 메모리가 여전히 필요한 이유를 함께 이해할 수 있습니다.
1. 전체 가중치를 학습할 때 생기는 부담
모델의 가중치는 입력을 출력으로 바꾸는 계산에 사용하는 수치입니다. 학습에서는 예측과 정답의 차이를 손실(loss)로 계산하고, 그 손실을 줄이는 방향으로 가중치를 조정합니다. 이렇게 학습으로 조정할 수 있는 수치를 파라미터라고 부릅니다.
사전 학습된 모델을 특정 작업의 데이터로 추가 학습하는 과정을 fine-tuning이라고 합니다. 그중 full fine-tuning은 기본 모델의 모든 파라미터를 학습 대상으로 둡니다. 큰 모델이라면 바꿀 수치도 많고, 그 수치를 바꾸기 위해 관리할 정보도 많습니다.
학습 메모리에는 가중치만 올라가지 않습니다. 가중치를 어느 방향으로 바꿀지 나타내는 gradient와 Adam 같은 optimizer가 관리하는 상태도 필요합니다. 역전파 계산을 위해 중간 계산값인 activation도 보관합니다. 따라서 모델 파일이 메모리에 들어간다고 해서 같은 장비로 전체 학습까지 가능한 것은 아닙니다.
공개 문서 요약과 합성 보고서 분류에 각각 전체 모델 사본을 유지하면 저장 부담도 커집니다. 작업별 변경분만 보관할 수 있다면 이 부담을 줄일 수 있습니다.
LoRA 원논문의 접근은 작업에 맞춰 필요한 변화까지 모두 큰 행렬로 학습할 필요가 있는지 묻는 데서 시작합니다. 기본 모델이 이미 가진 가중치는 유지하고, 작업별 변화만 적은 수의 파라미터로 표현하는 방식입니다. 이런 접근을 parameter-efficient fine-tuning(PEFT)이라고 하며, LoRA는 그중 하나입니다.
2. 고정된 기본 경로에 작은 보정 경로를 더합니다
신경망의 선형층 하나는 입력 벡터에 가중치 행렬을 곱합니다. 그 기본 가중치를 \(W_0\), 입력을 열벡터 \(x\)로 두겠습니다. LoRA를 적용하면 같은 입력이 기본 경로와 보정 경로를 지나고, 두 경로의 출력이 더해집니다.
아래 표와 수식은 bias를 생략한 표현입니다. dropout을 사용하지 않거나, dropout을 끈 추론 상태를 가정합니다. 학습 중 보정 경로에 dropout을 적용하는 구현에서는 그 연산도 별도로 고려해야 합니다.
| 기호 | 크기 | 역할 |
|---|---|---|
| \(W_0\) | \(d_{out} \times d_{in}\) | 학습 중 고정 |
| \(A\) | \(r \times d_{in}\) | 입력 축소 |
| \(B\) | \(d_{out} \times r\) | 출력 차원 복원 |
| \(x\) | \(d_{in} \times 1\) | 공유 입력 |
기본 LoRA의 scaling을 \(s = \alpha / r\)로 두면 출력은 다음과 같습니다. \(\alpha\)는 보정량의 크기를 조절하는 설정값입니다.
\[h = W_0x + sB(Ax)\]먼저 기본 경로는 기존의 \(W_0x\)를 계산합니다. 보정 경로에서는 \(A\)가 입력을 폭 \(r\)로 바꾸고, \(B\)가 이를 다시 출력 크기로 바꿉니다. 두 번째 결과에 scaling을 곱해서 첫 번째 결과에 더합니다. 중간 표현이 작아지는 것이지 기본 모델을 그 크기의 모델로 교체하는 것은 아닙니다.
h = W0x + sB(Ax), s = alpha/r
4096 x 4096
W0x
Trainable
Trainable
sB(Ax)
r = 8
s = alpha/r
A + B: 65,536 trainable parameters
One selected matrix; bias/dropout omitted
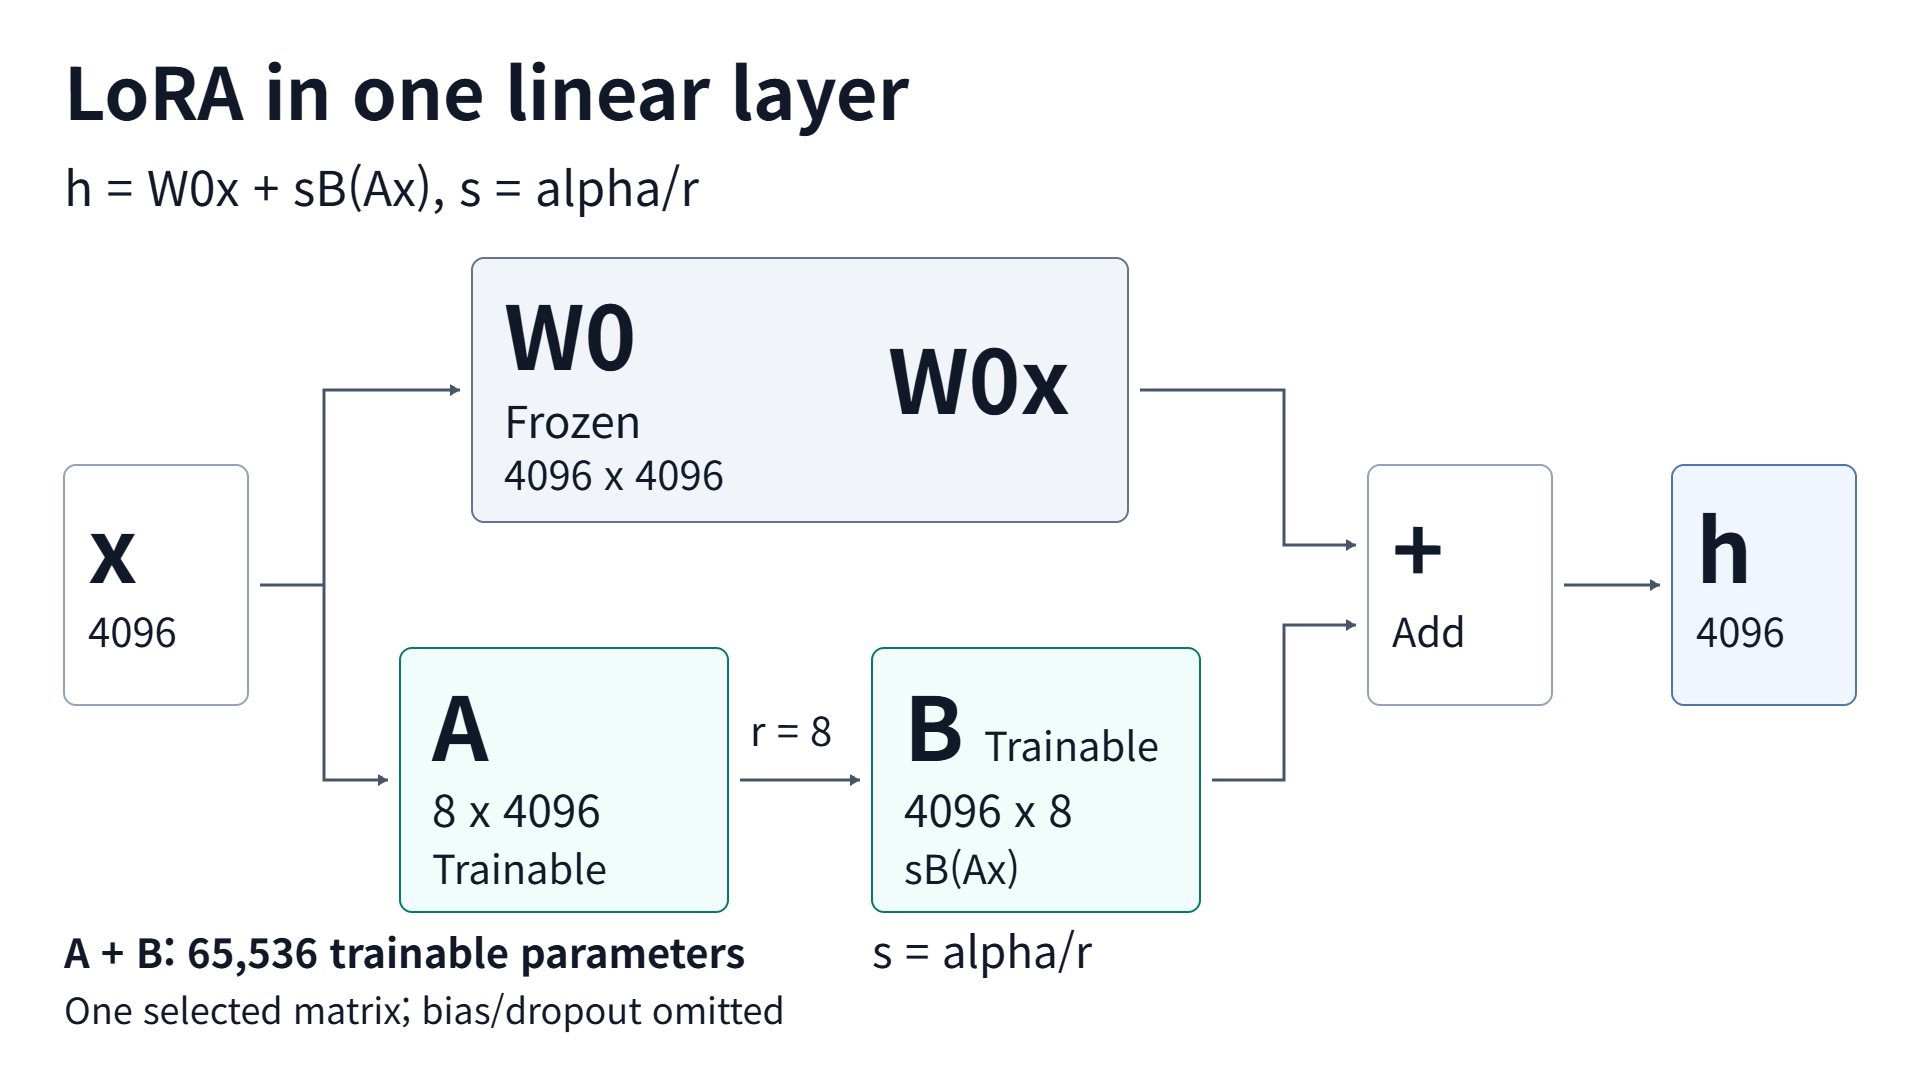
학습에서는 정답과 출력의 차이를 줄이도록 \(A\)와 \(B\)를 조정하고, \(W_0\)에는 gradient update를 적용하지 않습니다. 원래 가중치 중 일부를 무작위로 골라 학습하는 방식도 아닙니다. LoRA가 학습하는 대상은 선택한 가중치 행렬에 추가한 보정 경로입니다. bias나 출력 헤드까지 학습할지는 별도 설정이므로, 실제 학습 파라미터 목록은 함께 확인해야 합니다.
기본 선형층 LoRA는 보통 \(A\)를 무작위 값으로, \(B\)를 0으로 초기화합니다. 처음에는 \(BA = 0\)이므로 보정량도 0입니다. 원논문은 \(A\)에 Gaussian 초기화를 사용하고, 확인한 Microsoft 공식 Linear 구현은 Kaiming-uniform 초기화를 사용합니다. 이 초기화를 모든 레이어와 LoRA 변형의 공통 규칙으로 볼 수는 없습니다.
3. rank는 보정량의 표현 폭을 제한합니다
학습이 끝난 보정 행렬은 \(\Delta W = sBA\)로 표현할 수 있습니다. rank는 행렬이 표현할 수 있는 독립적인 방향의 수로 생각할 수 있습니다. \(A\)와 \(B\) 사이의 폭이 \(r\)이므로, 두 행렬을 곱한 \(BA\)의 rank는 \(r\) 이하입니다. 학습 결과에 따라 그보다 작을 수도 있습니다.
이 제약은 보정량에 걸립니다. 기본 가중치나 병합한 전체 가중치의 rank를 \(r\)로 만드는 것은 아닙니다. 기존 \(W_0\)를 SVD로 분해해서 작은 행렬로 대체하는 설명과도 다릅니다. LoRA는 기본 행렬을 그대로 두고, 새로 학습할 변화에 저랭크 제약을 둡니다.
3.1. 4096 x 4096 행렬 한 개를 계산하면
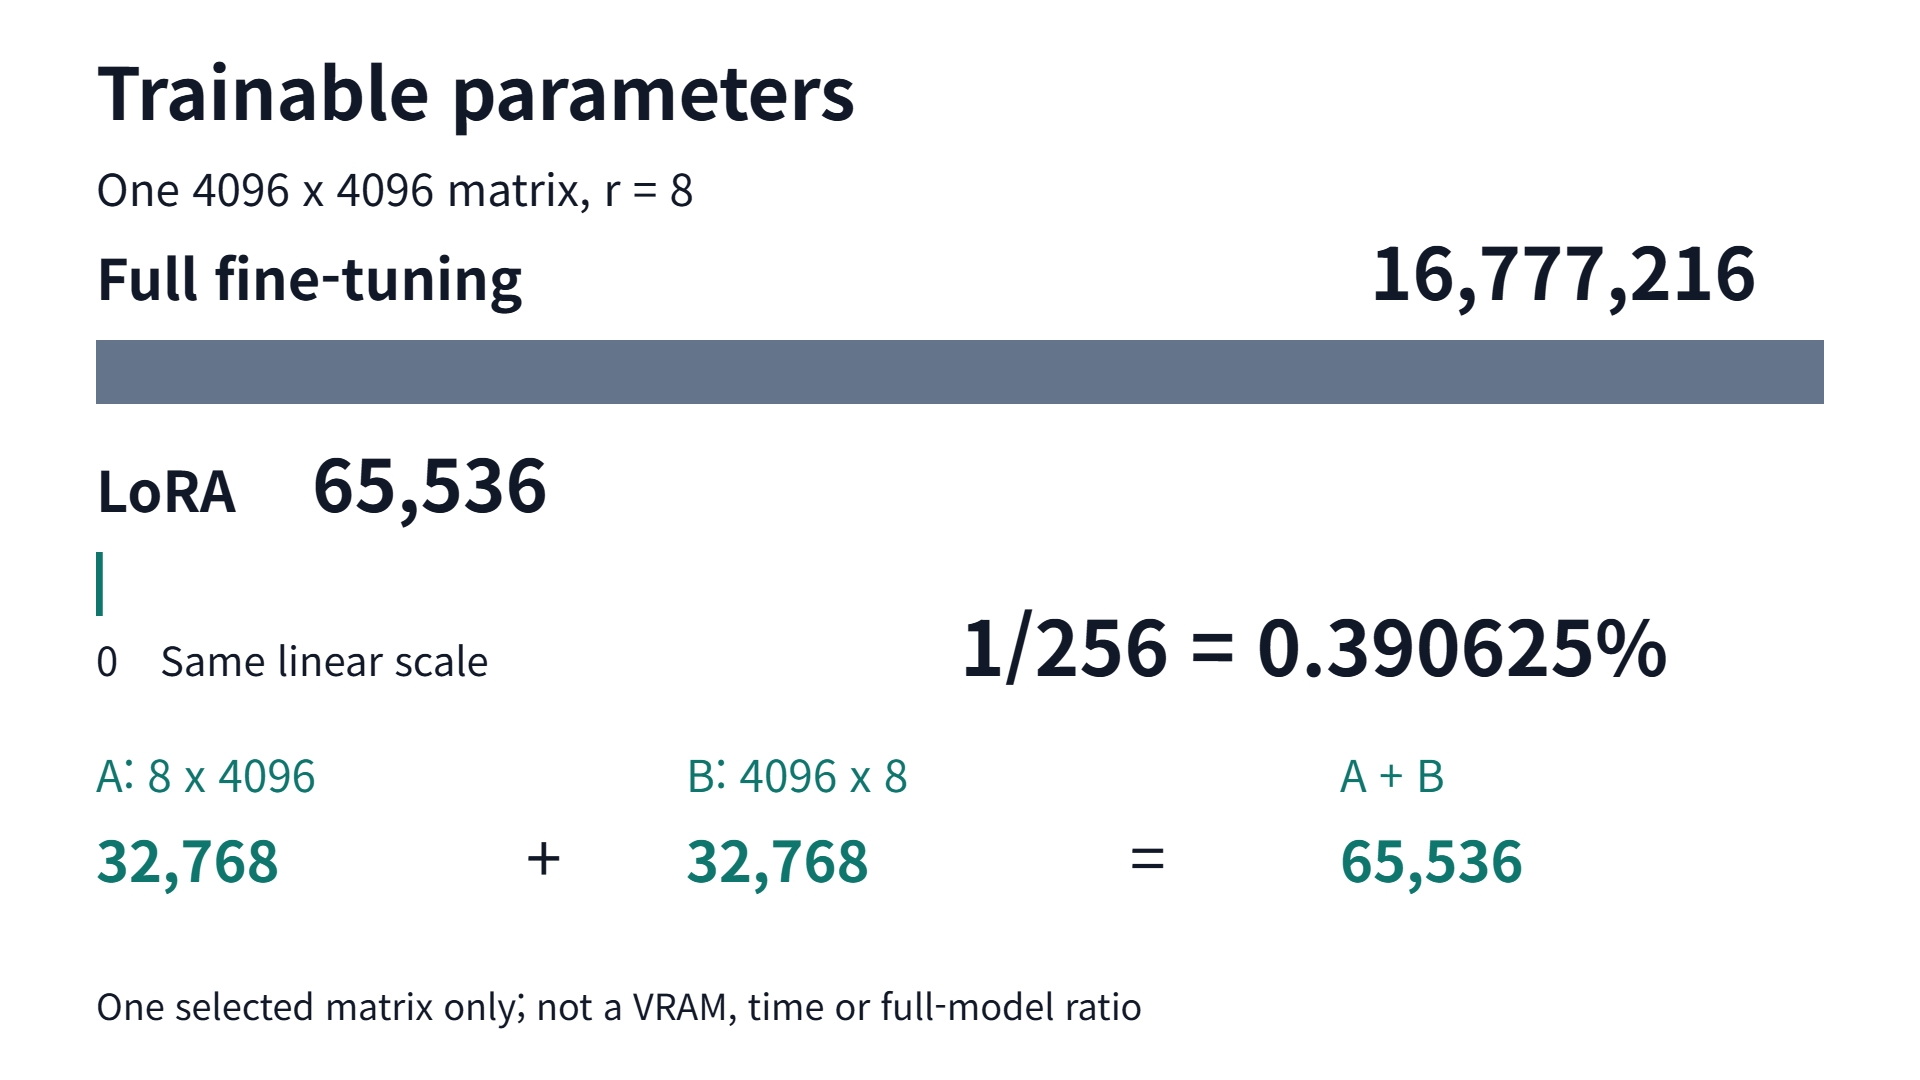
입력과 출력 차원이 모두 4096인 행렬 한 개를 가정하겠습니다. 전체 행렬을 학습하면 파라미터는 \(4096 \times 4096 = 16,777,216\)개입니다. 여기에 rank 8인 LoRA를 적용하면 \(A\)는 8 x 4096, \(B\)는 4096 x 8입니다.
일반적으로 이 두 행렬의 파라미터 수는 다음과 같습니다. bias 등 다른 학습 파라미터는 포함하지 않은 계산입니다.
\[\begin{aligned} N_{\mathrm{LoRA}} &= r d_{in} + d_{out}r \\ &= r(d_{in} + d_{out}) \end{aligned}\]One 4096 x 4096 matrix, r = 8
Full fine-tuning
16,777,216
LoRA
65,536
0
Same linear scale
1/256 = 0.390625%
A: 8 x 4096
32,768
+
B: 4096 x 8
32,768
=
A + B
65,536
One selected matrix only; not a VRAM, time or full-model ratio
아래 코드는 Python 표준 라이브러리만으로 실행할 수 있습니다. 행렬을 메모리에 만들거나 모델을 불러오지 않고, 파라미터 개수와 비율만 계산합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
from fractions import Fraction

d_in = d_out = 4096
r = 8

full = d_out * d_in
lora = r * d_in + d_out * r
ratio = Fraction(lora, full)

print(f"full parameters: {full:,}")
print(f"LoRA parameters: {lora:,}")
print(f"ratio: {ratio}")
print(f"percent: {float(ratio * 100):.6f}%")
실행 결과는 다음과 같습니다.
1
2
3
4
full parameters: 16,777,216
LoRA parameters: 65,536
ratio: 1/256
percent: 0.390625%
이 예제에서는 65,536개의 파라미터로 보정량을 표현합니다. 하지만 0.390625%는 선택한 행렬 한 개의 학습 파라미터 비율이며, LLM 전체의 VRAM이나 학습 시간 비율이 아닙니다. 모델에는 많은 가중치 행렬이 있고, 어느 행렬에 LoRA를 붙일지도 선택해야 합니다.
Transformer에서는 attention의 query나 value projection 등을 대상으로 선택합니다. 적용할 행렬을 늘리면 총 파라미터도 늘어나므로, 같은 rank라도 적용 위치를 함께 봐야 합니다.
rank를 키우면 보정량을 표현할 여지는 커지지만 학습 파라미터도 증가합니다. 그렇다고 rank 8이 모든 작업에 충분하거나, 더 큰 rank가 항상 더 좋은 답을 만든다고 할 수는 없습니다. 기본 모델, 적용층, 학습 데이터에 맞춰 학습에 쓰지 않은 평가 데이터로 비교해야 합니다.
4. 작은 어댑터와 필요한 기본 모델은 별개입니다
LoRA는 고정된 기본 가중치의 gradient와 optimizer state를 관리하는 부담을 줄일 수 있습니다. 그렇지만 기본 모델을 통과하는 계산은 계속 필요합니다. frozen은 가중치를 업데이트하지 않는다는 뜻이지, 그 경로의 계산과 메모리를 모두 없앤다는 뜻은 아닙니다.
| 메모리 구성 | LoRA를 적용했을 때 |
|---|---|
| 기본 가중치 | 여전히 필요. LoRA 자체로 저장 정밀도를 낮추지 않음 |
| 기본 가중치의 gradient, optimizer state | 고정한 파라미터에 대해서는 유지할 필요가 없음 |
| A와 B의 가중치, gradient, optimizer state | 학습을 위해 필요 |
| activation과 임시 버퍼 | 계산을 위해 여전히 필요. batch와 sequence 길이 등에 영향받음 |
따라서 GPU 용량을 정할 때는 기본 가중치의 dtype, 입력 길이, batch 크기와 학습 설정을 함께 봐야 합니다. 학습 파라미터가 작아졌다는 사실만으로 전체 메모리 사용량이나 학습 속도를 산정할 수는 없습니다.
4.1. 추론에서는 두 경로를 병합할 수 있습니다
dropout을 끈 선형 계산에서는 분배법칙으로 다음 관계가 성립합니다.
\[\begin{aligned} W_{\mathrm{merge}} &= W_0 + sBA \\ h &= W_{\mathrm{merge}}x \end{aligned}\]즉, 보정량을 미리 계산해서 가중치에 합치면 추론 때 별도의 \(A\), \(B\) 경로를 계산하지 않을 수 있습니다. 원논문의 추가 추론 지연이 없다는 설명은 이 병합 가능한 구조에 근거합니다. 미병합 상태나 여러 어댑터를 함께 사용하는 모든 서빙에서 추가 지연이 0이라는 보장은 아닙니다.
작은 행렬에서도 이 관계를 확인할 수 있습니다. 4 x 4 단위행렬을 기본 가중치로 두고, 아래 값으로 rank 1 보정량을 더하는 계산을 실행했습니다. 각 내부 리스트는 행 하나를 나타내므로 \(B\)와 \(x\)는 4 x 1 열벡터입니다.
1
2
3
4
5
W0 = 4 x 4 identity matrix
A = [[1, 2, -1, 1]]
B = [[1], [0], [-1], [2]]
x = [[1], [2], [-1], [3]]
r = 1, alpha = 2, s = 2
이때 \(Ax = 9\)이며, 두 경로를 더한 출력은 \(h = [19, 2, -19, 39]^T\)입니다. Python 표준 라이브러리의 Fraction으로 유리수를 정확히 계산해서 다음 결과도 확인했습니다.
| 확인 항목 | 결과 |
|---|---|
| 기본 행렬의 rank | 4 |
| 더한 보정량의 rank | 1 |
| 병합한 행렬의 rank | 4 |
| 별도 경로와 병합 경로의 출력 | 동일 |
| 계산에 사용한 원본 행렬 | 변경 없음 |
| B를 0으로 둔 초기 보정량 | 0 |
이는 직접 정한 행렬의 대수 관계를 확인한 예제입니다. 실제 LLM을 학습한 결과나 품질, VRAM, 학습 속도, 추론 지연의 측정값은 아닙니다. 실제 부동소수점 구현에서는 연산 순서와 dtype에 따라 반올림 차이가 날 수 있으므로, 두 경로가 비트 단위까지 항상 같다고 해석하면 안 됩니다.
4.2. 어댑터 파일만으로는 모델이 완성되지 않습니다
PEFT checkpoint 문서에 따르면 adapter-only checkpoint에는 기본 가중치가 포함되지 않습니다. 이 파일을 사용할 때는 대응하는 기본 모델과 어댑터 설정이 함께 필요합니다. 기본 가중치까지 저장한 병합 모델은 작은 어댑터 파일보다 큽니다.
병합이 원본 checkpoint 보존까지 자동으로 보장하는 것도 아닙니다. 구현에 따라 메모리에 올라간 serving용 가중치에 보정량을 직접 더할 수 있습니다. 원본 checkpoint와 병합 산출물을 구분해서 관리하는 편이 안전합니다. PEFT의 merge_and_unload()는 병합한 일반 모델을 반환하므로, 이후에는 해당 객체에서 어댑터 교체나 비활성화 같은 PEFT 기능을 사용할 수 없습니다. 특정 설정에서는 병합 자체가 지원되지 않을 수도 있습니다.
배포할 때는 기본 모델과 어댑터의 revision, tokenizer, 적용층과 rank, dtype, 라이브러리와 학습 데이터 버전을 함께 기록하는 것을 권합니다. 기본 모델과 설정이 맞아야 동작을 재현할 수 있습니다. 라이브러리가 이 정보를 자동으로 모두 고정해 준다는 뜻은 아닙니다.
5. QLoRA는 기본 가중치의 저장 메모리도 줄입니다
LoRA의 작은 어댑터만으로 기본 가중치 메모리까지 작아지지는 않습니다. QLoRA 원논문은 고정한 기본 모델을 4-bit로 양자화해서 저장하고, 그 모델을 통해 LoRA를 학습하는 방법을 제안합니다. 양자화는 가중치 값을 더 적은 비트로 표현하는 과정입니다.
여기서 저장 형식과 계산 형식을 구분해야 합니다. 원논문은 기본 가중치 저장에 NF4(4-bit NormalFloat)를 사용하고, 계산할 때는 BF16(BFloat16)으로 역양자화해서 행렬 곱을 수행하는 방식을 설명합니다. 4-bit 모델을 사용한다는 말은 모든 연산, gradient와 optimizer state가 4-bit라는 뜻이 아닙니다.
원논문에서 함께 제시하는 구성도 서로 다른 부분을 다룹니다.
| 구성 | 줄이거나 관리하는 대상 |
|---|---|
| NF4 | 정규분포를 가정한 4-bit 가중치 표현 |
| Double quantization | 양자화에 사용하는 상수까지 추가로 양자화해 저장 부담 절감 |
| Paged optimizer | optimizer state를 CPU와 GPU 사이에서 paging해 메모리 급증에 대응 |
이 구성을 써도 긴 입력이나 큰 batch가 요구하는 activation 메모리가 없어지지는 않습니다. 논문에서 보고한 650억 파라미터의 65B 모델과 48GB GPU 한 장이라는 수치도 해당 실험 설정의 결과입니다. 개인 장비에서 같은 크기의 모델을 학습할 수 있다는 용량 견적으로 쓰면 안 됩니다. 논문의 한계 절은 33B와 65B 규모에서 full 16-bit fine-tuning과의 성능 동등성을 입증하지 못했다고 명시합니다.
양자화한 가중치와 병합을 함께 쓸 때도 주의가 필요합니다. PEFT 양자화 문서는 지원되는 방식에서 역양자화, 보정량 추가, 재양자화를 거칠 수 있다고 설명합니다. 이 과정에서는 반올림 오차가 생길 수 있고, 반복 병합과 해제로 원래 양자화 가중치가 정확히 복원된다고 가정할 수 없습니다. 원본이 필요하면 보존한 기본 모델을 다시 불러와야 합니다.
6. Prompt, RAG, LoRA는 해결하는 문제가 다릅니다
출력 형식이 마음에 들지 않는다는 이유만으로 바로 학습부터 시작할 필요는 없습니다. 먼저 명확한 prompt와 몇 개의 예시로 기준선을 만들 수 있습니다. JSON 같은 고정 형식이 필요하다면 schema 검증도 함께 두는 편이 좋습니다. 지시와 검증만으로 요구를 만족하면 학습 데이터와 어댑터를 관리할 부담을 추가하지 않아도 됩니다.
반면 검수된 예제가 충분하고, 같은 분류 기준이나 응답 패턴을 반복해서 따르게 하려면 LoRA를 후보로 비교할 수 있습니다. 예를 들어 합성 운영 보고서를 일정한 항목으로 정리하거나, 공개 문서를 정해진 범주로 분류하는 작업입니다. 학습 예제를 잘 따라 하는 것과 처음 보는 입력에도 기준을 적용하는 것은 다르므로, 평가 데이터는 분리해야 합니다.
최신 문서의 사실과 원문 근거가 필요하다면 RAG의 검색 경로를 먼저 생각해야 합니다. RAG 원논문은 외부 자료를 검색해서 생성에 사용하는 구조를 제시합니다. LoRA도 사실을 학습할 수 있지만, 연결하지 않은 최신 문서를 자동으로 읽는 검색 DB는 아닙니다. 최신 근거를 가져오는 문제와 응답 방식을 학습하는 문제를 나눠서 판단해야 합니다.
다음은 성능 측정 결과가 아니라, 설계를 시작할 때 사용할 수 있는 판단 기준입니다.
| 요구 | 먼저 검토할 접근 |
|---|---|
| 지시와 예시로 충분한 출력 형식 | Prompt와 schema 검증 |
| 반복되는 분류나 응답 패턴, 검수된 학습 예제 | LoRA와 학습에 쓰지 않은 데이터 평가 |
| 기본 가중치 메모리가 학습의 병목 | QLoRA와 실제 환경의 메모리 측정 |
| 자주 바뀌는 문서와 원문 근거 | 자료를 갱신하는 RAG |
| 검색한 근거를 일정한 형식으로 정리 | RAG와 Prompt를 우선 적용하고 필요하면 LoRA 결합 |
RAG와 LoRA는 함께 사용할 수 있습니다. 또한 RAG가 정의상 학습이 없는 구조인 것도 아닙니다. 원논문은 검색기와 생성기를 함께 학습하는 구성도 다룹니다. 검색 자료가 오래됐거나 관련 문서를 찾지 못하면 답변도 영향을 받으므로, 검색 품질과 근거 반영 여부는 별도로 평가해야 합니다.
학습 결과는 prompt 기준선과 같은 평가 데이터로 비교하는 편이 좋습니다. 보고서의 필수 항목과 형식 준수, 분류의 정답 일치 여부 등을 확인할 수 있습니다. 학습에 없던 표현이나 근거가 부족한 입력도 평가해야 합니다.
보안 경계도 별도로 유지해야 합니다. Transformers 보안 정책은 safetensors 사용, remote code 검토와 revision 고정을 권고합니다. 이는 모델 파일과 코드의 공급망 위험을 다루는 조치입니다. LoRA 자체가 학습 데이터의 개인정보 보호, 모델과 데이터의 이용권, 문서 접근 권한이나 도구 실행 권한을 보장하지는 않습니다.
LoRA를 선택할 근거는 바꾸려는 응답과 평가 결과에 있어야 합니다. 작은 어댑터라는 사실만으로 품질이나 비용 이점을 확정할 수는 없습니다.
7. Reference
- LoRA 원논문 v2 - 저랭크 업데이트와 병합
- Microsoft LoRA - commit 고정 Linear 구현
- QLoRA 원논문 v1 - NF4 저장과 BF16 계산, 실험의 한계
- Hugging Face PEFT - commit 고정 checkpoint 형식과 병합 제약
- Hugging Face PEFT - commit 고정 양자화와 병합 주의사항
- RAG 원논문 v4 - 외부 자료 검색과 생성의 결합
- Hugging Face Transformers - commit 고정 보안 정책
궁금하신 점이나 추가해야 할 부분은 댓글이나 아래의 링크를 통해 문의해주세요.
Written with KKamJi