데이터 웨어하우스 vs 데이터 레이크 vs 레이크하우스
웨어하우스, 데이터 레이크, 레이크하우스를 스키마 적용 시점과 트랜잭션, 거버넌스 관점에서 비교합니다. AWS 서비스 구성을 대응시키고 워크로드에 따른 선택 기준을 정리합니다.
S3에 로그를 쌓아 두고 Athena로 조회하는 구성은 보통 데이터 레이크라고 부릅니다. 같은 버킷에 Iceberg 테이블을 만들면 레이크하우스가 되고, 같은 데이터를 Redshift에 적재하면 웨어하우스가 됩니다. 세 구성 모두 데이터를 모아 SQL로 분석하지만, 스키마를 언제 적용하는지와 트랜잭션을 무엇이 보장하는지가 다릅니다. 세 패러다임이 어떤 순서와 배경으로 등장했는지는 데이터 분석 아키텍처의 역사에 정리했습니다.
TL;DR
- Data Warehouse: 적재 전에 스키마를 강제하는(schema-on-write) 정형 데이터 저장소. 쿼리 성능과 거버넌스가 강하고, 스키마 변경이 경직적이다.
- Data Lake: 원본을 그대로 담고 읽을 때 스키마를 적용하는(schema-on-read) 저비용 저장소. 관리하지 않으면 “데이터 늪”이 된다.
- Data Lakehouse: 레이크 스토리지 위에 테이블 포맷(Iceberg/Delta/Hudi)으로 ACID와 스키마 관리를 얹고, 카탈로그로 권한을 관리하는 구조.
- AWS 매핑: Warehouse=Redshift, Lake=S3+Glue+Athena, Lakehouse=S3 Tables+Athena+Lake Formation.
세 패러다임의 경계는 스키마를 적용하는 시점과 storage layer의 transaction 지원입니다.
스토리지 비용과 스키마 변경의 경직성이 trade-off입니다.
파일 자체에는 ACID transaction과 강한 governance가 없습니다.
새 storage engine이 아니라 Apache Iceberg table format이 기능을 제공합니다.
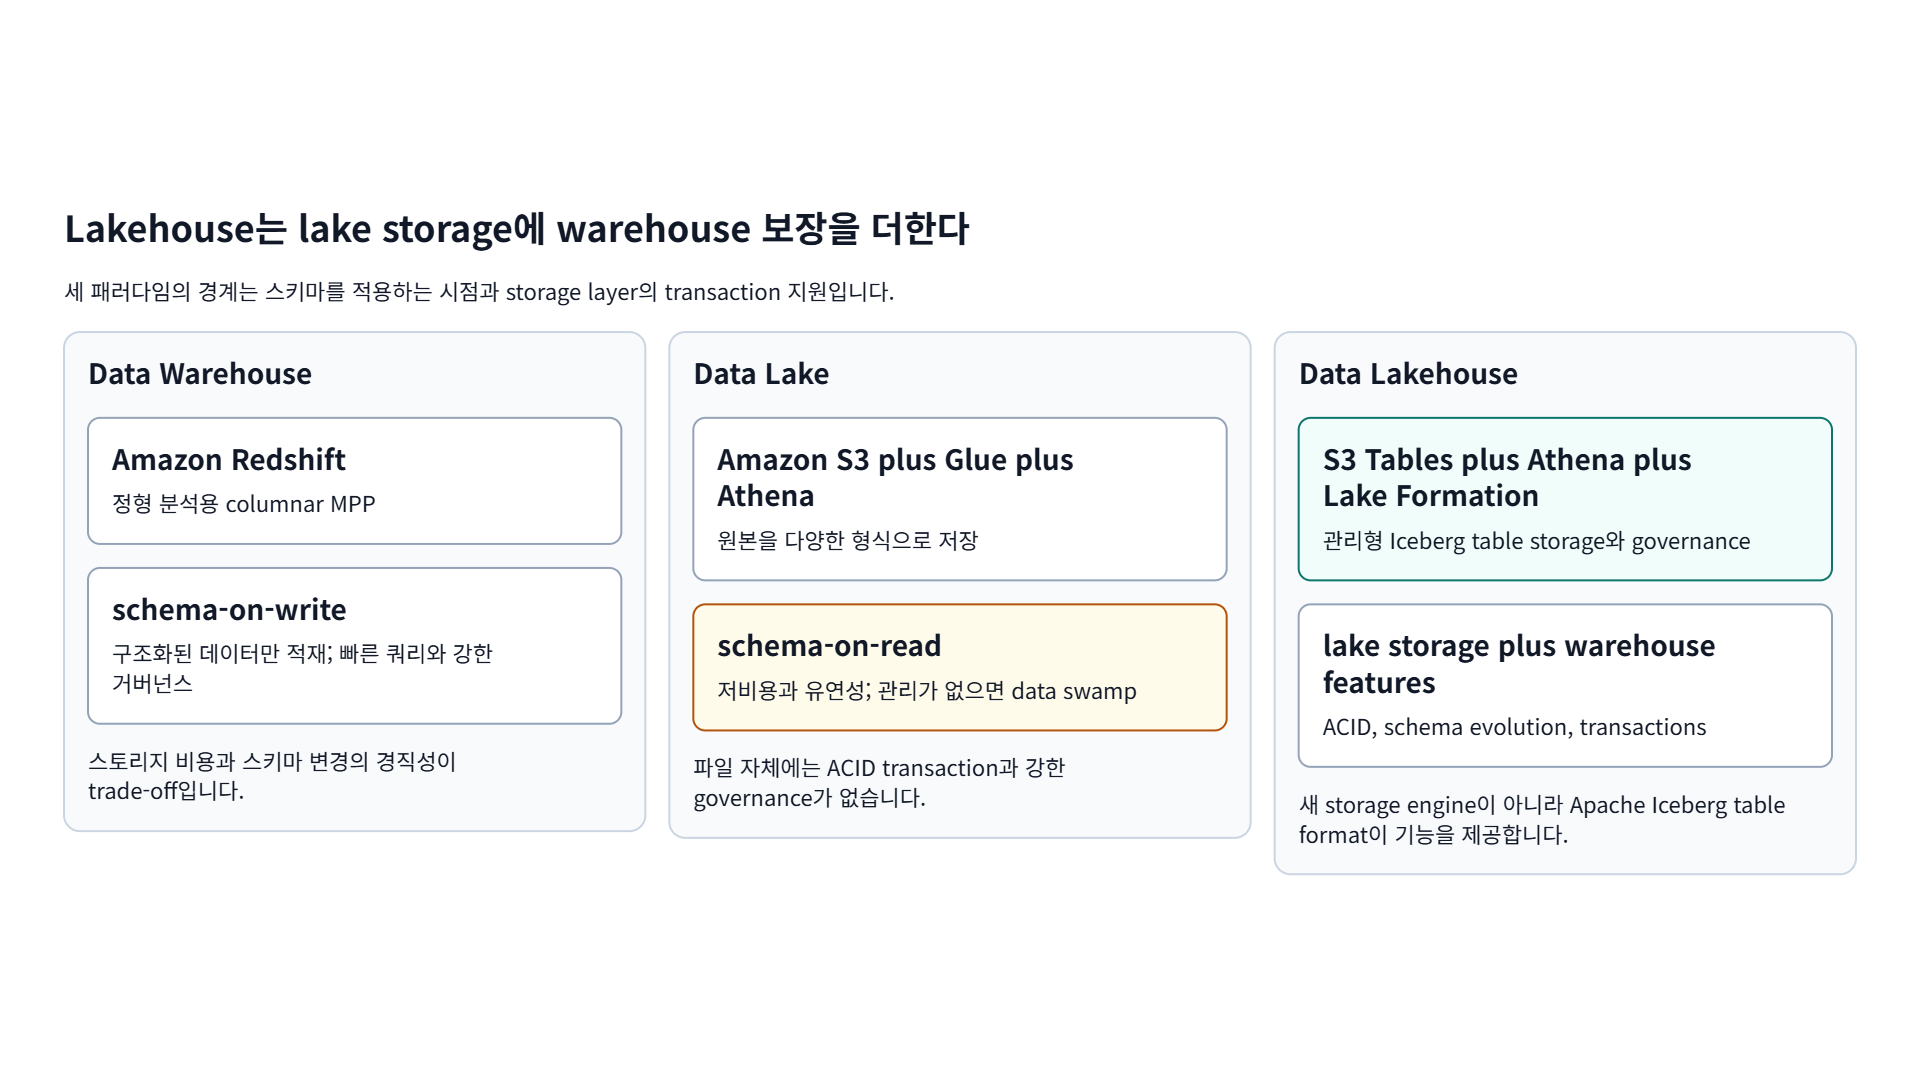
세 패러다임의 스키마 적용 시점(schema-on-write vs schema-on-read), 데이터 형식, 트랜잭션 지원과 AWS 서비스 매핑 비교
1. 데이터를 한곳에 모으는 이유
서비스 데이터는 보통 여러 운영 데이터베이스와 로그, 외부 소스에 흩어져 있습니다. 분석이나 리포팅을 하려면 이 데이터를 한곳에 모아 일관된 방식으로 조회할 수 있어야 합니다. 운영 DB에 직접 분석 쿼리를 던지면 서비스 트래픽에 영향을 주고, 소스마다 형식이 달라 조인도 어렵습니다.
1.1. OLTP와 OLAP는 다르다
이 차이의 바탕에는 두 종류의 워크로드가 있습니다.
- OLTP(Online Transaction Processing): 주문 생성, 회원 가입처럼 짧고 잦은 트랜잭션. 행 단위로 적은 데이터를 빠르게 읽고 쓴다. 운영 DB(MySQL, PostgreSQL 등)가 여기에 해당한다.
- OLAP(Online Analytical Processing): 기간별 매출 집계, 코호트 분석처럼 많은 행을 스캔해 집계하는 쿼리. 필요한 컬럼만 대량으로 읽는다.
운영 DB는 OLTP에 맞게 데이터를 행 단위로 저장합니다. 그래서 컬럼 몇 개만 필요한 집계 쿼리도 행 전체를 읽게 되고, 이런 쿼리를 운영 DB에서 돌리면 느릴 뿐 아니라 서비스 트래픽과 같은 자원을 나눠 씁니다. 분석용 데이터를 따로 모아 OLAP에 맞게 저장하는 저장소가 필요한 이유입니다.
이 저장소를 어떤 형태로 구성하느냐가 세 패러다임을 가르는 출발점입니다. 정제된 정형 데이터만 담을지, 원본을 그대로 담을지, 둘의 장점을 합칠지에 따라 웨어하우스, 레이크, 레이크하우스로 나뉩니다.
2. Data Warehouse - 정형 데이터의 분석 본진
데이터 웨어하우스는 가장 오래된 패러다임으로, 정형 데이터(structured data) 를 분석에 최적화된 형태로 저장합니다. 1990년대 Inmon과 Kimball의 방법론으로 정립됐고, 여러 운영 시스템의 데이터를 통합해 주제별로 정리한 “단일 진실 공급원(single source of truth)”을 목표로 합니다.
2.1. schema-on-write
웨어하우스의 핵심 특성은 schema-on-write입니다. 데이터를 적재하기 전에 스키마(테이블 구조, 타입)를 먼저 정의하고, ETL(Extract-Transform-Load) 과정에서 데이터를 그 스키마에 맞게 정제한 뒤 적재합니다. 저장 시점에 이미 정돈된 상태가 됩니다.
1
2
운영 DB / 로그 -> [Extract] -> [Transform: 정제/정규화] -> [Load] -> Warehouse
                                  (스키마를 여기서 강제)
이 덕분에 조회가 빠르고 예측 가능합니다. 대부분의 웨어하우스는 컬럼형(columnar) 저장과 MPP(Massively Parallel Processing) 를 사용해, 많은 행을 스캔하는 집계 쿼리를 여러 노드로 분산 처리합니다. 분석에서 자주 쓰는 star schema(사실 테이블 + 차원 테이블) 같은 모델링도 정형 스키마 위에서 잘 동작하고, BI 도구로 대시보드와 리포트를 만들기에 적합합니다.
대표적인 제품으로 Amazon Redshift, Snowflake, Google BigQuery 등이 있습니다.
2.2. 장단점
| 항목 | 내용 |
|---|---|
| 강점 | 빠른 쿼리 성능, 강한 거버넌스, BI/리포팅 최적 |
| 약점 | 정형 데이터에 한정, 스키마 변경이 경직적, 전용 저장 포맷 |
비정형 데이터(로그 원본, 이미지, JSON 덩어리)를 그대로 담기 어렵고, 스키마를 먼저 확정해야 하므로 새로운 데이터 소스를 빠르게 실험하기에는 부담이 있습니다.
“스토리지 비용이 높다”는 전통적인 약점은 클라우드 웨어하우스에서 많이 줄었습니다. Redshift RA3, Snowflake, BigQuery는 스토리지와 컴퓨트를 분리하고 데이터를 객체 스토리지 기반의 관리형 스토리지에 둡니다. 지금 남는 차이는 비용보다 포맷입니다. 기본 저장 포맷이 웨어하우스 전용이라 다른 엔진이 같은 데이터를 직접 읽기 어렵습니다.
3. Data Lake - 원본 그대로 적재
데이터 레이크는 웨어하우스의 경직성을 풀기 위해 2010년 전후 Hadoop 흐름과 함께 등장했습니다. 형식을 가리지 않고 원본 그대로 저장합니다. 정형 데이터뿐 아니라 로그, JSON, 이미지 같은 반정형/비정형 데이터까지 한곳에 담습니다.
3.1. schema-on-read
레이크의 핵심 특성은 schema-on-read입니다. 데이터를 적재할 때는 스키마를 강제하지 않고 원본(CSV, JSON, Parquet, 로그 등)을 그대로 저장합니다. 스키마는 읽는 시점에 적용합니다. 예를 들어 S3에 쌓인 파일에 Glue Data Catalog로 테이블 정의를 입혀 Athena로 조회하는 방식이 schema-on-read입니다.
1
2
운영 DB / 로그 -> [Extract] -> [Load: 원본 그대로] -> Lake (S3)
                                                       -> [Transform: 읽을 때 스키마 적용]
레이크는 적재 단계에서 변환하지 않으므로 보통 ELT(Extract-Load-Transform) 흐름을 따릅니다. 일단 저렴하게 담아 두고, 분석할 때 구조를 부여하거나 정제 테이블을 따로 만듭니다. 다만 ETL과 ELT가 웨어하우스와 레이크를 가르는 기준은 아닙니다. 클라우드 웨어하우스에서도 원본을 먼저 적재한 뒤 SQL로 변환하는 ELT가 흔합니다. 저장은 보통 S3 같은 객체 스토리지에 두고, 분석용 데이터는 Parquet/ORC 같은 컬럼형 파일로 둡니다.
3.2. 장단점 - 데이터 늪 주의
| 항목 | 내용 |
|---|---|
| 강점 | 저비용 스토리지, 형식 무관, 유연한 적재 |
| 약점 | 거버넌스/품질 관리가 약함, 트랜잭션 부재 |
레이크의 약점은 관리가 없으면 통제가 빠르게 무너진다는 점입니다. 무엇이 어디에 있는지, 어떤 데이터가 믿을 만한지 추적되지 않으면, 데이터가 쌓이기만 하고 쓸 수 없는 데이터 늪(data swamp) 이 됩니다.
파일 더미 위에서는 “진짜 테이블” 기능도 어렵습니다. Athena가 S3 prefix를 읽는 도중 다른 작업이 같은 prefix의 파일을 덮어쓰면, 쿼리는 일부만 바뀐 상태를 읽을 수 있습니다. 행 하나를 고치려면 그 행이 든 파일 전체를 다시 써야 합니다. 어떤 파일 묶음이 한 시점의 테이블인지 기록하는 계층이 없기 때문입니다.
4. Data Lakehouse - 레이크 위에 웨어하우스 기능
레이크하우스는 이름 그대로 레이크(lake)와 웨어하우스(house)의 결합입니다. 레이크의 저렴하고 유연한 저장 방식을 유지하면서, 웨어하우스가 제공하던 기능(ACID 트랜잭션, 스키마 관리, 빠른 SQL)을 그 위에 얹습니다. 레이크와 웨어하우스를 따로 운영하며 같은 데이터를 두 벌 복제하던 부담을 줄이려는 흐름에서 나왔습니다.
4.1. 테이블 포맷이 핵심
이 결합을 가능하게 하는 것이 테이블 포맷(table format) 입니다. Apache Iceberg, Delta Lake, Apache Hudi 같은 포맷은 S3 같은 객체 스토리지 위에 메타데이터 계층을 얹어, 파일 더미를 “진짜 테이블”처럼 다루게 해 줍니다.
테이블 포맷은 데이터 파일을 그대로 두고, 어떤 파일들이 한 시점의 테이블을 이루는지를 메타데이터(Iceberg는 snapshot과 manifest, Delta Lake는 트랜잭션 로그)에 기록합니다. 쓰기 작업은 새 파일을 만든 뒤 메타데이터를 원자적으로 교체하는 방식으로 커밋합니다. 그래서 읽는 쪽은 항상 완성된 snapshot 하나만 봅니다. 3.2절의 “일부만 바뀐 상태”가 생기지 않는 이유입니다.
테이블 포맷이 제공하는 대표 기능은 다음과 같습니다.
- ACID 트랜잭션: 동시 쓰기 충돌 없이 일관된 읽기/쓰기
- 스키마 관리: 쓰기 시 테이블 스키마 검증, 기존 데이터를 다시 쓰지 않는 컬럼 추가/삭제(스키마 진화)
- 시간여행(time travel): 과거 snapshot 조회
- 부분 수정: 행 단위 update/delete
4.2. 거버넌스는 카탈로그가 맡는다
테이블 포맷이 주는 것은 트랜잭션과 스키마 관리입니다. 누가 어떤 테이블과 컬럼을 읽을 수 있는지는 테이블 포맷이 정하지 않습니다. 이 역할은 테이블 목록과 권한을 관리하는 카탈로그 계층이 맡습니다. AWS에서는 Glue Data Catalog와 Lake Formation이, Databricks에서는 Unity Catalog가 이 자리에 있습니다.
테이블 포맷만 도입하고 카탈로그 권한을 정리하지 않으면, 트랜잭션은 생겨도 레이크의 거버넌스 문제는 그대로 남습니다. 사용자가 IAM 권한으로 S3 파일을 직접 읽을 수 있으면 카탈로그에 걸어 둔 테이블, 컬럼 권한도 우회됩니다. 레이크하우스의 거버넌스는 카탈로그 권한과 스토리지 직접 접근 차단을 함께 갖췄을 때 성립합니다.
4.3. 무엇을 해결하나
레이크하우스는 “싸고 유연하지만 통제가 어려운” 레이크의 약점과 “통제는 강하지만 경직적이고 전용 포맷에 묶인” 웨어하우스의 약점을 동시에 줄이려는 시도입니다. 데이터는 개방형 포맷으로 객체 스토리지에 그대로 두되, 그 위에서 정형 데이터베이스처럼 트랜잭션과 스키마를 보장받습니다. 데이터를 웨어하우스로 따로 옮기지 않고도 신뢰할 수 있는 분석을 할 수 있다는 것이 핵심입니다.
개방형 포맷(open format) 이라는 점도 중요합니다. Iceberg 같은 테이블 포맷은 특정 엔진에 묶이지 않으므로, 같은 데이터를 Athena, Spark, Trino, Redshift 등 여러 엔진이 함께 읽을 수 있습니다. 데이터를 한 벤더의 독점 포맷에 가두지 않아 lock-in을 줄입니다.
5. 한눈에 비교
| 항목 | Data Warehouse | Data Lake | Data Lakehouse |
|---|---|---|---|
| 스키마 시점 | schema-on-write | schema-on-read | 쓰기 시 테이블 스키마 검증, 스키마 진화 |
| 데이터 형식 | 정형 | 정형/반정형/비정형 | 정형/반정형/비정형 |
| 저장 포맷 | 웨어하우스 전용 | 개방형 파일 | 개방형 파일 + 테이블 메타데이터 |
| 변환 순서 | 주로 ETL, 클라우드에서는 ELT도 흔함 | ELT | ELT |
| 트랜잭션 | 있음 | 없음1 | 있음(테이블 포맷) |
| 거버넌스 | 강함 | 약함 | 카탈로그로 확보(Lake Formation, Unity Catalog) |
| 스토리지 비용 | 상대적으로 높음 | 낮음 | 낮음 |
| 쿼리 성능 | 높음 | 보통 | 높음(파일 레이아웃과 엔진에 좌우) |
| 대표 용도 | BI/리포팅 | 원본 적재/탐색 | 통합 분석 |
6. AWS 매핑
| 패러다임 | AWS 구현 | 비고 |
|---|---|---|
| Data Warehouse | Amazon Redshift | 컬럼형 MPP 웨어하우스, 정형 분석 |
| Data Lake | Amazon S3 + AWS Glue + Amazon Athena | S3=저장, Glue=메타데이터, Athena=쿼리 |
| Data Lakehouse | Amazon S3 Tables + Athena + AWS Lake Formation | S3 Tables=관리형 Iceberg, LF=거버넌스 |
표의 조합은 AWS 기준의 대표적인 출발점이고, 다른 조합도 가능합니다. 웨어하우스는 Snowflake나 BigQuery로, 레이크하우스의 쿼리 엔진은 Spark, Trino, Redshift Spectrum으로 바꿀 수 있습니다. AWS 밖에서는 Databricks가 Delta Lake 테이블, Unity Catalog 거버넌스, SQL warehouse 컴퓨트를 한 플랫폼으로 묶어 레이크하우스를 제공합니다. 이 구조는 Databricks란 무엇인가에서 쿼리 하나를 따라가며 정리했습니다.
Amazon S3 Tables는 관리형 Apache Iceberg 테이블 버킷으로, compaction과 snapshot 정리 같은 테이블 유지 관리를 AWS가 대신 수행합니다. 여기에 Lake Formation이 테이블, 컬럼 단위 권한을 더하면 4.2절의 카탈로그 계층이 갖춰집니다. S3 Tables의 카탈로그 연동은 S3 Tables & Catalog Federation 알아보기에서, 권한 모델은 AWS Lake Formation 알아보기에서 다뤘습니다.
7. 언제 무엇을
세 패러다임은 서로를 완전히 대체한다기보다, 데이터의 성격과 요구에 따라 선택하거나 함께 쓰는 대상입니다.
- 정형 데이터로 BI/리포팅을 빠르게: Data Warehouse(Redshift)
- 형식이 다양한 원본을 저비용으로 모아 탐색: Data Lake(S3+Glue+Athena)
- 레이크의 유연함에 트랜잭션과 테이블 단위 권한까지: Data Lakehouse(S3 Tables+Athena+Lake Formation)
실제 환경에서는 원본을 레이크에 모으고, 자주 쓰는 정제 데이터는 레이크하우스 테이블로 관리하고, 지연 시간이 중요한 BI만 웨어하우스에 두는 혼합 구성이 많습니다. 이때 같은 데이터가 레이크하우스와 웨어하우스에 두 벌 생기면, 두 사본이 같은 숫자를 내는지 검증하는 일이 새로 생깁니다. 사본을 하나 더 만들기 전에 기존 테이블을 다른 엔진에서 직접 읽을 수 있는지 먼저 확인하는 편이 운영 부담이 적습니다.
8. Reference
- AWS - What is a Data Warehouse?
- AWS - What is a Data Lake?
- AWS - What is a Data Lakehouse?
- Amazon S3 Tables
- AWS Lake Formation - What is AWS Lake Formation?
- Apache Iceberg
- Delta Lake
- Apache Hudi
- Databricks Docs - What is a data lakehouse?
궁금하신 점이나 추가해야 할 부분은 댓글이나 아래의 링크를 통해 문의해주세요.
Written with KKamJi
트랜잭션 부재는 “Data Lake” 패러다임의 본질적 한계가 아닙니다. 객체 스토리지에 쌓인 raw 파일 묶음이 트랜잭션을 모를 뿐이고, 같은 스토리지 위에 Apache Iceberg 같은 테이블 포맷을 얹으면 ACID 트랜잭션이 생깁니다. Iceberg는 스스로를 “brings the reliability and simplicity of SQL tables to big data”라고 설명합니다. 트랜잭션 유무를 가르는 경계는 저장 위치가 아니라 테이블 포맷의 유무이며, 그 경계를 넘은 형태가 4절의 레이크하우스입니다. ↩︎