GitHub Actions Self-hosted Runner 환경 구축하기 - HomeLab Kubernetes와 ARC
HomeLab에 ARC runner를 구축해 웹과 Rust 저장소 CI를 옮긴 기록입니다. light와 rootless DinD 풀 분리, 슬롯 및 quota 제한, 캐시와 오라클 fixture 조정에 따른 run 관측을 정리합니다.
개인 저장소 두 곳의 GitHub Actions job이 시작되지 않았습니다. Hosted runner는 계정 결제 한도에 걸려 있었고, workflow는 대기열에서 움직이지 않았습니다. 저는 HomeLab Kubernetes에 Actions Runner Controller(ARC)를 설치해 GitHub Self-hosted Runner를 만들고 두 저장소의 CI를 옮겼습니다. ARC의 구성 요소와 수명주기, 실행 방식과 신뢰 경계는 GitHub Actions Runner Controller - 개념과 아키텍처에 정리했습니다.
옮긴 뒤 첫 측정에서 Rust 저장소의 gate workflow는 약 2시간이 걸렸습니다. hosted runner에서 마지막으로 성공한 gate run은 job 5개를 병렬로 실행해 23분이 걸렸습니다. 그 뒤 job과 오라클 테스트가 늘어서 두 값을 그대로 비교할 수는 없습니다.
TL;DR
- Docker가 필요 없는 제어 job은 light 풀, 빌드와 테스트는 rootless DinD를 쓰는 full 풀로 나눴다.
- full 풀은 privileged 없이 Pod user namespace, capability 3개, 전용 seccomp profile, device plugin으로 할당한 TUN 장치로 Docker를 실행한다.
- 노드마다 저장소별 크기의 슬롯을 하나씩 두고, quota에 거부된 runner를 ARC 0.15가 30초 뒤 다시 만드는 동작으로 동시 실행을 제한했다.
- 웹 저장소 main CI는 20~25분에서 약 10분이 됐다.
- Rust 저장소는 build once로 runner 점유가 10% 줄었지만, 오라클 fixture가 한 번도 녹화되지 않아 PR마다 오라클 테스트에 약 30분을 썼다. 녹화 조건을 고친 뒤 PR run 2건에서 runner 점유는 106.5분에서 54.7분, 54.8분이 됐다.
측정은 2026-10-15부터 2026-10-20까지의 실제 run 기준입니다. 아직 적용하지 않았거나 표본이 부족한 효과는 예상 또는 표본 수로 따로 표시했습니다.
1. 환경과 옮길 CI
| 항목 | 값 |
|---|---|
| HomeLab | 장비 1대, 16코어 32스레드, 메모리 64GB |
| 클러스터 | kubeadm, Kubernetes 1.36, control plane 1대와 worker 2대(VM) |
| worker | 처음 3 vCPU와 메모리 12GiB, 지금 8 vCPU와 16GiB(할당 가능 메모리 14.77GiB) |
| ARC | gha-runner-scale-set 0.15.0, 공식 chart와 digest 고정 이미지 |
| 배포 | Argo CD가 Helm chart 저장소를 GitOps로 동기화 |
옮길 CI는 성격이 다른 두 저장소입니다.
| 저장소 | CI 구성 | 특징 |
|---|---|---|
| 웹 플랫폼 | API와 검색 서버, Node 프런트엔드, 이미지 빌드와 e2e | 처음에는 Java/Gradle API였고 측정 기간 중 Rust로 바뀌었다. main merge는 이미지 게시와 배포로 이어진다 |
| Rust 퀀트 연구 | Ubuntu 26.04 컨테이너에서 Tier A/B 테스트, Python 오라클 비교, release 빌드 | 컴파일이 무겁고 bwrap sandbox 테스트가 user namespace와 새 /proc mount를 요구한다 |
오라클 테스트는 같은 입력을 Python 참조 구현(오라클)과 Rust 구현에 넣고 결과가 같은지 비교하는 테스트입니다. Tier A, Tier B, source qualification은 Rust 저장소 gate가 테스트를 나눈 묶음의 이름입니다.
Rust 저장소의 sandbox 테스트가 이 작업의 가장 큰 제약이었습니다. 기존 workflow는 hosted runner에서 호스트 sysctl을 바꾸고 컨테이너의 seccomp와 AppArmor를 끈 상태로 실행했습니다. runs-on만 바꾸거나 실패하는 sandbox 테스트를 빼는 방식은 처음부터 선택지에서 제외했습니다.
2. Runner 풀을 두 종류로 나눴습니다
모든 job이 Docker를 쓰지는 않습니다. 변경 경로를 판단하는 gate나 결과를 모으는 ci-ok 같은 job은 몇 초면 끝납니다. 그래서 runner를 두 풀로 나눴습니다.
| 풀 | namespace | 실행 환경 | 용도 |
|---|---|---|---|
| light | ci-pr | nonroot, Kubernetes token 미마운트, Docker 없음 | 제어 job, canary |
| full | ci-full | runner 컨테이너와 rootless Docker sidecar | 빌드, 테스트, 이미지 |
두 풀은 controller도 따로 둡니다. full 풀의 controller는 ci-full만 감시하고, 기존 controller는 ci-pr만 감시합니다. CRD는 기존 controller Application이 소유하고 full 쪽 Application은 CRD를 건너뜁니다.
Namespace는 default-deny NetworkPolicy로 시작했습니다. DNS, GitHub, Actions 결과 업로드 같은 목적지만 Cilium FQDN 규칙으로 열었습니다. job Pod는 Kubernetes API와 노드, 사설 대역, metadata 주소로 나갈 수 없고, controller와 listener만 API에 접근합니다. 사설 대역 예외는 나중에 클러스터 내부 registry 하나만 추가했습니다(8.4절).
3. privileged 없이 rootless DinD를 실행했습니다
공식 ARC 문서의 DinD 구성은 privileged를 요구합니다. 저는 같은 노드에 다른 서비스도 있어서 privileged를 쓰지 않기로 했고, 대신 권한을 하나씩 확인하며 필요한 만큼만 열었습니다.
3.1. Pod 구성
full runner Pod는 컨테이너 두 개로 구성됩니다.
| 역할 | 실행 사용자 | 권한 |
|---|---|---|
| runner(SDK) 컨테이너 | UID 1001 | capability 0개, allowPrivilegeEscalation: false, 읽기 전용 root, RuntimeDefault seccomp |
| Docker daemon sidecar | UID 1001 | SETUID, SETGID, SETFCAP만 추가, procMount: Unmasked, 전용 Localhost seccomp profile |
Pod 전체에는 hostUsers: false를 걸었습니다. Pod 안의 UID 0과 65536개 UID 범위가 노드의 다른 UID로 매핑되므로, sidecar가 가진 capability도 그 user namespace 안에서만 의미가 있습니다. 두 컨테이너가 공유하는 것은 작업 디렉터리와 Docker API socket뿐이고, runner의 private HOME과 등록 파일은 daemon에 마운트하지 않습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
spec:
  hostUsers: false
  automountServiceAccountToken: false
  resources:            # Pod 수준 예산, 두 컨테이너가 함께 사용
    requests: {cpu: 500m, memory: 5Gi}
    limits: {cpu: "4", memory: 5Gi}
  initContainers:
  - name: dind
    restartPolicy: Always   # native sidecar
    securityContext:
      runAsUser: 1001
      privileged: false
      readOnlyRootFilesystem: true
      procMount: Unmasked
      capabilities:
        drop: [ALL]
        add: [SETUID, SETGID, SETFCAP]
      seccompProfile:
        type: Localhost
        localhostProfile: arc-docker-runtime-v2.json
    resources:
      limits:
        kkamji.net/arc-tun: "1"
메모리 5Gi는 처음 구성의 Pod 수준 예산입니다. Kubernetes 1.36에서 두 컨테이너의 cgroup 상위 한도가 각각 5Gi가 아니라 합계 5Gi로 잡히는 것을 별도 Pod로 먼저 확인했습니다. 지금은 저장소마다 다른 예산을 씁니다(6절).
3.2. 막힌 지점과 바꾼 것
한 번에 동작하지 않았습니다. 권한을 하나 열 때마다 다음 실패 지점이 드러났고, 각 단계에서 바꾼 것은 다음과 같습니다.
| 관측 | 원인 | 바꾼 것 |
|---|---|---|
기본 seccomp에서 unshare와 namespace clone 실패 | RuntimeDefault가 중첩 user namespace 생성을 막음 | 필요한 syscall만 허용한 Localhost profile을 DaemonSet으로 worker에 배포 |
| UID 매핑 helper 실패 | 매핑에 필요한 capability 부족 | SETUID, SETGID, SETFCAP만 추가 |
| 중첩 namespace의 사용자 ID가 의도와 다르게 바뀜 | 이미지의 SUID mount, umount | 두 파일의 SUID 비트만 제거 |
| 분리된 network namespace bind 실패 | rootless 진입점의 기본 동작 | 공식 진입점의 DETACH_NETNS=0 사용 |
slirp가 /dev/net/tun 없음으로 실패 | 노드에 장치가 있어도 Pod에 할당되지 않음 | device plugin으로 kkamji.net/arc-tun 리소스 등록 |
BuildKit docker-container driver가 sysfs mount에서 거부됨 | 해당 driver가 privileged sysfs를 요구 | containerd image store와 기본 docker driver 사용 |
노드에 /dev/net/tun이 있다는 사실과 Pod가 그 장치를 쓸 수 있다는 사실은 다릅니다. containerd 기본 설정은 TUN을 device cgroup에 허용하지 않고, kubelet은 임의의 Pod annotation을 CRI의 CDI annotation으로 넘기지 않습니다. 파일 mount나 annotation만으로는 해결되지 않아 device plugin을 썼습니다. device plugin 자체도 UID 0이지만 capability 0개, 읽기 전용, no_new_privs로 실행되고 privileged가 아닙니다.
이 구성에서 Docker 29의 pull, build와 cache, 컨테이너 실행, bridge, published port, bind mount, named volume을 확인했습니다. 그 뒤 실제 GitHub JIT 등록과 원래 workflow로 검증했습니다.
4. 실제 run에서 실패한 것
고정된 진단 Pod에서 통과해도 실제 GitHub job에서는 다른 곳에서 실패했습니다. 운영을 시작한 뒤에도 제가 바꾼 설정 때문에 실패한 적이 있습니다.
4.1. checkout 위치와 작업 디렉터리
Rust 저장소의 첫 run은 테스트 전에 exit code 125로 멈췄습니다. checkout이 runner의 private HOME 아래에 생겼고, Docker daemon은 공유 작업 볼륨 밖의 그 경로를 만들 수 없었습니다. ARC 0.15 소스에서 JIT 설정의 WorkFolder는 runner 컨테이너의 workingDir에서 정해집니다. workingDir을 공유 작업 경로인 /home/runner/_work로 지정하자 checkout 위치가 맞았습니다.
4.2. Docker 데이터 크기와 시작 조건
다음 run은 Tier A 도중 Pod가 eviction됐습니다. 원인은 메모리가 아니라 Docker 데이터 emptyDir가 한도 10Gi를 넘은 것이었습니다. 12Gi와 16Gi에서도 같은 이유로 실패했고, 16Gi에서는 테스트 바이너리 277개를 빌드한 뒤 한도에 닿았습니다. 테스트를 빼거나 ELF를 strip하는 방식은 쓰지 않았습니다.
대신 runner가 저장소 코드를 실행하기 전에 노드 여유를 확인합니다. 필요한 디스크 예산에 max(5Gi, 파일시스템 15% + 1Gi)를 더한 값보다 여유가 적으면 job을 시작하지 않습니다. kubelet의 imagefs eviction 기본값 15%를 반영한 값입니다.
지금 디스크 예산은 저장소마다 다릅니다. Rust 저장소는 Docker 데이터 30Gi(job 예산 34Gi)이고, 3시간 동안 runner Pod를 20초마다 샘플링한 최대 사용량은 19.35GiB였습니다. 웹 저장소는 30Gi에서 7Gi(job 예산 11Gi)로 줄였습니다.
이 축소를 반영한 직후 웹 저장소 runner가 전부 시작하자마자 종료됐습니다. 시작 조건 스크립트가 job 예산으로 16Gi와 34Gi만 허용하도록 작성돼 있었고, 제가 차트에 새로 렌더한 11Gi를 그 목록에 넣지 않았기 때문입니다. 스크립트가 차트에 렌더되는 모든 풀 예산을 받아들이는지 검사하는 테스트를 추가하고 목록을 고쳤습니다. 예산 값이 차트 values와 스크립트 두 곳에 있었던 것이 원인이라, 지금은 테스트가 둘을 맞춰 봅니다.
4.3. main과 배포 브랜치를 함께 push할 때
웹 저장소는 main merge 뒤 이미지 tag를 고정한 커밋을 배포 브랜치에 push하고, Argo CD가 그 브랜치를 배포합니다. 이미지별 재빌드를 넣은 첫 main run에서 이 push가 fetch first로 거부됐습니다. 이미지 job이 depth 1로 checkout해서, 두 브랜치를 한 번에 갱신하는 데 필요한 history가 없었습니다. 같은 조건을 로컬에서 재현한 뒤 해당 job만 fetch-depth: 0으로 바꿨고, 배포 브랜치를 움직이는 job이 전체 history를 받는지 검사하는 테스트를 추가했습니다.
5. Runner 이미지는 private GHCR digest로 고정했습니다
처음에는 직접 빌드한 runner 이미지를 한 worker에만 import하고 imagePullPolicy: Never로 썼습니다. 그래서 runner가 그 노드에만 배치될 수 있었습니다.
이미지 레시피를 Helm chart 저장소에 두고 private GHCR에 올린 뒤, values에는 digest와 IfNotPresent를 썼습니다. 레지스트리 digest는 기존 로컬 이미지 digest와 같았습니다. pull secret은 External Secrets Operator가 기존 Parameter Store 항목에서 dockerconfigjson으로 만듭니다. 토큰은 read:packages 권한만 가진 classic PAT이고, 값은 소유자가 직접 입력했습니다.
이미지가 없던 worker에서 측정한 cold pull은 Docker sidecar 이미지 4분 53초, runner 이미지 20초였습니다. 첫 배치 한 번의 비용이고 이후에는 노드 cache를 씁니다.
6. 동시 실행 상한은 크기별 슬롯과 quota로 걸었습니다
처음 측정한 Rust 저장소 gate는 약 2시간이었습니다. full 풀이 maxRunners: 1이었고 quota도 runner 하나만 허용했기 때문에 job 여섯 개가 차례로 실행됐습니다(Tier A 34분, Tier B 13분, release 8분, proof receipts 8분 등).
처음에는 노드당 TUN 슬롯 1개와 runner 2개 quota로 두 저장소가 슬롯 2개를 나눠 쓰게 했습니다. 이 구성에서는 먼저 잡는 쪽이 슬롯을 썼고, 웹 저장소의 1분짜리 e2e job이 Rust 저장소 job 뒤에서 28분을 기다린 기록이 있습니다. 실측한 웹 저장소 runner의 최대 메모리는 2.76GiB, CPU는 0.76코어였는데 슬롯 하나 전체를 받고 있었습니다.
worker 메모리를 16GiB로 늘린 뒤 슬롯을 저장소 크기에 맞춰 나눴습니다.
- 노드마다 TUN 슬롯 2개를 두고, 웹 저장소 runner(메모리 3584Mi, 디스크 11Gi) 1개와 Rust 저장소 runner(7Gi, 34Gi) 1개가 들어간다.
- 같은 풀의 runner는 anti-affinity로 서로 다른 노드에 배치한다. 저장소별 풀은
maxRunners: 2다. ci-fullquota는 runner 4개와 관리 Pod만 허용한다.requests.kkamji.net/arc-tun4, 메모리 요청 22016Mi, ephemeral-storage 한도 92Gi다.
다섯 번째 runner는 노드에서 Pending으로 남지 않고 quota에서 거부됩니다. ARC 0.15의 ephemeralrunner_controller.go는 exceeded quota: 오류를 받으면 30초 뒤 다시 시도하고, 만든 지 10분이 지난 EphemeralRunner는 지워서 새로 만들게 합니다. job은 실패하지 않고 기다립니다. runner set을 교체할 때 job을 실행 중인 runner는 건너뛰므로(ephemeralrunnerset_controller.go), 템플릿을 바꾸는 merge가 진행 중인 job을 끊지 않습니다.
디스크 11Gi
TUN 슬롯 1개
디스크 34Gi
TUN 슬롯 1개
디스크 11Gi
TUN 슬롯 1개
디스크 34Gi
TUN 슬롯 1개
같은 저장소의 runner 2개는 anti-affinity로 서로 다른 노드에 놓입니다
runner Pod 생성 요청
메모리 요청 22016Mi, 디스크 92Gi
job은 실패하지 않고 대기
30초 뒤 다시 시도, 만든 지 10분이 지난 EphemeralRunner는 지우고 새로 만듦
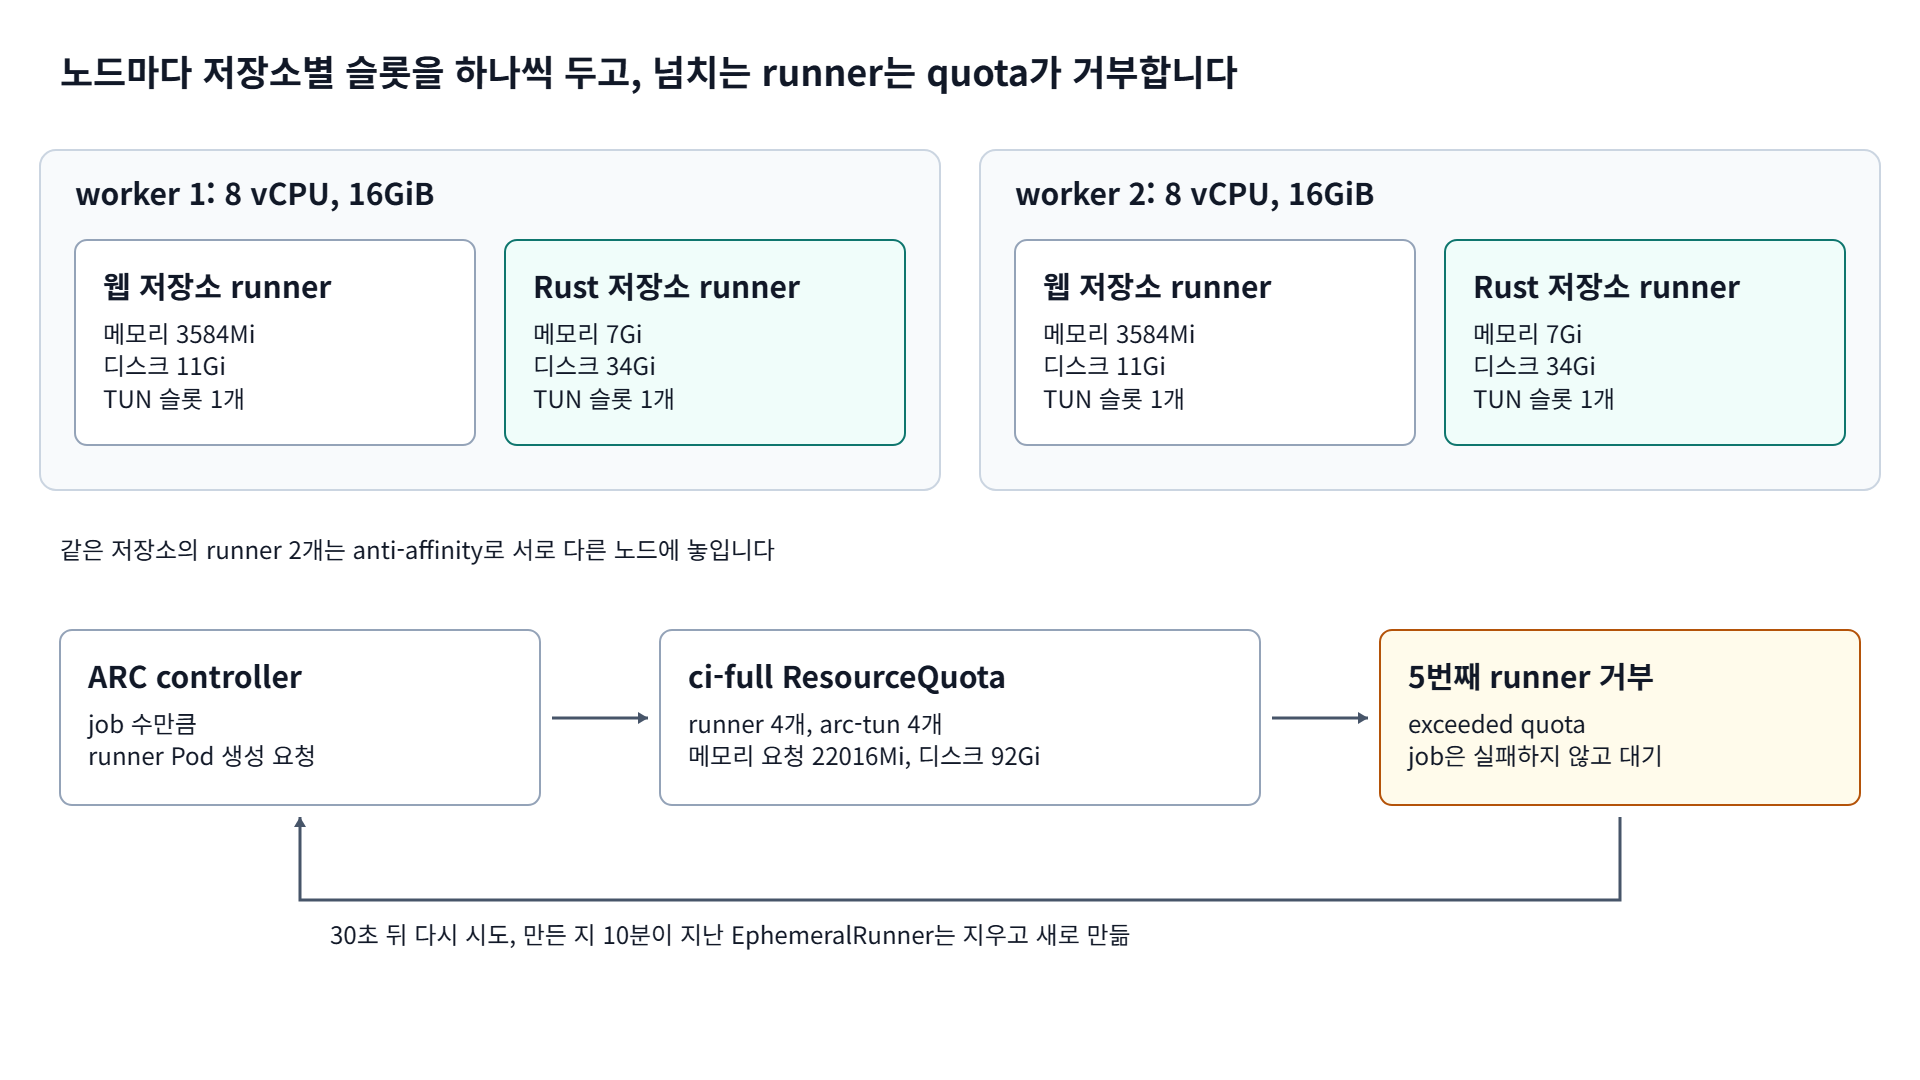
이제 두 저장소는 서로의 슬롯을 기다리지 않습니다. 대신 같은 저장소의 job끼리는 여전히 슬롯 2개를 두고 경쟁합니다. Rust 저장소 PR이 여러 개 열리면 그 대기가 그대로 남습니다(8절).
7. 웹 저장소 CI
7.1. CPU 한도
worker가 3 vCPU이고 runner CPU 한도가 2였던 3일 동안 runner Pod는 CFS 기간의 14~21%에서 throttle됐습니다. 노드 사용률은 최대 84~86%였고 hypervisor steal은 0%였습니다. 장비에는 여유가 있었기 때문에 worker를 8 vCPU로 늘리고 runner CPU 한도를 4로 올렸습니다. CPU 요청은 500m로 그대로 두어 다른 workload의 스케줄링 보장은 바뀌지 않습니다.
7.2. 제어 job을 light 풀로
웹 저장소 run 하나가 64분 걸렸을 때 job 실행 시간의 합은 약 12분이었습니다. 나머지는 full 슬롯 대기였고, 몇 초짜리 gate가 4~11분, 결과 집계 ci-ok가 약 34분을 기다렸습니다. gate와 ci-ok를 light 풀로 옮기고, 계약 테스트로 이 두 job은 light, 나머지는 full에서 실행되도록 고정했습니다.
| 지표 | 변경 전 | 변경 후 |
|---|---|---|
gate 대기 | 4~11분 | 28초 |
| 웹 저장소 CI 전체 | 64분 | 30분 |
7.3. GitHub Actions cache와 이미지별 재빌드
Rust로 바뀐 API와 검색 서버 이미지는 빌드 cache를 GitHub Actions cache(type=gha)에 저장하고 있었습니다. 로그에서 cache를 내려받는 속도는 약 0.8MB/s였고, cache를 받는 시간이 처음부터 컴파일하는 시간보다 길었습니다. 두 이미지에서 GitHub Actions cache를 빼고, 프런트엔드 이미지에만 남겼습니다.
또 main push마다 이미지 세 개를 모두 빌드하던 것을, 이미지마다 마지막으로 고정한 커밋 이후 입력 파일이 바뀐 이미지만 빌드하도록 바꿨습니다. 이미지가 바뀌지 않은 push는 빌드 없이 배포 단계로 넘어갑니다.
| 지표(main push) | 변경 전(2건) | 변경 후(2건) |
|---|---|---|
| run 전체 | 20.0분, 25.4분 | 9.3분, 10.5분 |
| full runner 점유 합계 | 16.8분, 16.1분 | 8.2분, 8.6분 |
변경 후 표본은 아직 2건입니다. PR은 대기가 없을 때 13~19분이고, 같은 저장소의 다른 run과 겹치면 대기 때문에 47분까지 걸린 기록이 있습니다.
8. Rust 저장소 CI
8.1. 처음 측정한 시간 구성
| 구분 | 시간 | 내용 |
|---|---|---|
| 컴파일 | 약 48분 | job 5개가 같은 소스를 각자 처음부터 컴파일. 시간을 확인한 네 job은 Tier A 19분 21초, Tier B 10분 9초, source qualification 6분 24초, release 5분 48초. CARGO_BUILD_JOBS=1 |
| 테스트 | 약 38분 | source qualification 1659초 중 오라클 테스트 2개가 1652초(1081초, 571초) |
| 이미지 빌드 | 약 10분 | job마다 Ubuntu 26.04 CI 이미지를 92~138초 동안 빌드 |
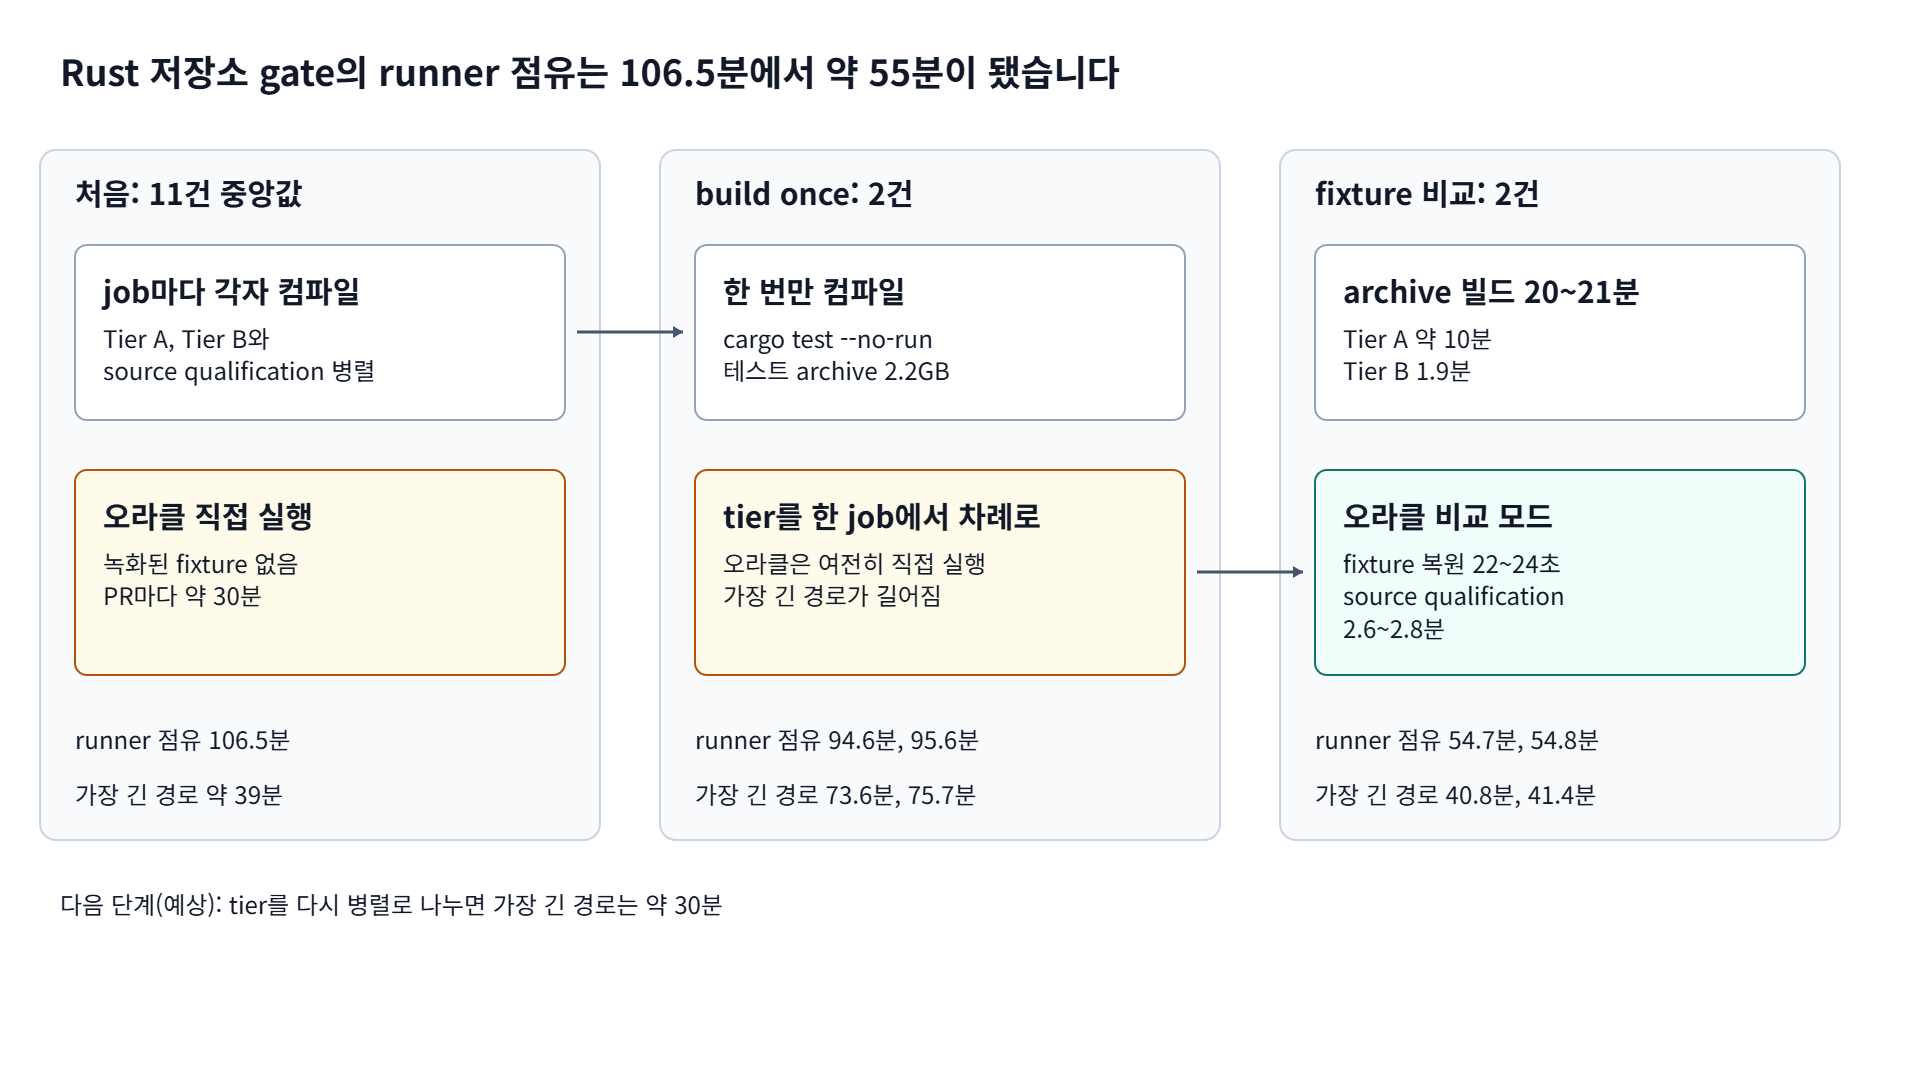
성공한 run 11건의 중앙값으로 보면 PR 하나가 full runner를 106.5분 점유했습니다. Tier A 36.1분, Tier B 13.5분, source qualification 38.7분이 그중 88.3분입니다. PR이 몰리면 대부분의 시간이 슬롯 대기라서, 같은 기간 PR의 대기를 포함한 전체 시간은 2~5시간이었습니다.
8.2. 한 번 컴파일하고 모든 tier를 실행
세 tier가 각자 컴파일하던 것을 job 하나에서 cargo test --no-run으로 한 번만 빌드하도록 바꿨습니다. 테스트 바이너리를 archive로 묶고, 각 tier는 원래 컨테이너 설정 그대로 archive에서 실행합니다. 테스트 바이너리 346개를 담은 archive는 2.2GB이고, 원래 target 디렉터리는 12GB였습니다. 첫 시도는 archive를 테스트 scratch에 통째로 풀다가 3Gi 한도를 넘어 eviction됐고, archive를 제자리에서 검증하고 없는 파일만 놓도록 바꾼 뒤 통과했습니다.
| 지표 | 변경 전(11건 중앙값) | 변경 후(2건) |
|---|---|---|
| 테스트 결과 | 342개 suite 3367 passed, 343개 suite 3377 passed, 모두 0 failed | |
| Rust tier runner 점유 | 88.3분(job 3개) | 73.6분, 75.7분(job 1개) |
| run 전체 runner 점유 | 106.5분 | 95.6분, 94.6분 |
| 슬롯이 비어 있을 때 가장 긴 경로 | 약 39분(tier 병렬) | 73.6분, 75.7분(tier 직렬) |
runner 점유는 10% 줄었지만, 슬롯이 비어 있을 때의 전체 시간은 오히려 늘었습니다. tier들이 한 job 안에서 차례로 실행되기 때문입니다. 슬롯 대기가 시간의 대부분인 지금은 점유를 줄이는 쪽이 낫다고 보고 적용했습니다. 다음 단계는 archive를 클러스터 내부 registry로 넘겨 tier를 다시 병렬로 실행하는 것이고, 단계별 시간으로 계산한 가장 긴 경로는 약 56분이었습니다(예상). 오라클 fixture를 적용하기 전 기준이고, 적용 후 예상은 8.6절에 있습니다.
8.3. 녹화된 적 없는 오라클 fixture
build once를 적용한 run에서 source qualification의 1878.6초 중 1871초가 오라클 테스트 두 개였습니다. 이 둘을 줄이려고 Python 오라클의 결과를 fixture로 기록하는 workflow를 미리 만들어 두었습니다. 오라클 커밋과 driver, 테스트, CI 이미지 정의, Python 환경 고정 스크립트의 hash를 key로 쓰고, 기록은 main에서만 두 번 실행해 byte 단위로 같을 때만 저장합니다. PR job은 저장된 fixture를 복원해 Rust 결과와 비교하고, fixture가 없으면 오라클을 직접 실행합니다.
시간이 줄지 않아 로그를 확인했습니다. 비교한 run마다 Cache not found for input keys가 찍혀 있었습니다. 저장소의 Actions cache는 0개였고, 기록 workflow는 추가된 뒤 한 번도 실행되지 않았습니다. 하루 한 번 schedule로 실행되도록 설정했는데 그 실행이 없었고, 원인은 아직 확인하지 못했습니다. 결과적으로 모든 PR이 오라클을 직접 실행해 약 30분을 썼습니다.
기록 workflow를 main에서 직접 실행했지만 두 번 모두 330분 제한에 걸려 끝났고, 첫 실행은 로그도 남지 않았습니다. 두 번째 실행을 runner 안에서 지켜보니 두 차례 기록은 각각 약 30분 만에 끝났습니다. 그 뒤 runner 프로세스가 CPU 1개와 메모리 4.9GB를 쓰면서 로그를 더 쓰지 않았습니다. 기록 뒤에 남은 출력은 두 결과를 비교하는 diff -r 하나뿐이고, fixture는 한 줄짜리 JSON이라 조금만 달라도 수 MB짜리 한 줄이 출력됩니다.
그래서 비교 출력을 차이 위치와 주변 내용으로 제한했습니다. 다음 실행에서 runner는 멈추지 않았고, 두 기록은 크기가 byte 단위까지 같은데 내용이 달랐습니다.
차이를 파일 단위로 짝지어 보니, 첫 차이는 이벤트 hash chain의 첫 항목이 가리키는 이전 hash 값이었습니다. 시각과 원본 데이터 필드는 같았습니다. hash chain의 시작 값은 기록 디렉터리의 파일시스템 식별자(device와 inode)를 담은 첫 기록의 hash였습니다. 새로 만든 디렉터리는 inode가 매번 다르므로, 두 번 기록해서 byte 단위로 같기를 요구한 제 검증 조건이 처음부터 만족될 수 없었습니다. 오라클이 의도해서 넣은 값이라 고칠 대상도 아니었습니다.
그래서 조건을 바꿨습니다. 한 번 기록한 뒤 같은 job에서 그 fixture로 비교 모드를 실행하고, 통과할 때만 저장합니다. 이 방식으로 처음 fixture가 저장됐고, 같은 job에서 두 모드의 시간을 바로 비교할 수 있었습니다.
| source qualification | 오라클 직접 실행 | 비교 모드 |
|---|---|---|
| 전체 테스트 | 1768.5초 | 80.5초 |
| lockstep 테스트 | 579.9초 | 20.0초 |
| replay CLI 테스트 | 1181.0초 | 53.0초 |
fixture는 원본 약 885MB이고 cache에는 압축되어 64MB로 저장됩니다. fixture 저장 뒤 PR run 2건에서 cache 복원은 22초와 24초, source qualification 단계는 2.8분과 2.6분이었습니다. 이전 PR들의 같은 단계는 29.4~32.7분이었습니다.
run 단위 결과는 세 값으로 나눠 봐야 합니다. runner 점유는 full 풀 job의 실행 시간을 모두 더한 값이고, 가장 긴 경로는 tier를 모두 실행하는 job 하나의 시간입니다. run 전체 시간에는 슬롯 대기가 더해집니다.
| 지표 | 첫 run | 두 번째 run |
|---|---|---|
| runner 점유 | 54.7분 | 54.8분 |
| 가장 긴 경로(tier job) | 40.8분 | 41.4분 |
| run 전체 | 50.3분 | 42.1분 |
첫 run에서는 짧은 job 두 개가 슬롯 2개를 먼저 잡아서 tier job이 9.1분 늦게 시작했습니다. 두 번째 run에서는 tier job이 바로 시작해 run 전체가 그 job보다 0.7분 길었습니다. 같은 저장소의 job이 슬롯 2개를 나눠 쓰는 동안에는 tier job이 먼저 슬롯을 잡는지에 따라 run 전체가 8분 넘게 달라집니다.
source qualification 병렬
PR마다 약 30분
runner 점유 106.5분
가장 긴 경로 약 39분
테스트 archive 2.2GB
가장 긴 경로가 길어짐
runner 점유 94.6분, 95.6분
가장 긴 경로 73.6분, 75.7분
Tier B 1.9분
source qualification
2.6~2.8분
runner 점유 54.7분, 54.8분
가장 긴 경로 40.8분, 41.4분
다음 단계(예상): tier를 다시 병렬로 나누면 가장 긴 경로는 약 30분
8.4. 클러스터 내부 registry
CI 이미지를 미리 GHCR에 올려 두는 방법은 처음에 이득이 없었습니다. 이미지가 1.65GB이고 회선 다운로드가 약 8MB/s라 pull에 60~90초가 걸려, 로컬 빌드 92초와 차이가 거의 없었습니다. 병목이 WAN이라 registry를 클러스터 안에 두기로 했고, push와 Docker Hub pull-through mirror를 한 인스턴스에서 지원하는 zot을 골랐습니다. registry 설정, 신뢰 경계와 실패 방식별 측정은 zot으로 HomeLab CI registry 구성하기에 정리했고, 여기에는 runner 쪽 변경과 CI에 준 효과만 남깁니다.
ci-full의 job Pod만 registry Pod의 5000 포트로 나갈 수 있다. 2절의 사설 대역 차단에서 하나뿐인 예외다.- runner의 rootless Docker daemon은
--registry-mirror로 zot을 먼저 쓰고, zot에 닿지 못하면 Docker Hub에서 직접 받는다. - CI 이미지는 main에서만 실행되는 workflow가 실행마다 고유한 tag로 push하고, 그 digest를 main 범위의 GitHub Actions cache에 저장한다. PR job은 그 digest로만 pull한다. registry에 닿는 PR job도 tag를 먼저 만들 수 있으므로 tag는 신뢰하지 않는다.
main에 적용한 뒤 첫 PR run에서 이미지 단계는 job당 12~13초였습니다. digest 복원에 2~3초, pull에 10~11초가 걸렸습니다. 이전 66건의 중앙값 102초보다 약 89초 짧고, job 4개를 합치면 PR 하나당 약 6분입니다(1건).
Docker Hub mirror는 Rust 저장소에는 효과가 없었습니다. Docker Hub에서 받는 base image가 42MB 하나뿐이라, mirror 적용 뒤 이미지 빌드 단계는 94초로 이전 66건의 중앙값 102초(90~126초) 범위 안이었습니다. 웹 저장소는 338MB base image를 테스트 job마다 받기 때문에, warm mirror에서 docker run이 50.0초, 38.8초에서 7.2초, 8.5초가 됐습니다. 처음 받는 cold 요청은 이전과 같은 약 41초였습니다.
8.5. merge된 PR의 run이 슬롯을 계속 점유
슬롯 대기를 보다가 이미 merge된 PR의 gate run이 슬롯 두 개를 모두 쓰고 있는 것을 발견했습니다. workflow의 concurrency group은 같은 브랜치에 새 push가 올 때만 이전 run을 취소하고, PR이 merge되거나 닫힐 때는 아무것도 취소하지 않습니다.
최근 닫힌 PR 30건 중 6건이 merge 후에도 run을 계속 실행했고, runner를 실제로 받은 job만 세면 합계 590.6분이었습니다. 한 건은 merge 후 124분 동안 실행됐습니다. PR이 닫히면 그 브랜치의 끝나지 않은 gate run을 취소하는 workflow를 light 풀에 추가했고, 이후 닫힌 PR의 남은 gate run이 취소되는 것을 확인했습니다. 이 workflow는 checkout 없이 REST API만 호출하고 actions: write 권한만 씁니다.
8.6. 처음 세운 예상과 지금 예상
처음에는 오라클 fixture, build once, 내부 cache, 크기별 슬롯을 적용하면 Rust 저장소 PR이 13~15분, runner 점유가 30분대가 된다고 예상했습니다. 이 예상은 틀렸습니다. 오라클 테스트가 실제로 fixture 없이 실행되고 있었고, build once가 슬롯이 비어 있을 때의 시간을 늘린다는 점을 계산에 넣지 않았습니다.
| 대상 | 지금까지 측정 | 다음 단계 적용 후(예상) |
|---|---|---|
| 웹 저장소 main push | 9.3~10.5분(2건), mirror 적용 후는 아직 측정하지 않음 | warm mirror에서 base image가 든 docker run이 약 40초에서 7~9초로 줄어든 만큼 짧아진다. cold 빌드는 줄지 않았다 |
| Rust 저장소 runner 점유 | build once 후 94.6~95.6분(2건), 내부 CI 이미지 적용 후 82.7분(1건), 오라클 fixture까지 적용 후 54.7~54.8분(2건) | tier를 병렬로 나눠도 점유는 비슷하다 |
| Rust 저장소 가장 긴 경로 | build once 후 73.6~75.7분(2건), 오라클 fixture까지 적용 후 40.8~41.4분(2건) | tier 병렬화 후 약 30분(archive 빌드 20분과 가장 긴 tier 10분) |
내부 CI 이미지를 적용한 run의 82.7분은 1건이고, build once 직후보다 12분 이상 짧습니다. 이미지 단계로 줄어든 시간은 PR 하나당 약 6분이라 나머지 차이의 원인은 확인하지 못했습니다. 그래서 이 차이 전체를 내부 이미지의 효과로 보지 않습니다.
9. 운영하면서 남은 위험
- Rust 저장소 job끼리는 슬롯 2개를 공정성 보장 없이 나눠 쓴다.
- registry에 익명으로 새 tag를 추가할 수 있다. 무결성은 main이 기록한 digest로 지키지만, 저장 공간을 채우는 공격은 30Gi 상한과 보존 정책으로만 막는다.
- registry 저장소는 emptyDir라 Pod가 다시 만들어지면 비어 있는 상태로 시작한다.
- 다른 workload의 PriorityClass가
PreemptLowerPriority라 노드가 꽉 차면 runner를 선점할 수 있다. runner 자신은 선점하지 않는 우선순위 0 class를 쓴다. - runner 이미지에 공식 이미지에서 온 setuid
sudo가 남아 있다. runner 컨테이너는no_new_privs와 capability 0개라 막히지만 제거 대상이다. - 하나의 GitHub App 키를 두 namespace가 공유한다. 저장소별 자격증명 격리가 아니다.
10. Reference
- GitHub Docs - Actions Runner Controller
- GitHub Docs - Deploying runner scale sets with Actions Runner Controller
- GitHub Docs - Dependency caching reference
- GitHub Docs - REST API endpoints for workflow runs
- GitHub - actions-runner-controller ephemeralrunner_controller.go (0.15.0)
- GitHub - actions-runner-controller ephemeralrunnerset_controller.go (0.15.0)
- Kubernetes Docs - User Namespaces
- Kubernetes Docs - Device Plugins
- Kubernetes Docs - Resource Quotas
- Kubernetes Docs - Restrict a Container’s Syscalls with seccomp
- Docker Docs - Rootless mode
- Docker Docs - containerd image store
- Docker Docs - Mirror the Docker Hub library
- zot - OCI-native container registry
- GitHub - zot configuration examples (v2.1.22)
- Cilium Docs - Policy language
궁금하신 점이나 추가해야 할 부분은 댓글이나 아래의 링크를 통해 문의해주세요.
Written with KKamJi