Cilium CNI 알아보기 [Cilium Study 1주차]
Kubernetes 클러스터에서 Cilium CNI를 선택할 때는 eBPF datapath, Pod 네트워크의 라우팅 방식, IP 주소 할당 방식을 함께 확인해야 합니다. 이 글은 기존 iptables 기반 처리의 한계부터 routing mode, IPAM, kube-proxy replacement까지 연결해 각 선택의 전제와 검증 지점을 정리합니다.
1. Cilium 이란?
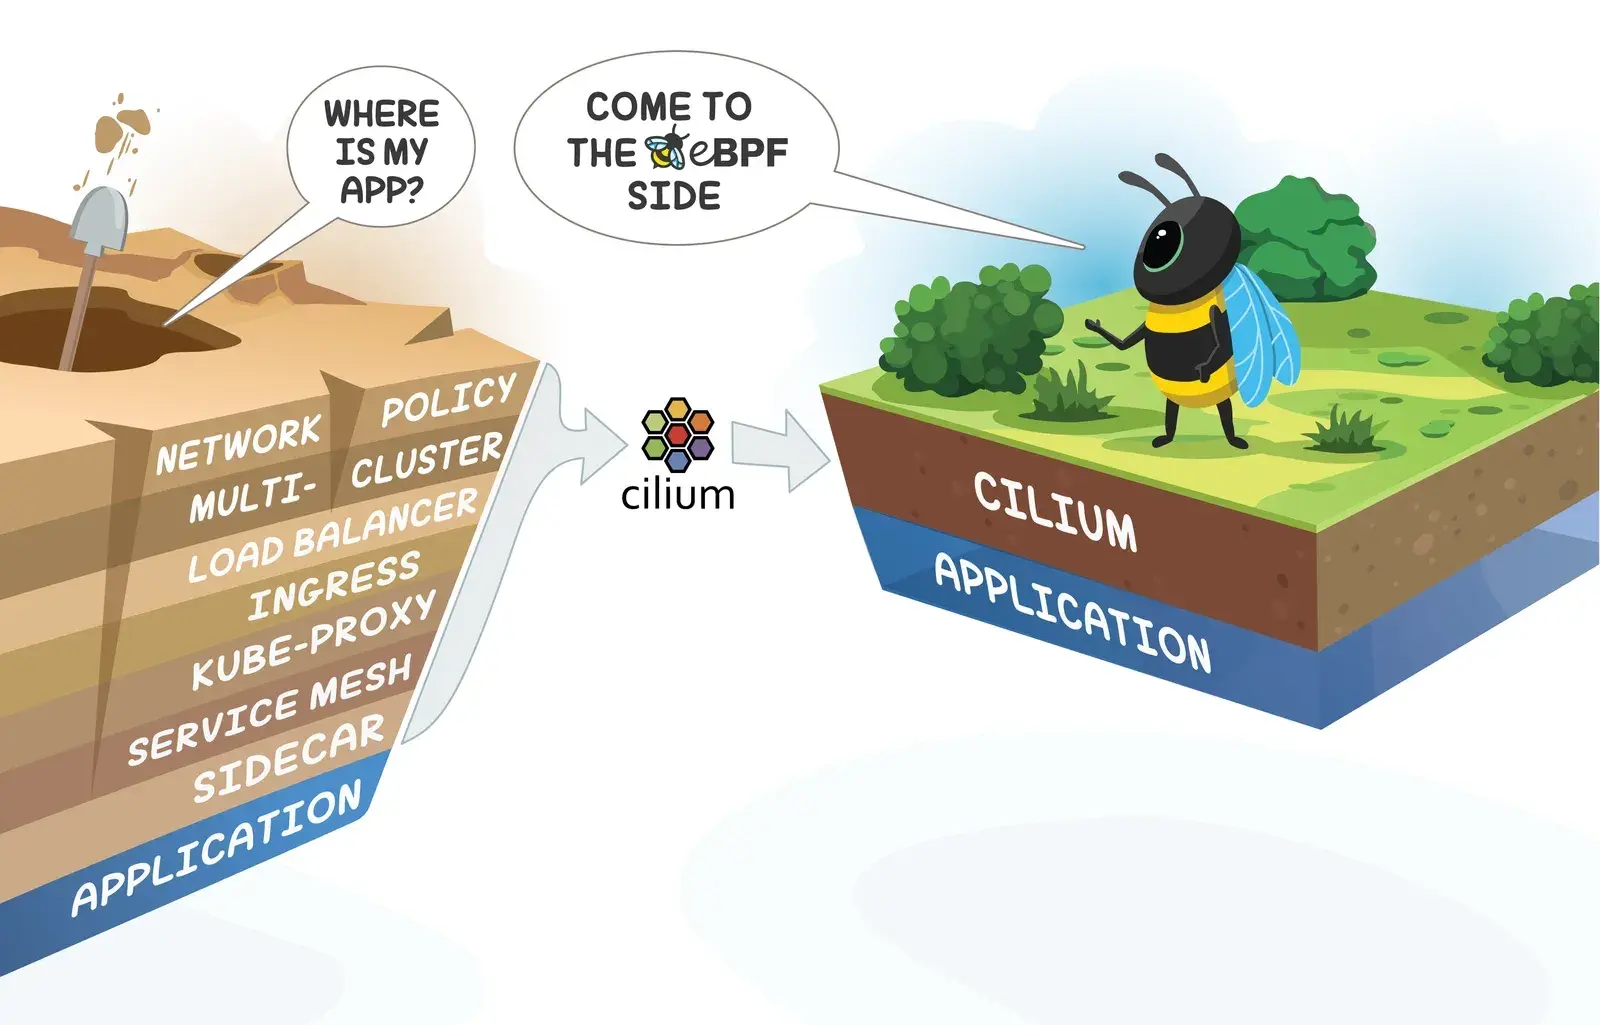
Cilium은 리눅스의 최신 Kernel 기술인 eBPF(extended Berkeley Packet Filter)를 기반으로 동작하는 오픈소스 네트워크 및 보안 솔루션입니다. Kubernetes와 같은 컨테이너 환경에서 높은 성능과 뛰어난 보안을 제공하는 클라우드 네이티브 네트워크 플러그인(CNI: Container Network Interface)입니다.
기존 Kubernetes의 네트워크 방식(ex: kube-proxy 기반 iptables/ipvs)이 가진 한계를 극복하기 위해 설계되었으며, 현재 많은 글로벌 기업에서 프로덕션 환경에 널리 사용되고 있습니다.
TL;DR
- Cilium은 eBPF datapath로 Kubernetes 네트워킹, 정책 집행, 서비스 로드 밸런싱, 흐름 관측을 연결합니다.
- 터널 모드는 하부 네트워크 요구 사항이 작고, native routing은 Pod CIDR(Classless Inter-Domain Routing)를 라우팅할 수 있는 네트워크가 필요합니다.
- kube-proxy replacement는 단순 성능 옵션이 아니라 Service datapath 전환입니다. 기존 연결 영향과 검증 절차를 먼저 계획해야 합니다.
2. Why Cilium & Hubble?
eBPF는 지금까지는 불가능했던 세밀함과 효율성으로 시스템과 애플리케이션을 관찰하고 제어할 수 있게 해 주는 기술입니다. 애플리케이션을 전혀 수정하지 않아도 되며, 최신 컨테이너 워크로드뿐 아니라 가상머신이나 일반 리눅스 프로세스 같은 전통적인 워크로드에도 동일하게 적용할 수 있습니다.
현대 데이터센터 애플리케이션의 개발은 마이크로서비스라고 불리는 서비스 지향 아키텍처로 이동했습니다. 하나의 거대한 애플리케이션을 여러 개의 작은 독립 서비스로 분할하고, 이들 서비스는 HTTP 같은 경량 프로토콜을 이용해 API로 서로 통신합니다. 마이크로서비스 애플리케이션은 매우 동적이라, 부하 변화에 따라 확장,축소하거나 롤링 업데이트를 진행할 때 개별 컨테이너가 계속해서 생성되거나 소멸됩니다.
이처럼 역동적인 마이크로서비스 환경에서는 서비스 간 연결을 보호하는 데 어려움과 기회가 동시에 존재합니다. 전통적인 리눅스 네트워크 보안 기법(예: iptables)은 IP 주소와 TCP/UDP 포트를 기준으로 필터링합니다. 하지만 마이크로서비스 환경에서는 IP 주소가 수시로 바뀌기 때문에, 컨테이너 수명 주기의 급격한 변화로 인해 부하 분산 테이블과 액세스 제어 목록에 수십만 개의 규칙이 생기고 이를 매우 자주 갱신해야 해 확장에 어려움을 겪습니다. 또한 TCP 80번 포트처럼 특정 포트만으로는 서비스 트래픽을 구분하기 어렵습니다. 같은 포트로 다양한 서비스 간 메시지가 오가기 때문입니다.
정확한 가시성을 제공하는 것도 문제입니다. 전통적 시스템은 IP 주소를 주요 식별자로 사용하지만, 마이크로서비스 아키텍처에서는 IP 주소의 수명이 몇 초로 극히 짧아져 “누가 누구와 통신했는지”를 추적하기 어렵습니다.
Linux eBPF를 활용함으로써 Cilium은 보안 가시성과 정책 집행을 투명하게 삽입할 수 있습니다. 이를 IP 주소 대신 서비스, 파드, 컨테이너의 정체성 기반으로 수행하며, 애플리케이션 계층(예: HTTP)까지 필터링할 수 있습니다. 그 결과 Cilium은 보안을 주소 체계와 분리해 극도로 동적인 환경에서도 정책 관리가 간단해지도록 해 주고, 전통적인 3,4계층 분할에 더해 HTTP 계층에서까지 강력한 격리를 제공합니다.
eBPF를 사용하기에 Cilium은 대규모 환경에서도 매우 뛰어난 확장성을 유지하면서 이러한 기능을 모두 달성할 수 있습니다.
3. 기존 Kubernetes Network의 한계 (iptables)
Kubernetes에서는 주로 kube-proxy와 iptables와 같은 전통적인 Linux Network Stack을 사용합니다. 하지만 이러한 방식은 복잡하고, 변경에 시간이 오래걸리며, Layer를 건너 뛰기 어렵다는 단점이 있습니다.
iptables mode의 kube-proxy는 Service와 load balancing을 위해 DNAT rules를 만들고, CNI implementation은 NetworkPolicy enforcement에 iptables를 사용할 수 있습니다. 적용 범위는 implementation에 따라 달라집니다.
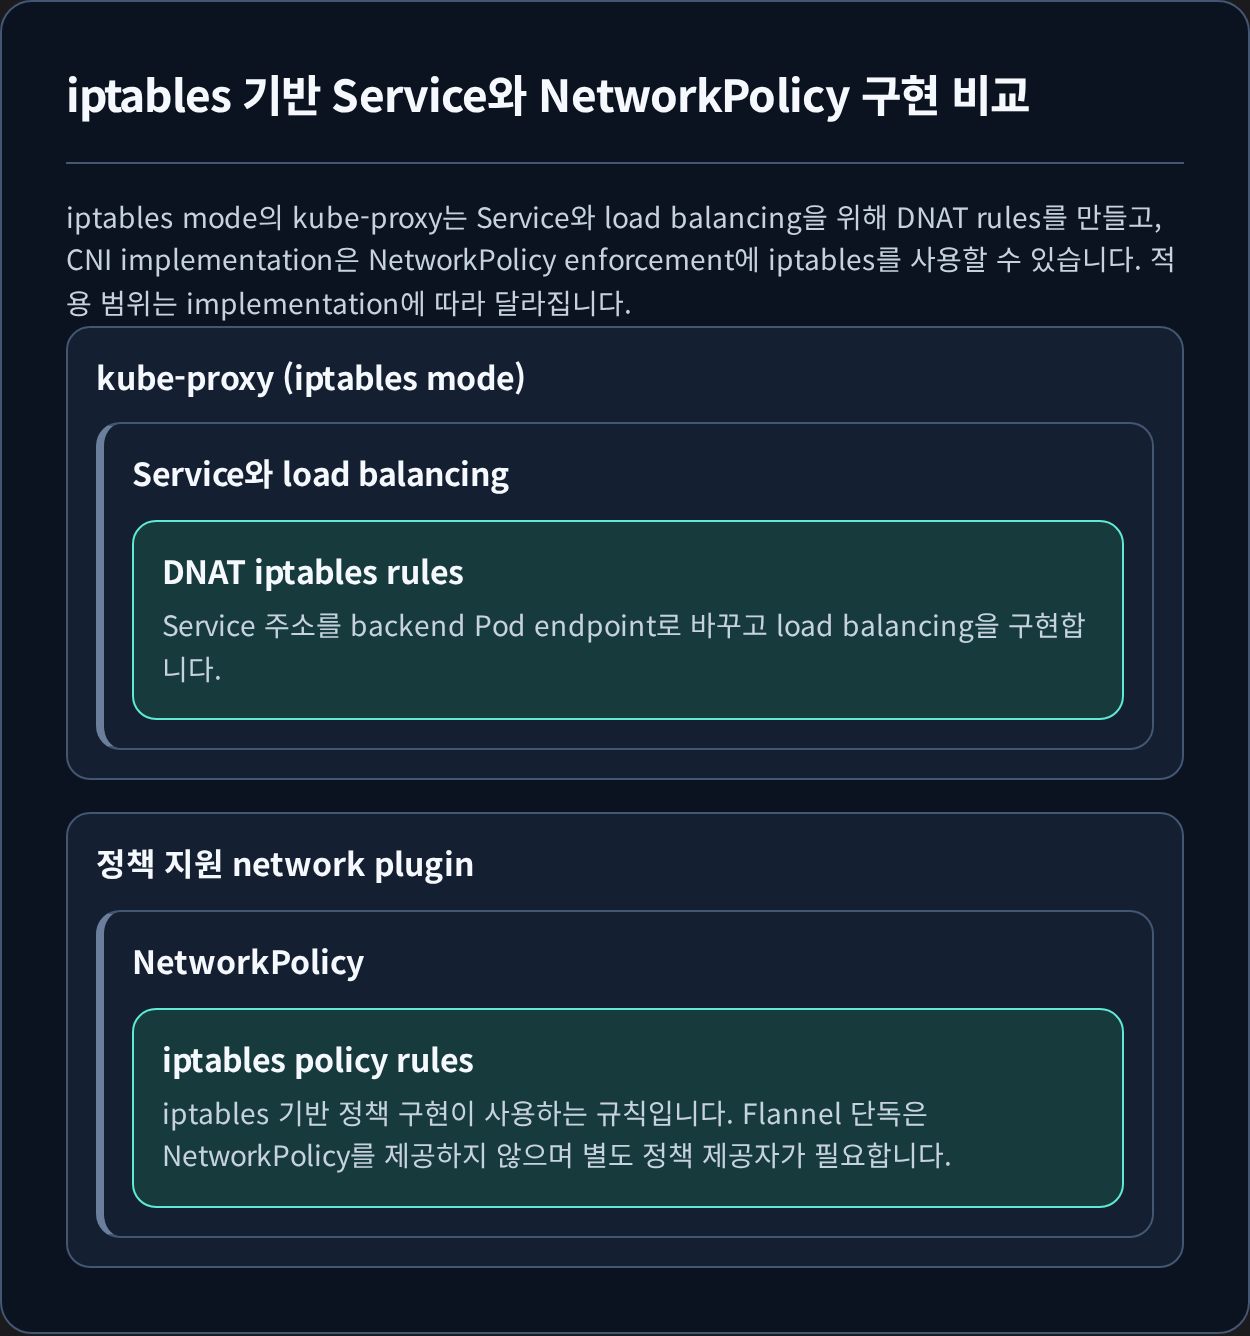
- kube-proxy: kube-proxy는 Kubernetes Cluster의 핵심 구성 요소 중 하나입니다. 이 컴포넌트는 서비스(Services)를 구현하고 로드 밸런싱(load balancing) 기능을 제공하기 위해 DNAT (Destination Network Address Translation) iptables 규칙을 사용
- 대부분의 CNI 플러그인(CNI plugins): CNI (Container Network Interface)는 컨테이너 런타임과 네트워크 플러그인 간의 표준 인터페이스입니다. Calico, Flannel, Weave Net 등 대부분의 CNI 플러그인들은 네트워크 정책(Network Policies)을 구현하기 위해 iptables를 사용
3.1. iptables의 단점
Service 수와 rule 변경이 많거나 traffic이 무거우면 latency가 예측하기 어려워지고 성능이 떨어질 수 있다.
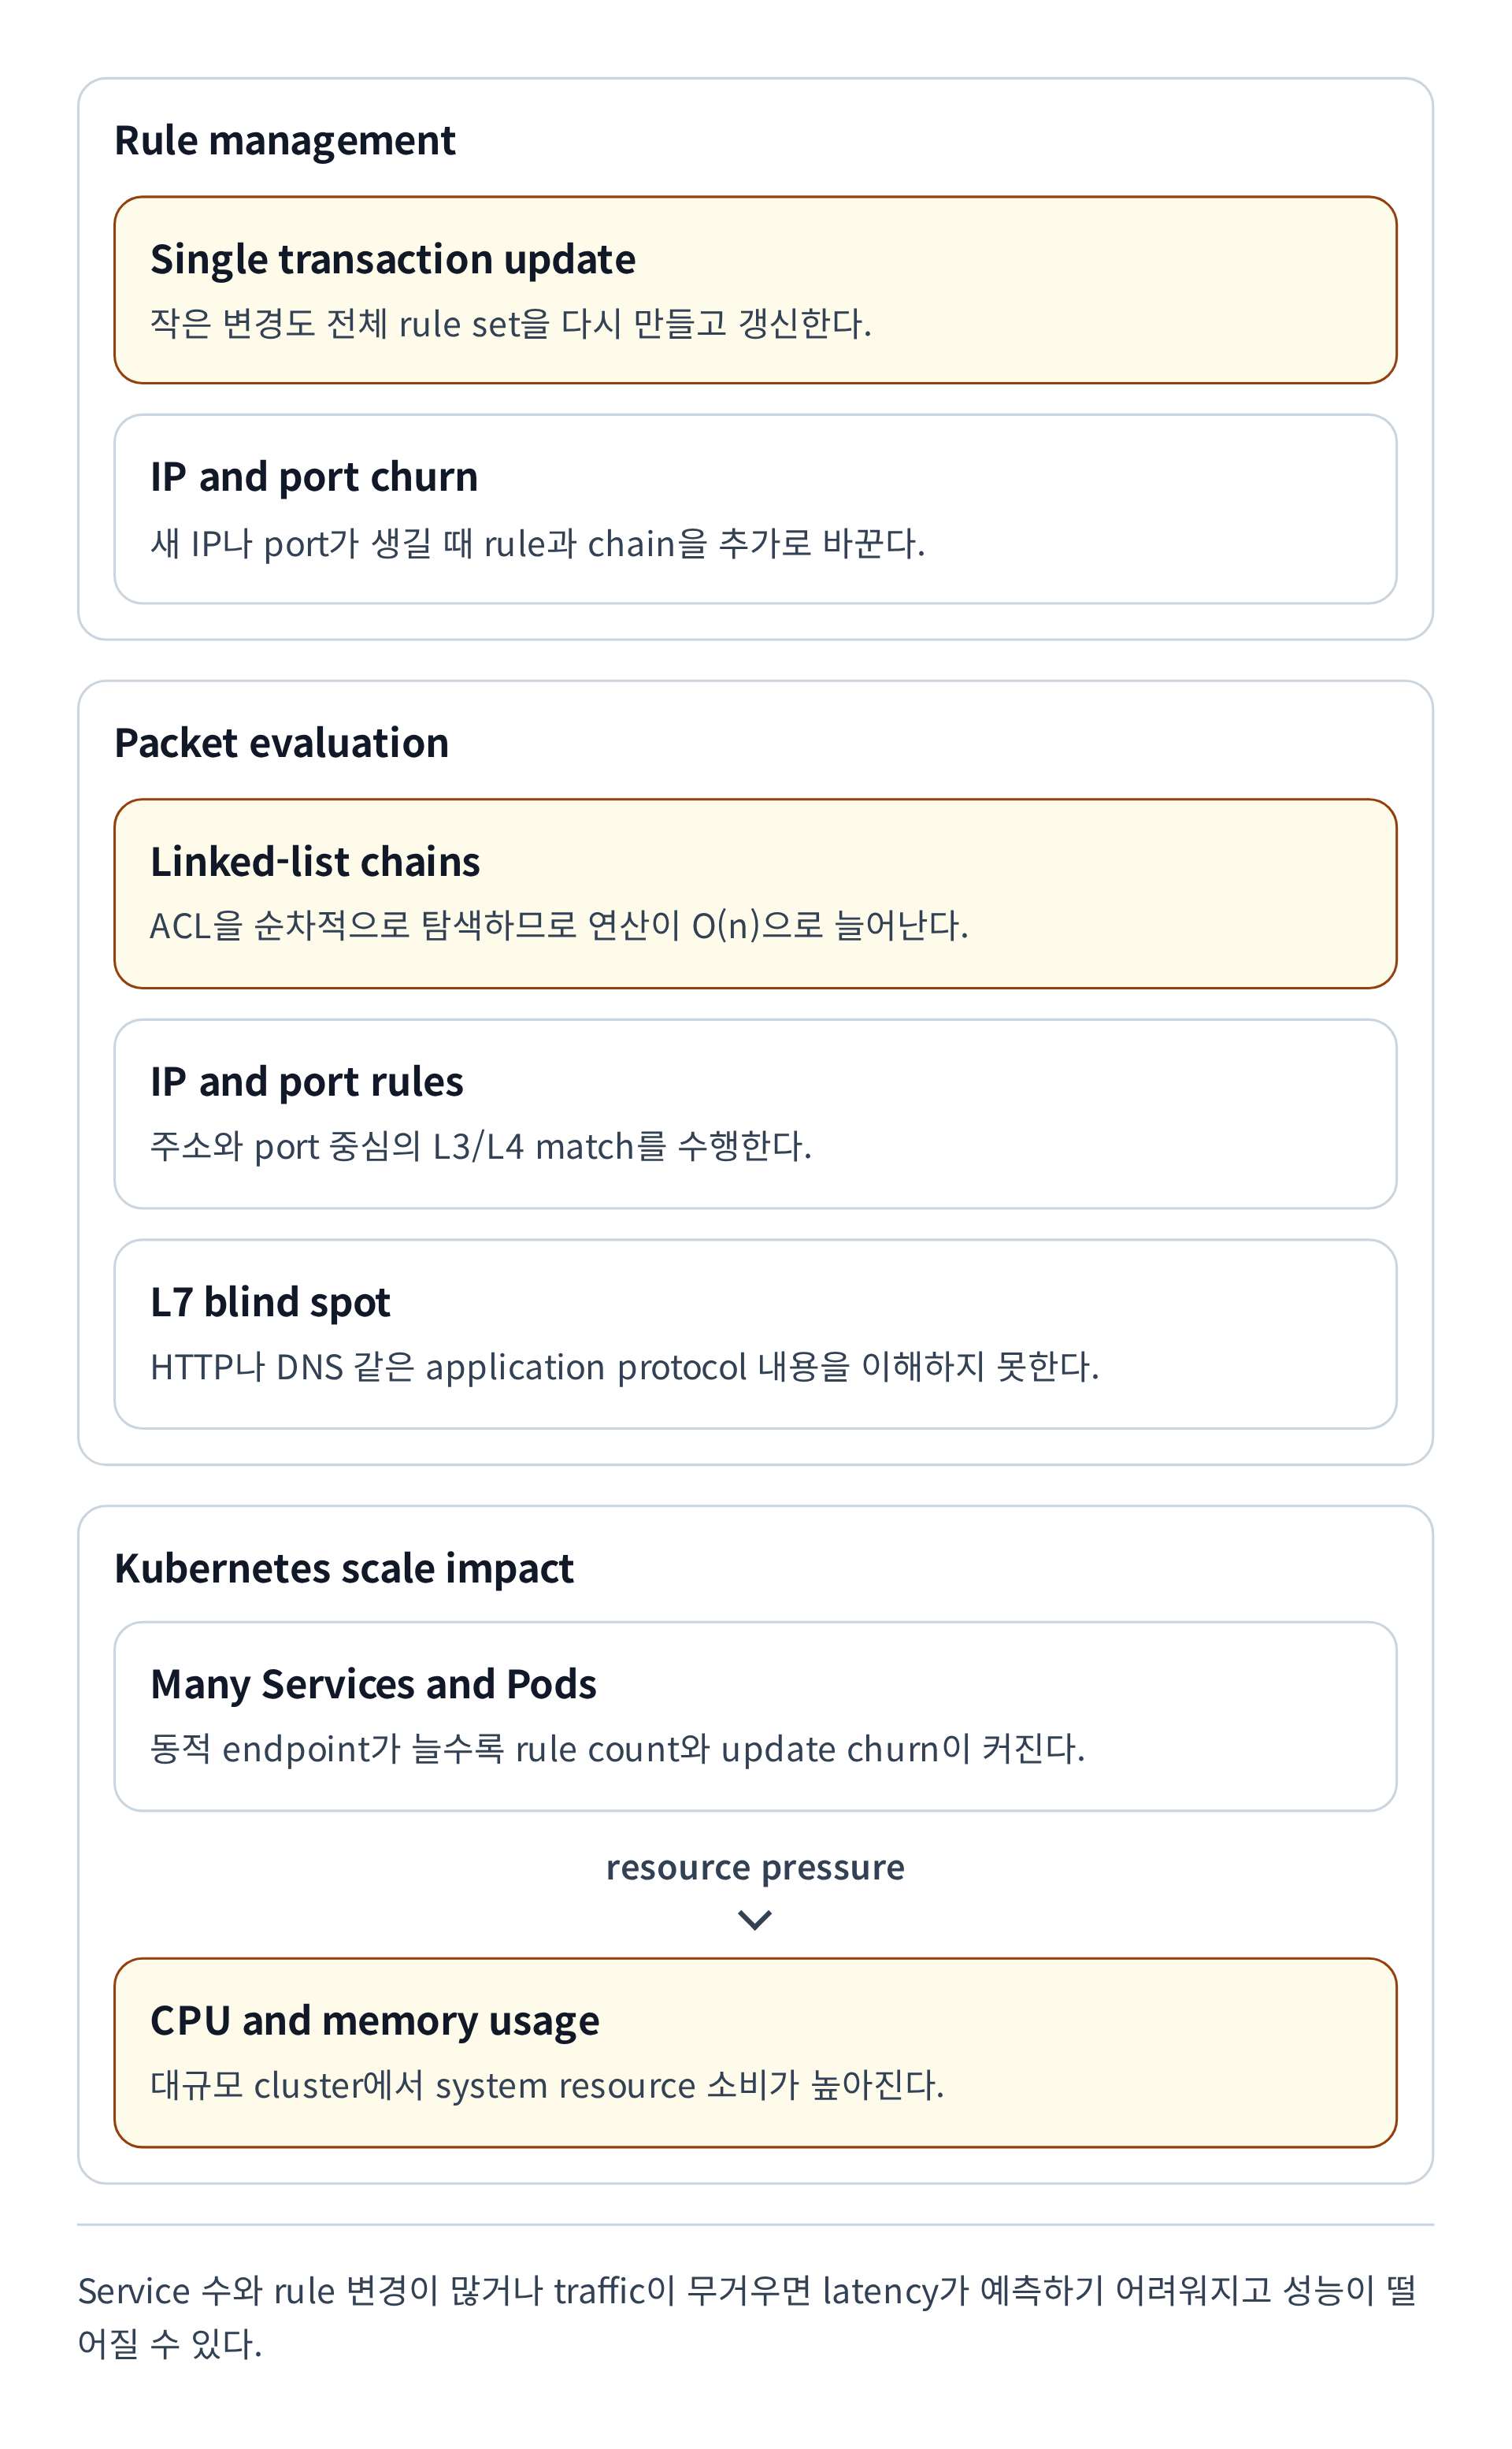
- 단일 트랜잭션으로 모든 규칙 업데이트 필요: iptables의 규칙을 업데이트할 때는 모든 규칙을 처음부터 다시 만들고 업데이트해야 하는 ‘단일 트랜잭션’ 방식을 따릅니다. 이는 하나의 작은 규칙을 변경하더라도 전체 규칙 세트를 재구성해야 함을 의미하며, 규칙이 많아질수록 비효율성이 커집니다.
- 연결 리스트(Linked List)로 구현된 규칙 체인, 모든 연산은 O(n): iptables는 규칙 체인(chains of rules)을 ‘연결 리스트’ 형태로 구현합니다. 연결 리스트의 특성상, 어떤 특정 규칙을 찾거나 적용하기 위해서는 목록의 처음부터 순차적으로 탐색해야 합니다. 이로 인해 모든 연산(예: 규칙 추가, 삭제, 조회, 매칭)은 규칙의 수(n)에 비례하는 시간 복잡도 O(n)를 가집니다. 규칙의 수가 많아질수록 성능 저하가 심해집니다.
- 접근 제어 목록(ACLs) 구현의 표준 관행은 순차적 규칙 목록: iptables가 구현하는 접근 제어 목록(ACLs)의 일반적인 방식은 규칙들을 순차적으로 나열하는 것입니다. 이는 위에서 언급된 O(n) 탐색 문제를 더욱 부각시킵니다.
- IP 및 포트 매칭 기반, L7(애플리케이션 계층) 프로토콜에 대한 인지 부족: iptables는 주로 패킷의 IP 주소와 포트 번호를 기반으로 규칙을 적용합니다. 이는 네트워크 계층(L3) 및 전송 계층(L4)에서 효과적이지만, HTTP, DNS 등과 같은 애플리케이션 계층(L7) 프로토콜의 내용을 이해하거나 이에 기반한 정교한 규칙을 적용하는 데는 한계가 있습니다. 최신 애플리케이션 환경에서는 L7 수준의 트래픽 제어가 중요해지고 있습니다.
- 새로운 IP 또는 포트 매칭 시 규칙 추가 및 체인 변경 필요: 네트워크 환경에 새로운 IP 주소나 포트가 추가되거나 변경될 때마다 해당 변경 사항을 처리하기 위해 새로운 iptables 규칙을 추가하고 기존 규칙 체인을 수정해야 합니다. 이는 동적으로 변화하는 클라우드 환경이나 컨테이너 환경에서 관리 복잡성과 오버헤드를 증가시킵니다.
- Kubernetes에서 높은 자원 소모: Kubernetes와 같은 컨테이너 오케스트레이션 환경에서는 수많은 서비스와 파드(Pod)가 동적으로 생성되고 삭제됩니다. 각 서비스와 네트워크 정책은 iptables 규칙으로 변환되는데, 이 과정에서 iptables는 시스템 자원(CPU, 메모리)을 많이 소모하게 됩니다. 이는 특히 대규모 클러스터에서 성능 병목 현상을 유발할 수 있습니다.
4. eBPF(extended Berkeley Packet Filter) 개념과 장점
eBPF는 리눅스 Kernel의 소스 코드를 변경하거나 Kernel 모듈을 로드하지 않고도, Sandboxed 환경에서 프로그램을 실행할 수 있게 하는 혁신적인 기술입니다. Kernel 위에서 동작하는 작은 가상 머신으로 비유할 수 있으며, 이를 통해 네트워킹, 보안, 성능 모니터링 등 Kernel의 기능을 안전하고 유연하게 확장할 수 있습니다.
가장 큰 장점은 압도적인 성능과 높은 프로그래밍 유연성입니다. 특히 복잡한 규칙으로 성능 저하가 발생하는 기존 iptables 방식의 한계를 극복하는 차세대 네트워킹 기술로 주목받고 있습니다.
eBPF는 기존 계층을 없애지 않고 Syscall, TCP/IP, Network Device 같은 선택 지점에 attach되어 policy 적용과 관측을 수행합니다.
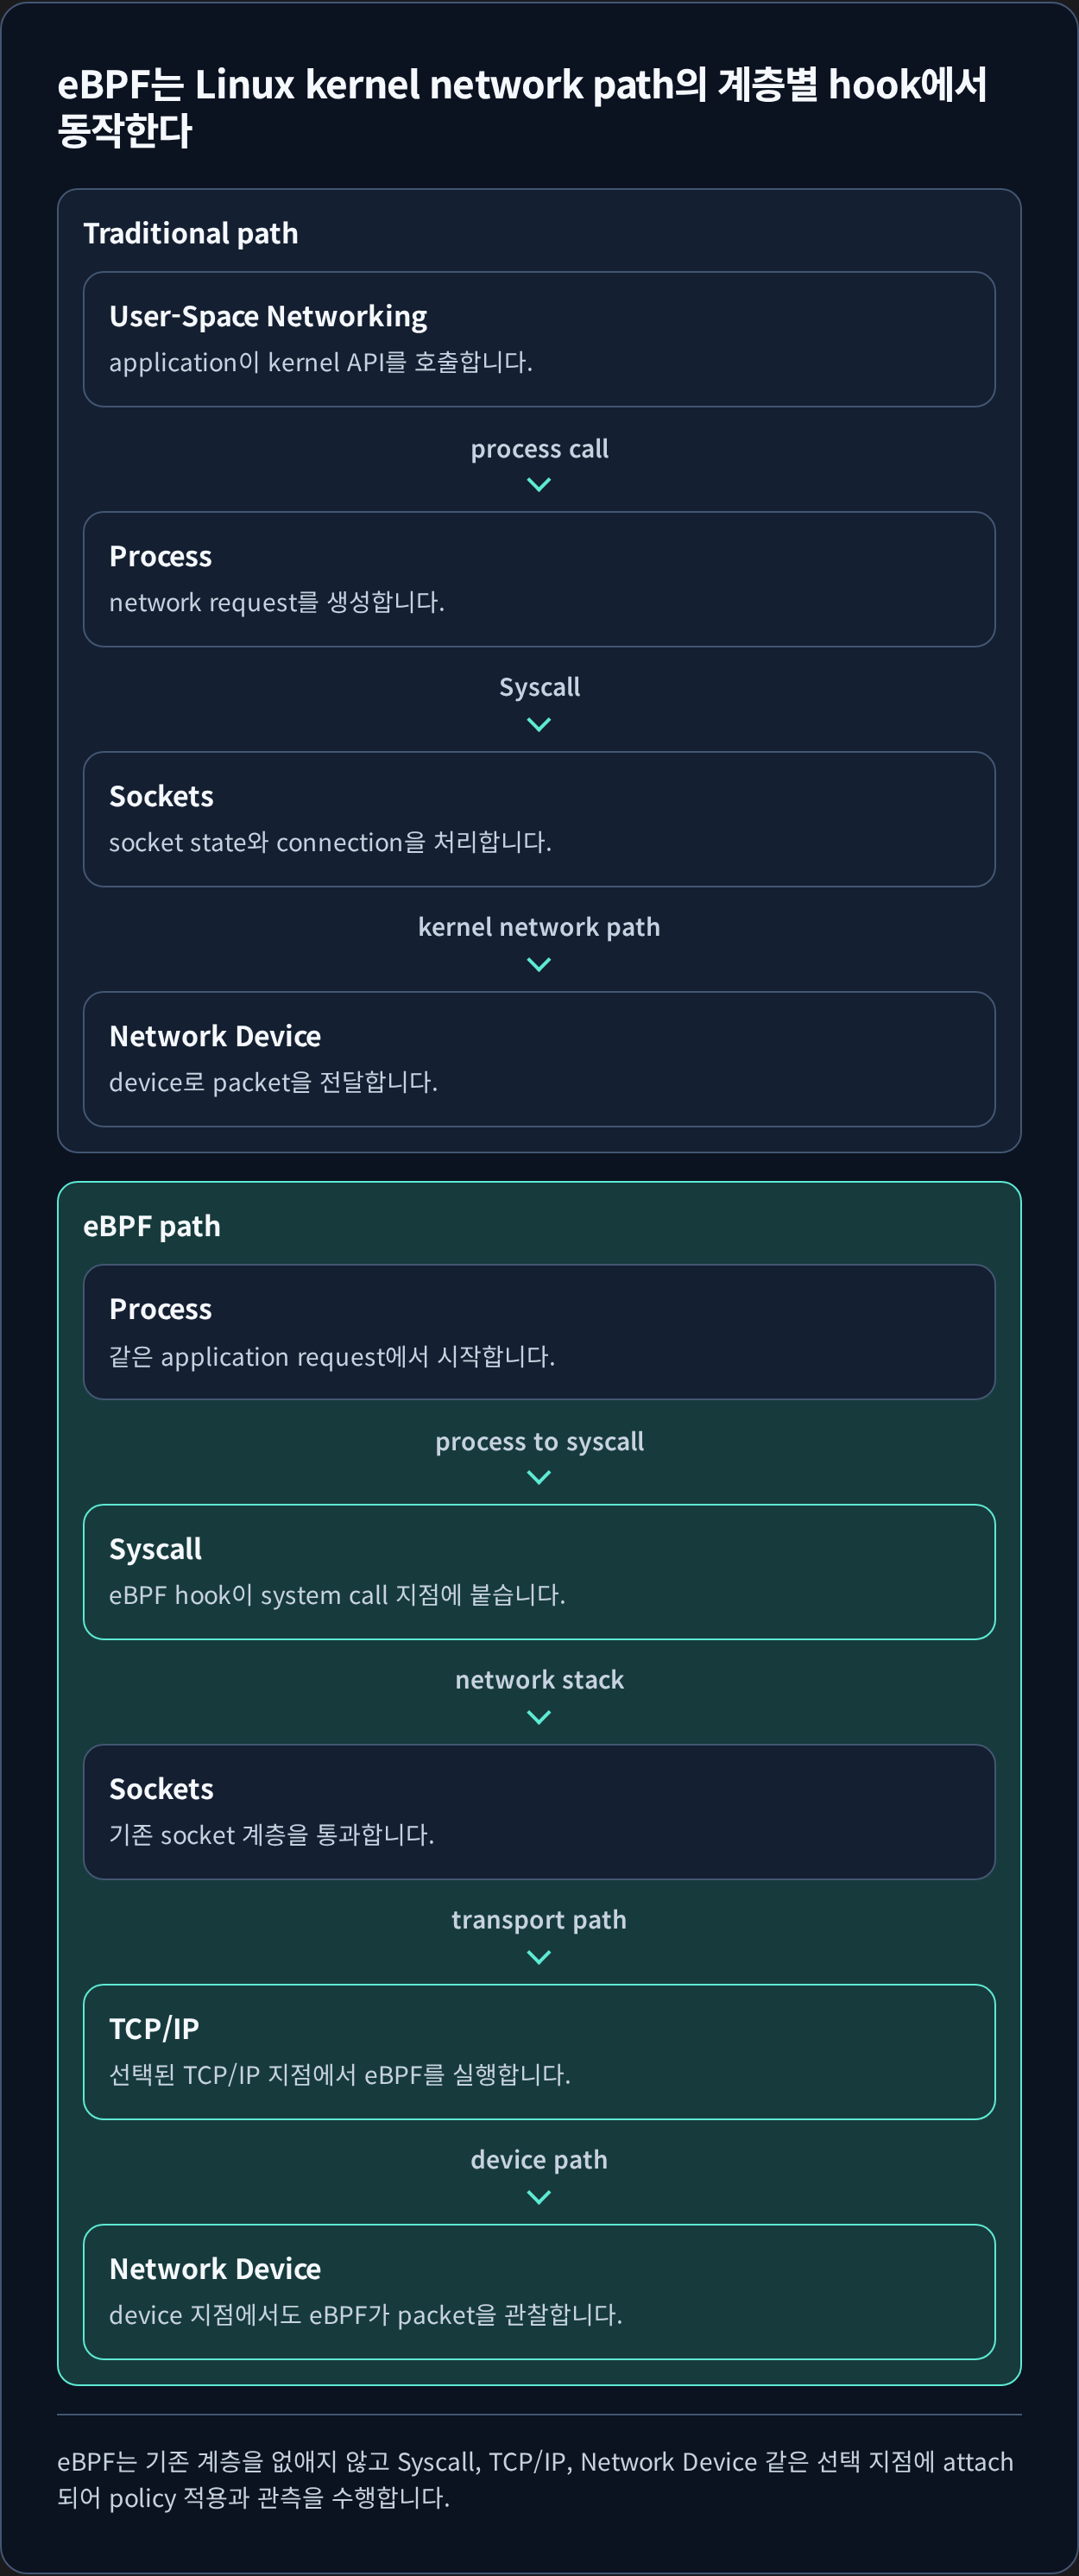
| Attachment layer | eBPF hook |
|---|---|
| System Call Interface | Syscall tracing hookstracepoints / kprobes로 syscall 이벤트를 관찰합니다. |
| Sockets | BPF Sockmap and Sockopssocket 경로와 connection 동작에 개입합니다. |
| cgroup boundary | BPF cGroupscgroup 기준으로 network policy를 적용합니다. |
| Traffic Shaping | BPF TC hooksTC 계층에서 packet을 처리합니다. |
| Netdevice / Drivers | BPF XDPdevice와 driver에 가까운 지점입니다. |
각 hook은 독립된 attachment 위치이며 순차 실행 단계가 아닙니다. bpf()는 program 로드와 map 조작을 위한 별도 제어 API이지 packet 처리 hook이 아닙니다.
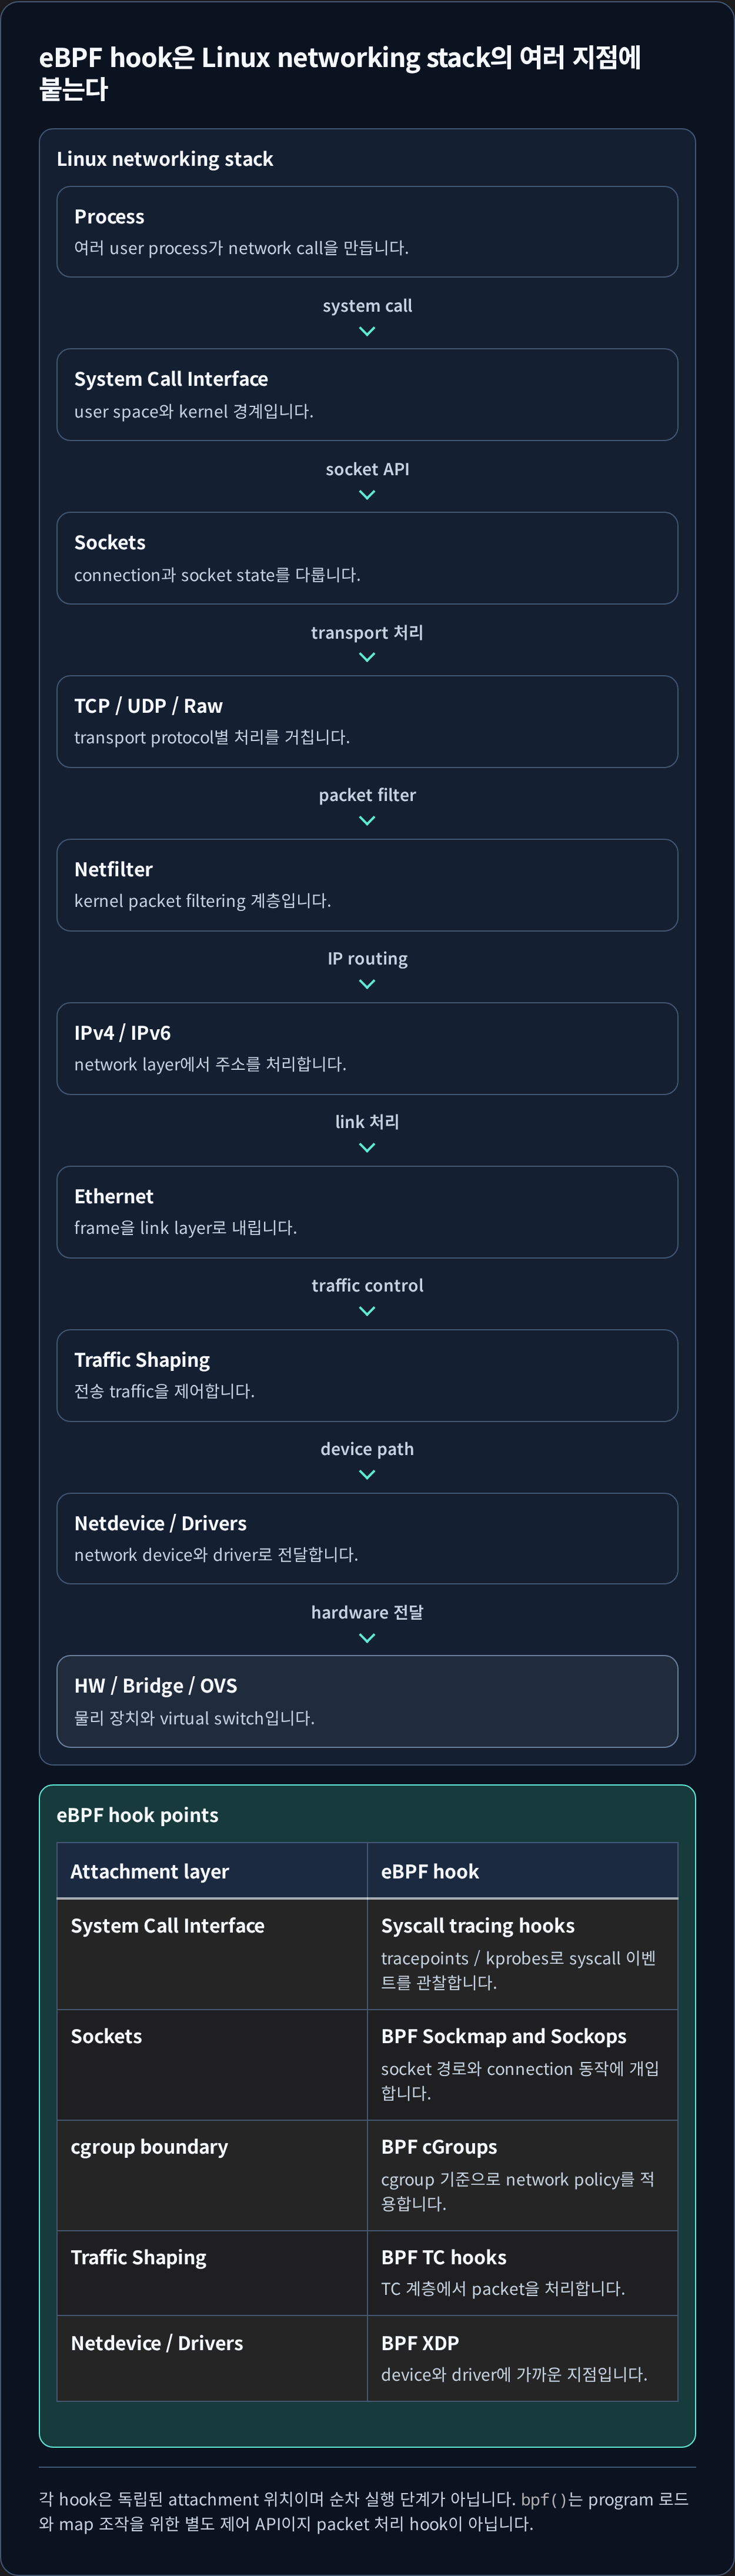
두 lane 모두 Pod 안의 process와 socket에서 시작합니다. 차이는 host 쪽의 forwarding, NAT와 rule traversal을 누가 맡는지입니다.
FORWARD, POSTROUTING, PREROUTING의 mangle와 nat를 통과합니다.많은 rule lookup과 context switch가 host path의 iptables overhead를 만듭니다.
Cilium은 host iptables forwarding과 NAT traversal을 크게 줄이며, Pod-side hook은 남을 수 있습니다.
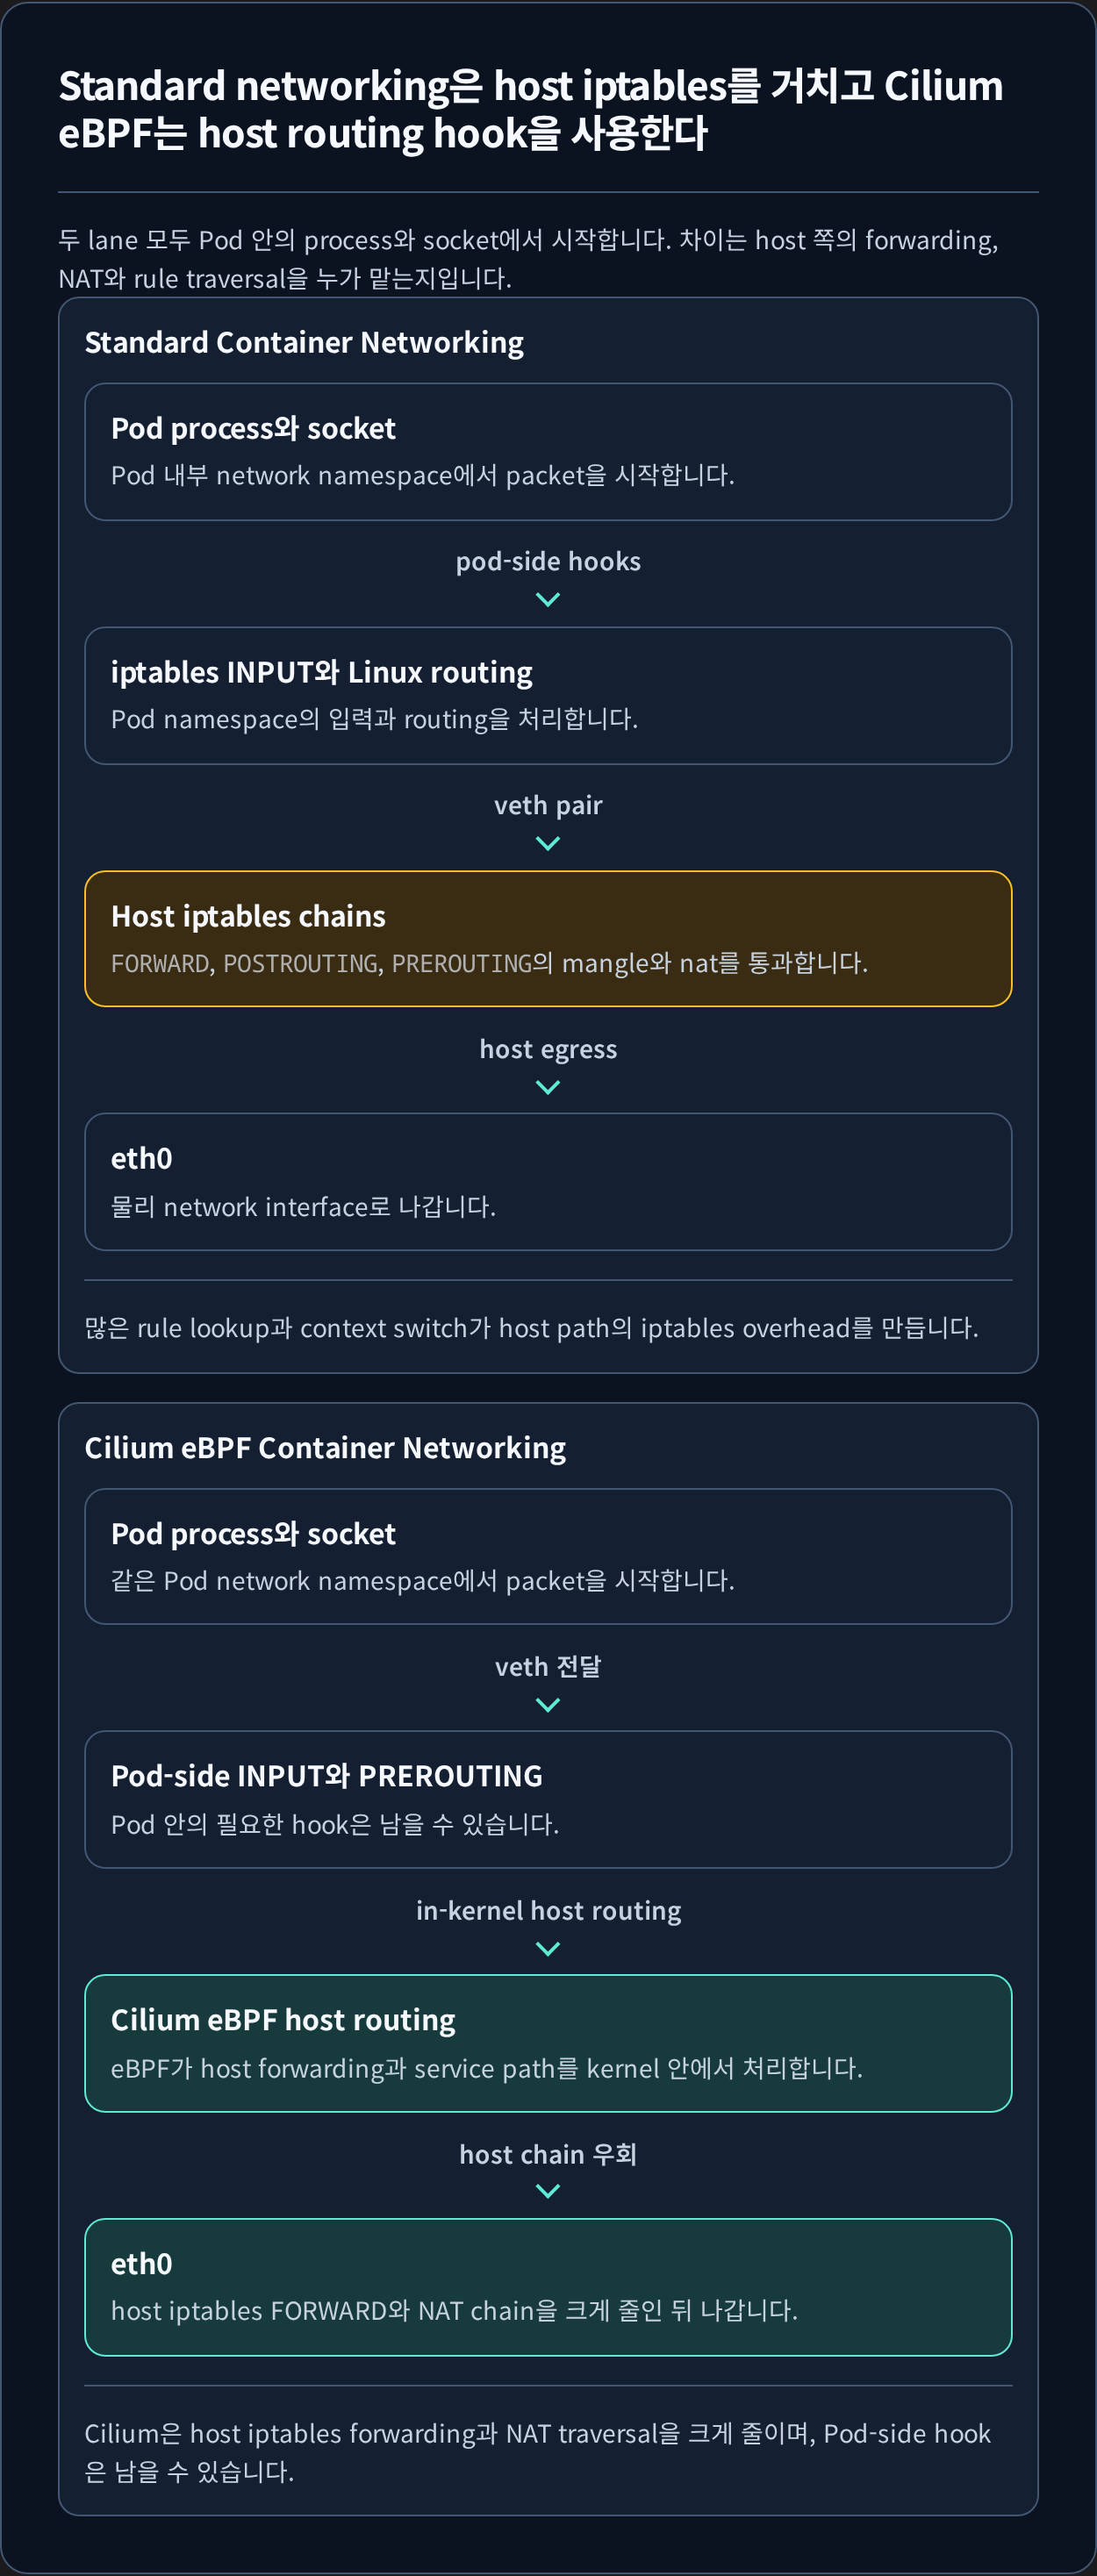
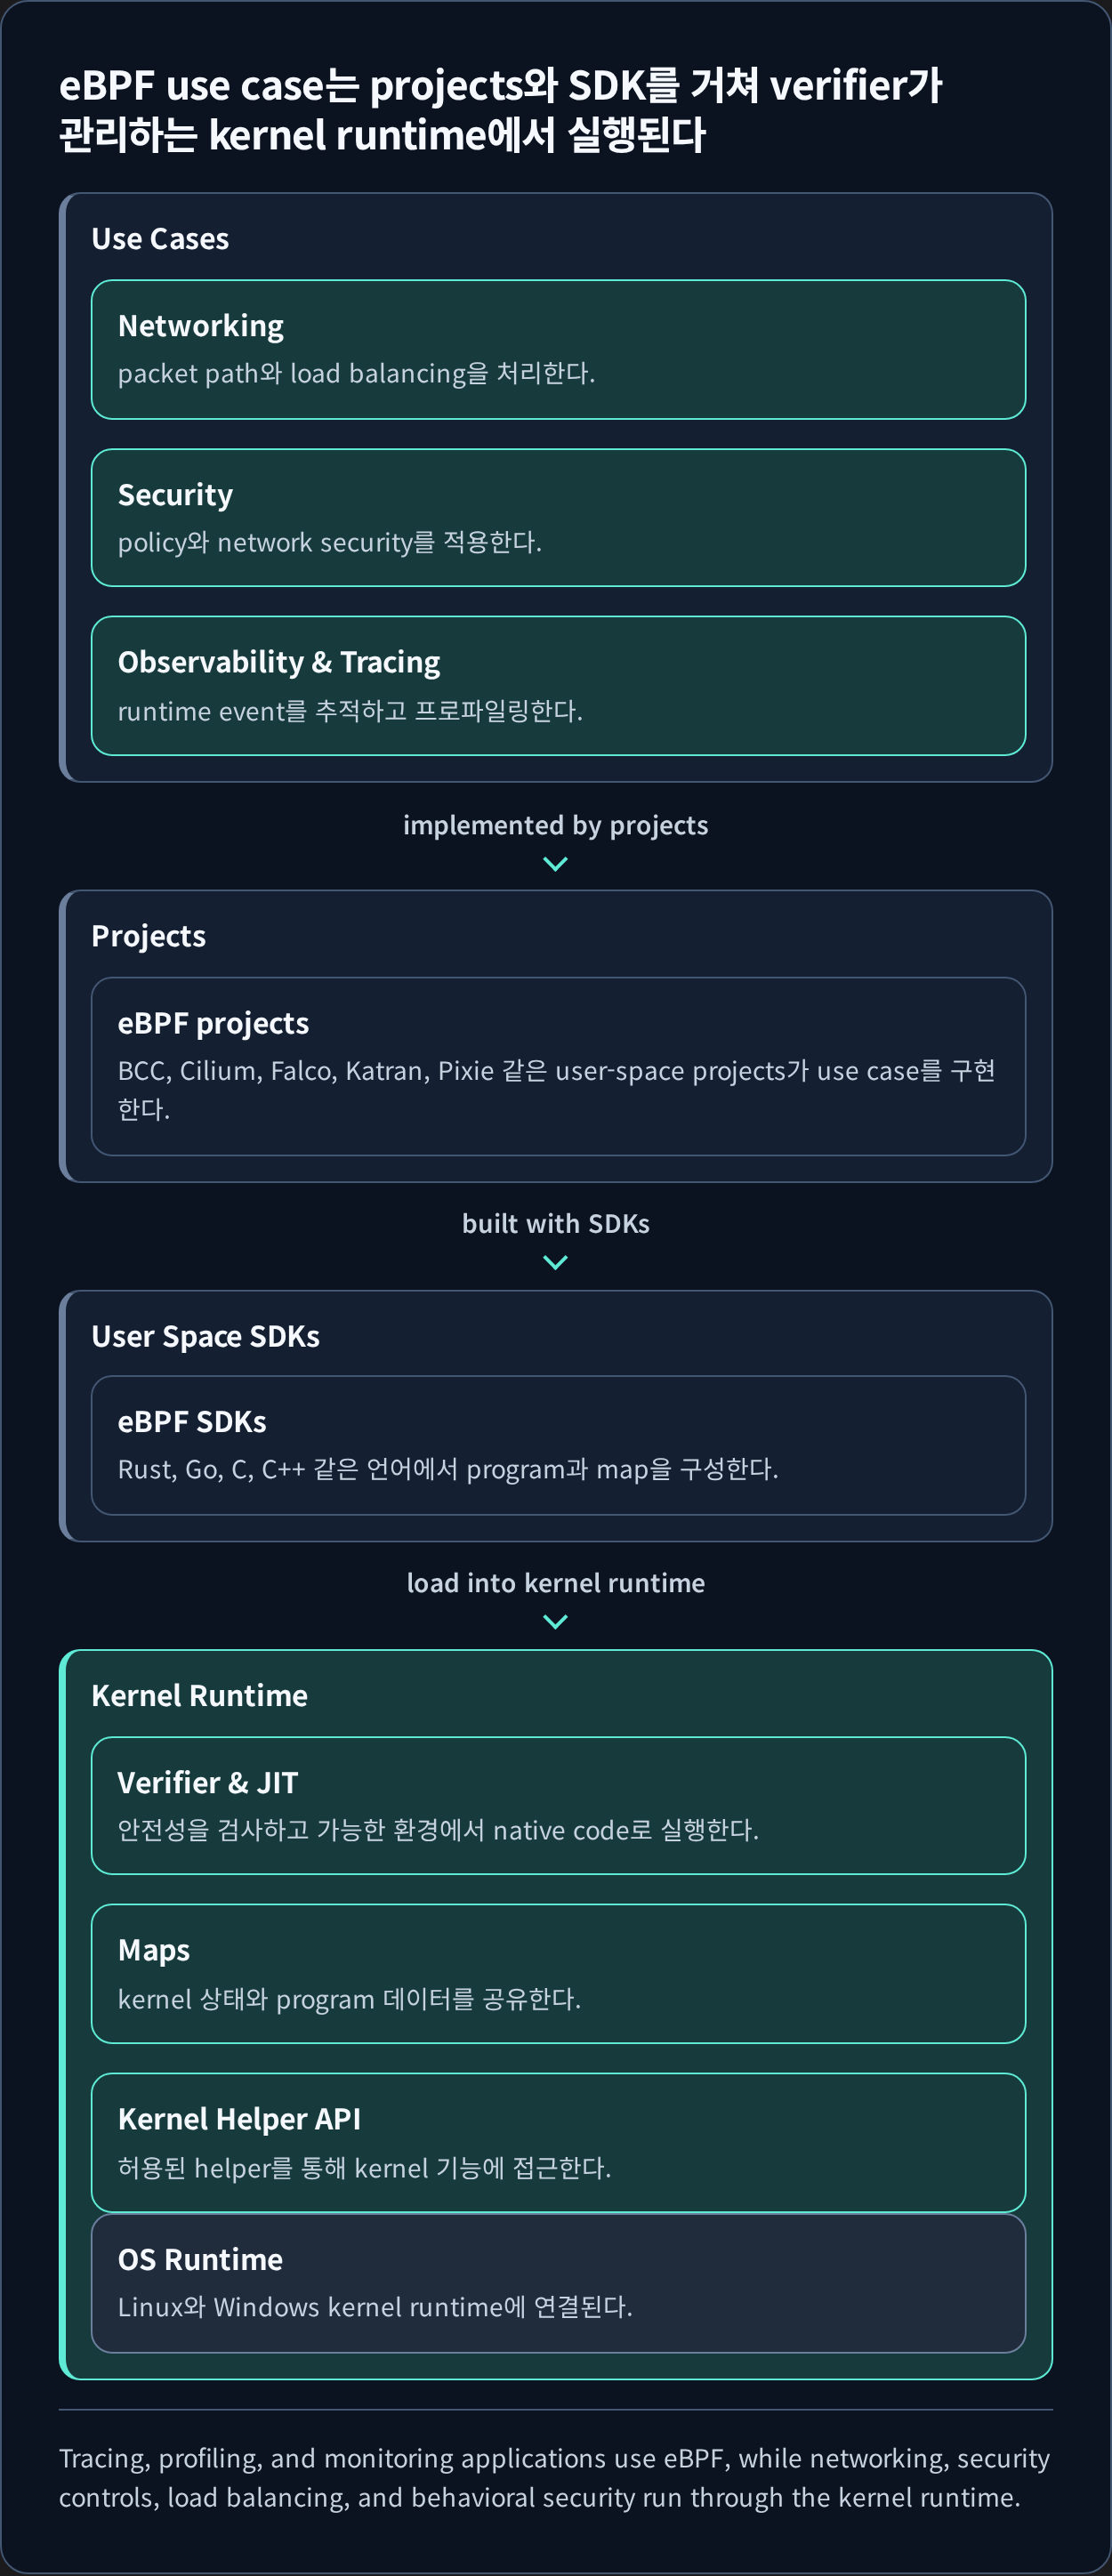
네 영역은 같은 이름의 단일 pipeline이 아니라, 요구에 맞는 process와 kernel hook을 선택해 기능을 붙이는 사용 사례입니다.
Tracing, profiling, and monitoring applications use eBPF, while networking, security controls, load balancing, and behavioral security run through the kernel runtime.
4.1. 장점 1. 커널 내 고성능 네트워킹 및 실행
- eBPF 프로그램은 JIT(Just-In-Time) 컴파일러를 통해 네이티브에 가까운 속도로 커널 내에서 직접 실행됩니다. 이를 통해 기존 iptables 기반 솔루션의 오버헤드를 줄이고 획기적인 처리 성능 향상과 저지연 시간을 달성합니다.
- kube-proxy를 대체하여 커널 레벨에서 효율적인 로드 밸런싱을 제공하며, 복잡한 iptables 체인을 거치지 않고 패킷을 직접 필터링하여 네트워킹 성능을 최적화합니다.
4.2. 장점 2. 강화된 보안 (Security)
- ID 기반 보안 모델: IP 주소 대신 컨테이너/Pod의 ID를 기반으로 정책을 적용하여 마이크로 서비스 간의 통신을 더욱 세밀하게 제어합니다. 이는 “제로 트러스트(Zero Trust)” 보안 모델 구현에 필수적입니다.
- 레이어 7(L7) 정책 강제: HTTP, gRPC, Kafka 등 애플리케이션 계층(L7) 프로토콜을 이해하고 이에 기반한 네트워크 정책을 적용할 수 있습니다. 예를 들어, 특정 HTTP 경로 또는 메서드에 대한 접근을 제어할 수 있어 API 및 마이크로 서비스 보안에 이상적입니다.
- 세분화된 네트워크 정책: Kubernetes NetworkPolicy를 확장하여 더욱 정교한 네트워크 격리 및 접근 제어를 가능하게 합니다.
- Sidecar-Free 보안: 전통적인 서비스 메시에서 보안 기능을 위해 필요한 사이드카 프록시 없이 커널 레벨에서 보안 정책을 강제함으로써, 리소스 사용량을 줄이고 복잡성을 낮춥니다.
4.3. 장점 3. 깊은 가시성 (Observability)
- Hubble을 통한 실시간 가시성: Cilium의 가시성 툴인 Hubble은 eBPF를 통해 네트워크 흐름에 대한 상세한 정보를 실시간으로 수집하고 시각화합니다.
- 애플리케이션 레벨(L7) 통찰: HTTP 요청 헤더, DNS 쿼리 등 애플리케이션 계층 데이터를 포함한 네트워크 이벤트를 심층적으로 모니터링하여 문제 해결 및 성능 분석에 필요한 풍부한 컨텍스트를 제공합니다.
- 낮은 오버헤드: 커널 내에서 직접 데이터를 수집하고 필터링하므로, 기존 방식(예: 사이드카 에이전트) 대비 매우 낮은 오버헤드로 광범위한 가시성 데이터를 얻을 수 있습니다.
4.4. 장점 4. 효율적인 서비스 메시 (Service Mesh) 기능
- Sidecar-Free 아키텍처: eBPF를 통해 서비스 메시 기능을 커널에 직접 통합함으로써, 각 Pod에 사이드카 프록시를 배포할 필요가 없습니다. 이는 리소스 소모를 줄이고, 배포 복잡성을 낮추며, 애플리케이션 성능 저하를 최소화합니다.
- 커널 레벨 통합: 통신 경로를 최적화하고, 컨텍스트 스위칭 및 데이터 복사 오버헤드를 줄여 서비스 메시의 효율성을 극대화합니다.
- 로드 밸런싱 및 트래픽 관리: L4/L7 로드 밸런싱, 트래픽 분할, 회로 차단(Circuit Breaking) 등 서비스 메시의 핵심 기능을 효율적으로 제공합니다.
4.5. 장점 5. 뛰어난 확장성 및 유연성
- 동적 기능 확장: 커널의 거의 모든 지점에 훅(Hook)을 걸어 기존 기능을 수정하거나 새로운 기능을 런타임 중에 동적으로 추가 및 확장할 수 있습니다. 이는 OS 기능을 유연하게 변경하고 사용자 정의 로직을 적용할 수 있음을 의미합니다.
- 대규모 클러스터에 최적화: eBPF의 효율성은 수천 개의 Pod와 서비스가 있는 대규모 Kubernetes Cluster에서도 안정적인 성능을 유지할 수 있도록 합니다. iptables 규칙이 많아질수록 성능이 저하되는 기존 CNI의 한계를 극복합니다.
5. eBPF(extended Berkeley Packet Filter)의 동작방식
eBPF는 Kernel 코드의 특정 지점에 훅(Hook)을 걸어두고, 해당 지점에서 이벤트(예: 네트워크 패킷 수신)가 발생하면 미리 로드해둔 eBPF 프로그램을 실행하는 방식으로 동작합니다. verifier가 프로그램의 안전성을 검사한 뒤 허용된 helper와 map을 통해 Kernel 상태에 접근하며, JIT가 가능한 환경에서는 프로그램을 네이티브 명령으로 변환해 실행합니다. 사전 정의된 훅(Hook)에는 시스템 호출, 함수 진입/종료, Kernel 추적점, 네트워크 이벤트 등이 포함됩니다.
syscall__ret_execve는 event를 만들고 comm_events.perf_submit으로 제출한다. kprobe나 uprobe를 사용하면 다른 hook 지점에도 program을 붙일 수 있다.
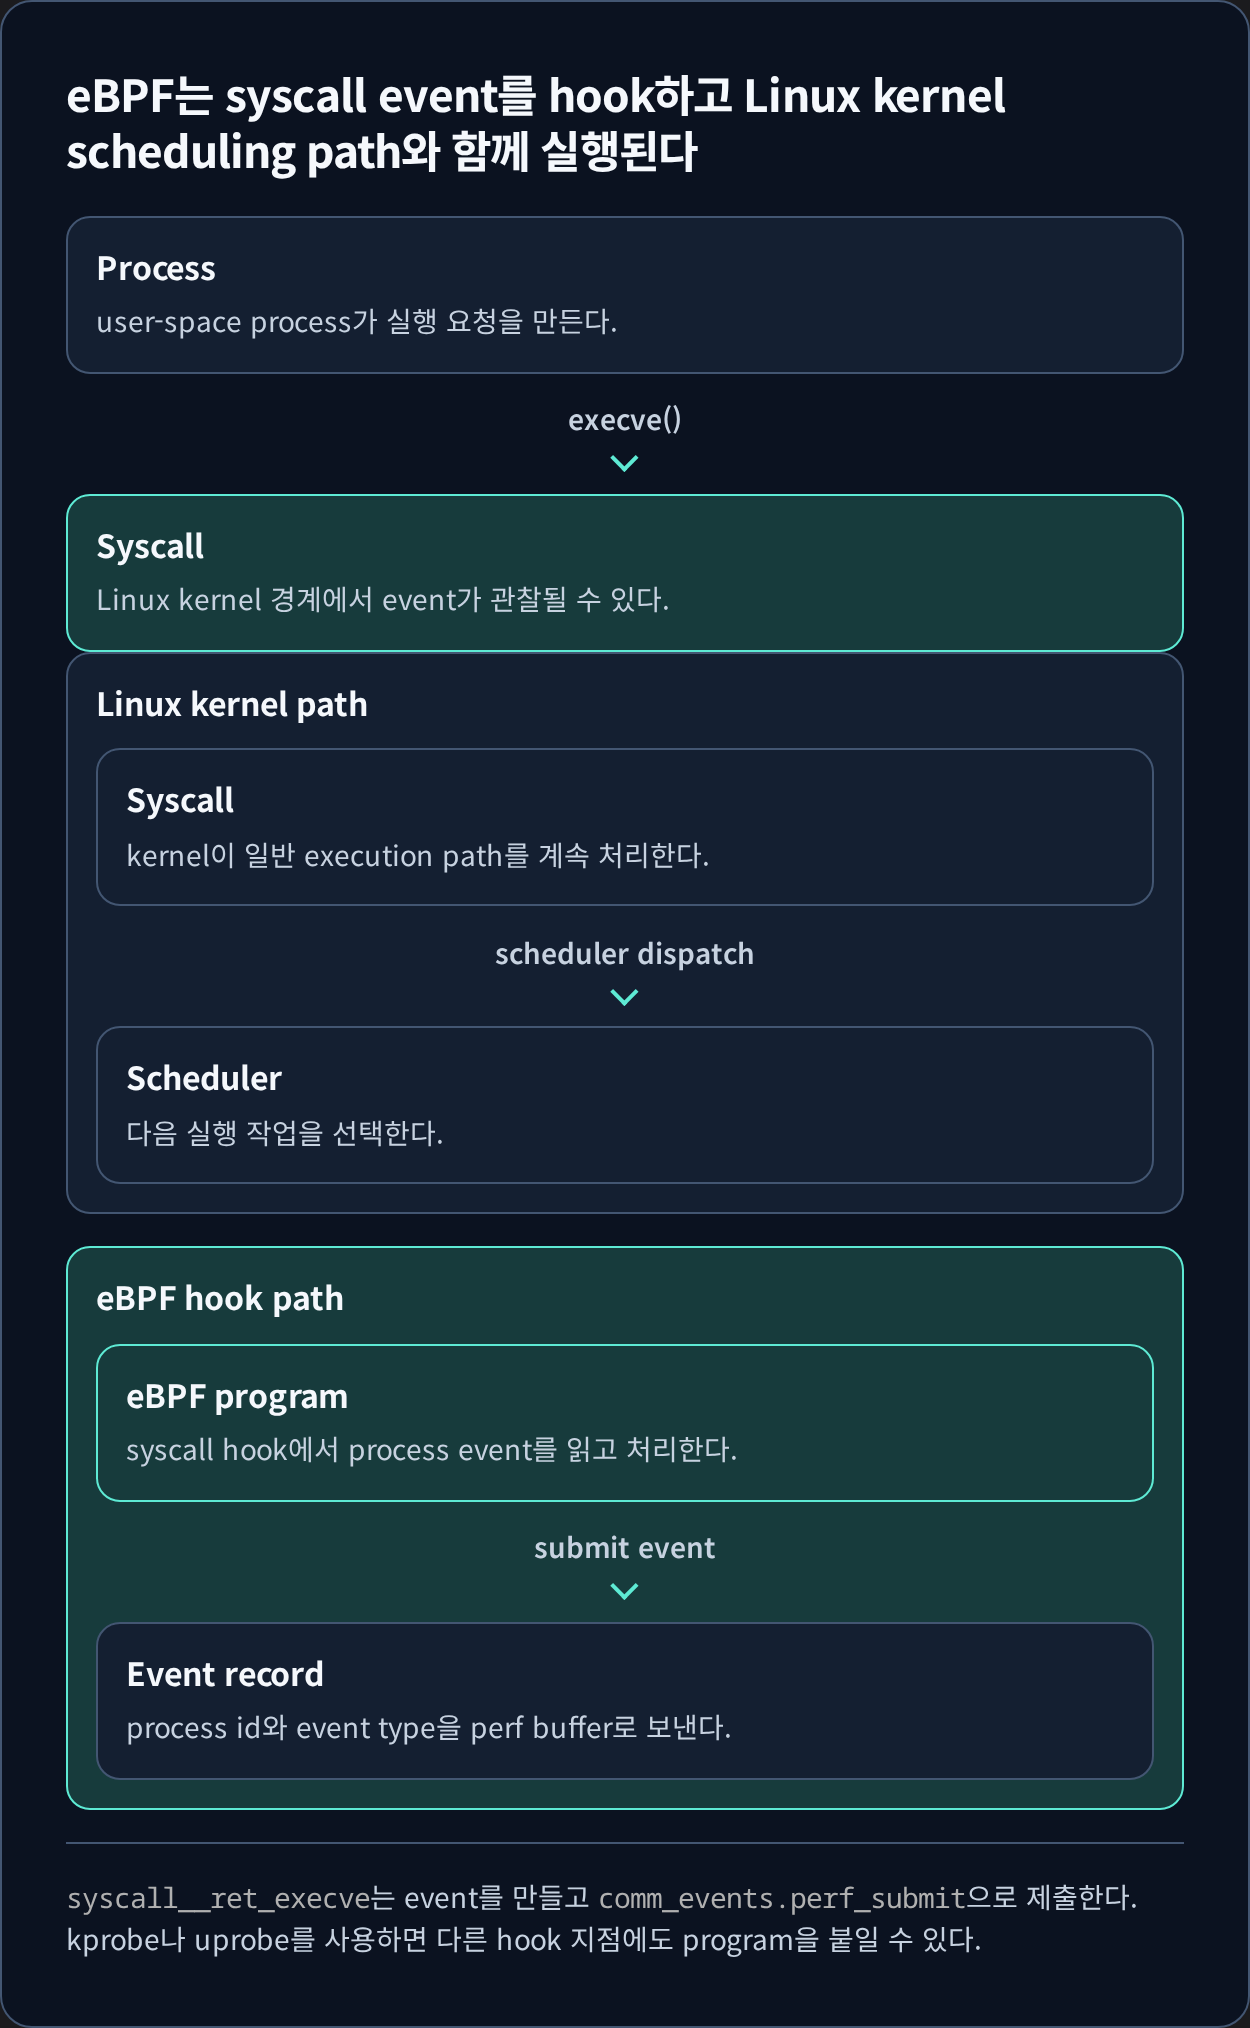
eBPF는 특정 요구 사항에 맞는 사전 정의된 후크가 없는 경우 Kernel 프로브(kprobe)나 사용자 프로브(uprobe)를 만들어 Kernel이나 사용자 애플리케이션의 어느 곳에나 eBPF 프로그램을 첨부할 수 있습니다.
Process는 user space에 있고, Linux Kernel 안의 syscall, VFS, socket, TCP/IP와 device 경계에서 eBPF 프로그램이 실행될 수 있습니다.
write()와 read()를 호출합니다.sendmsg()와 recvmsg()를 호출합니다.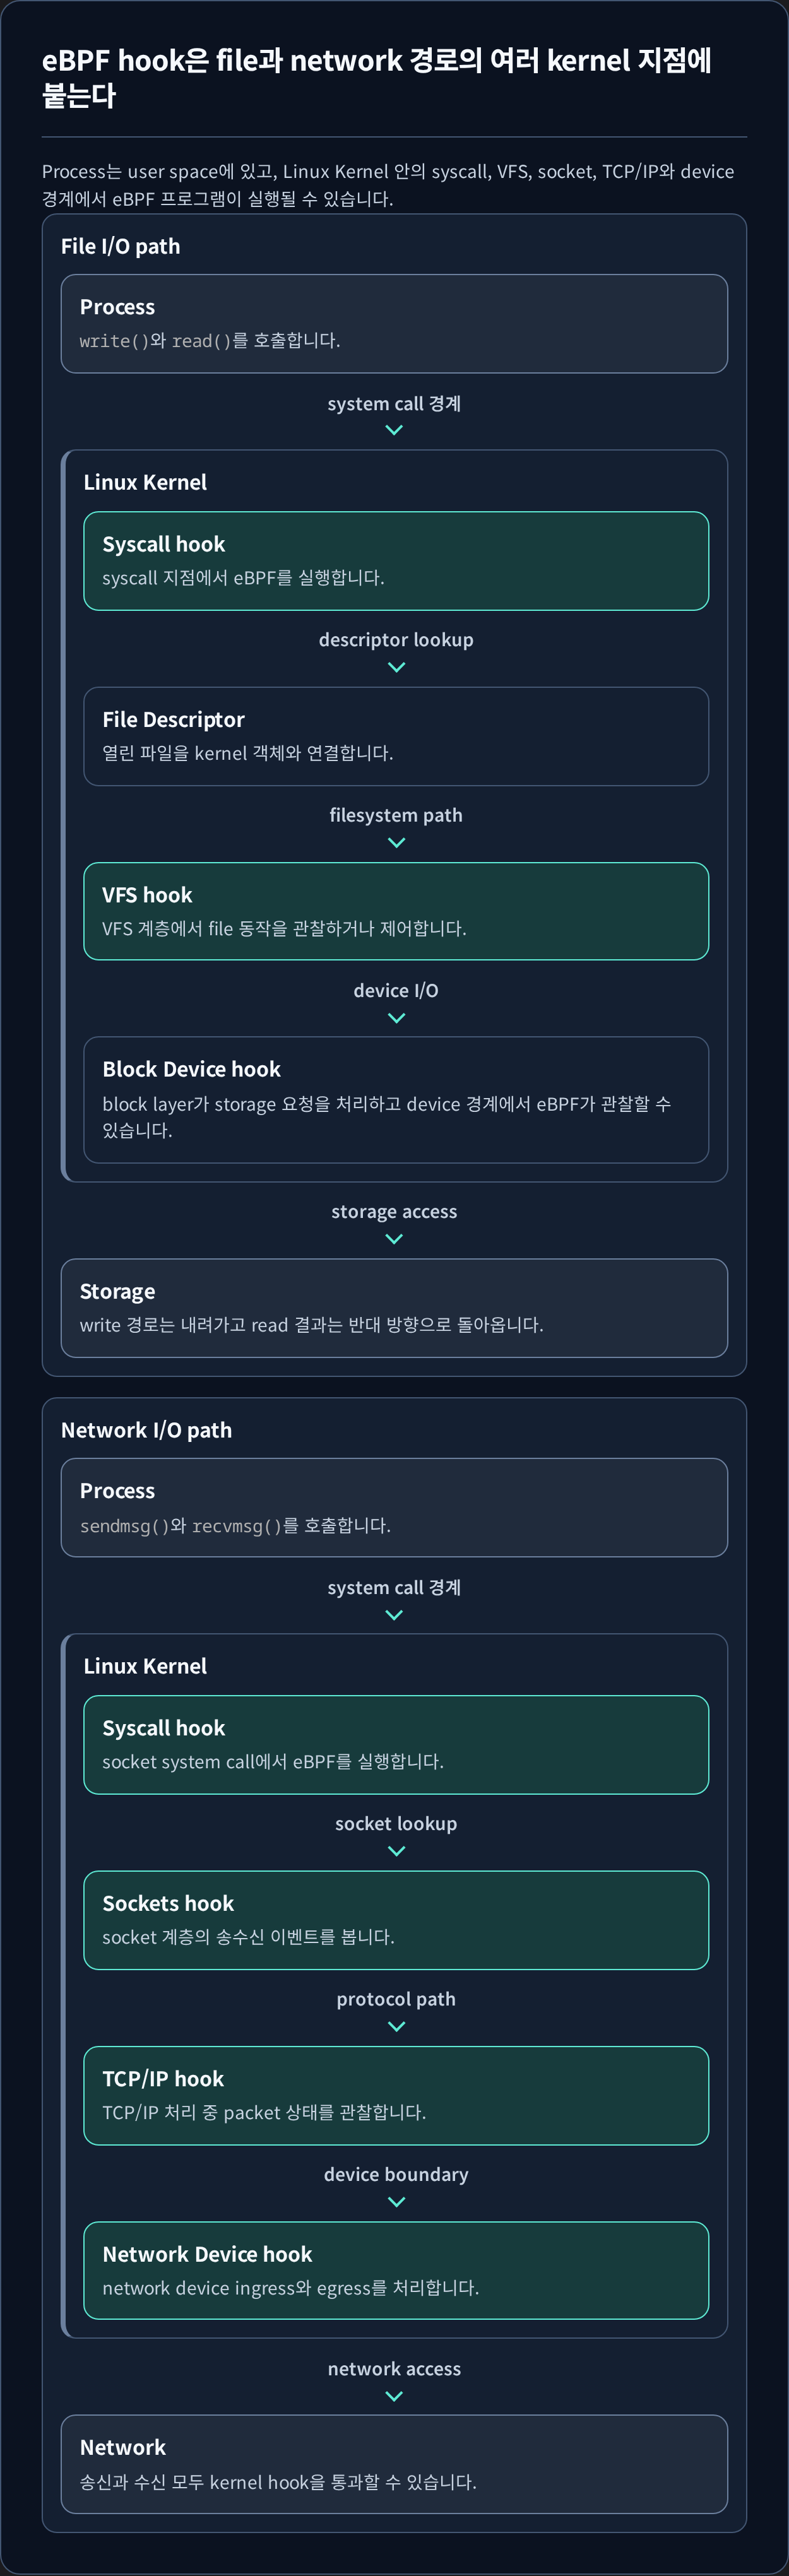
- XDP (eXpress Data Path): 네트워크 드라이버 단에서 가장 먼저 패킷을 처리하여 최고 속도를 보장
- TC (Traffic Control): Kernel의 트래픽 제어 계층에서 패킷을 처리
- Sockets / System Calls: 소켓이나 시스템 콜 레벨에 훅을 걸어 애플리케이션의 동작을 감시하거나 제어할 수 있음
6. Cilium Networking(Routing) Modes
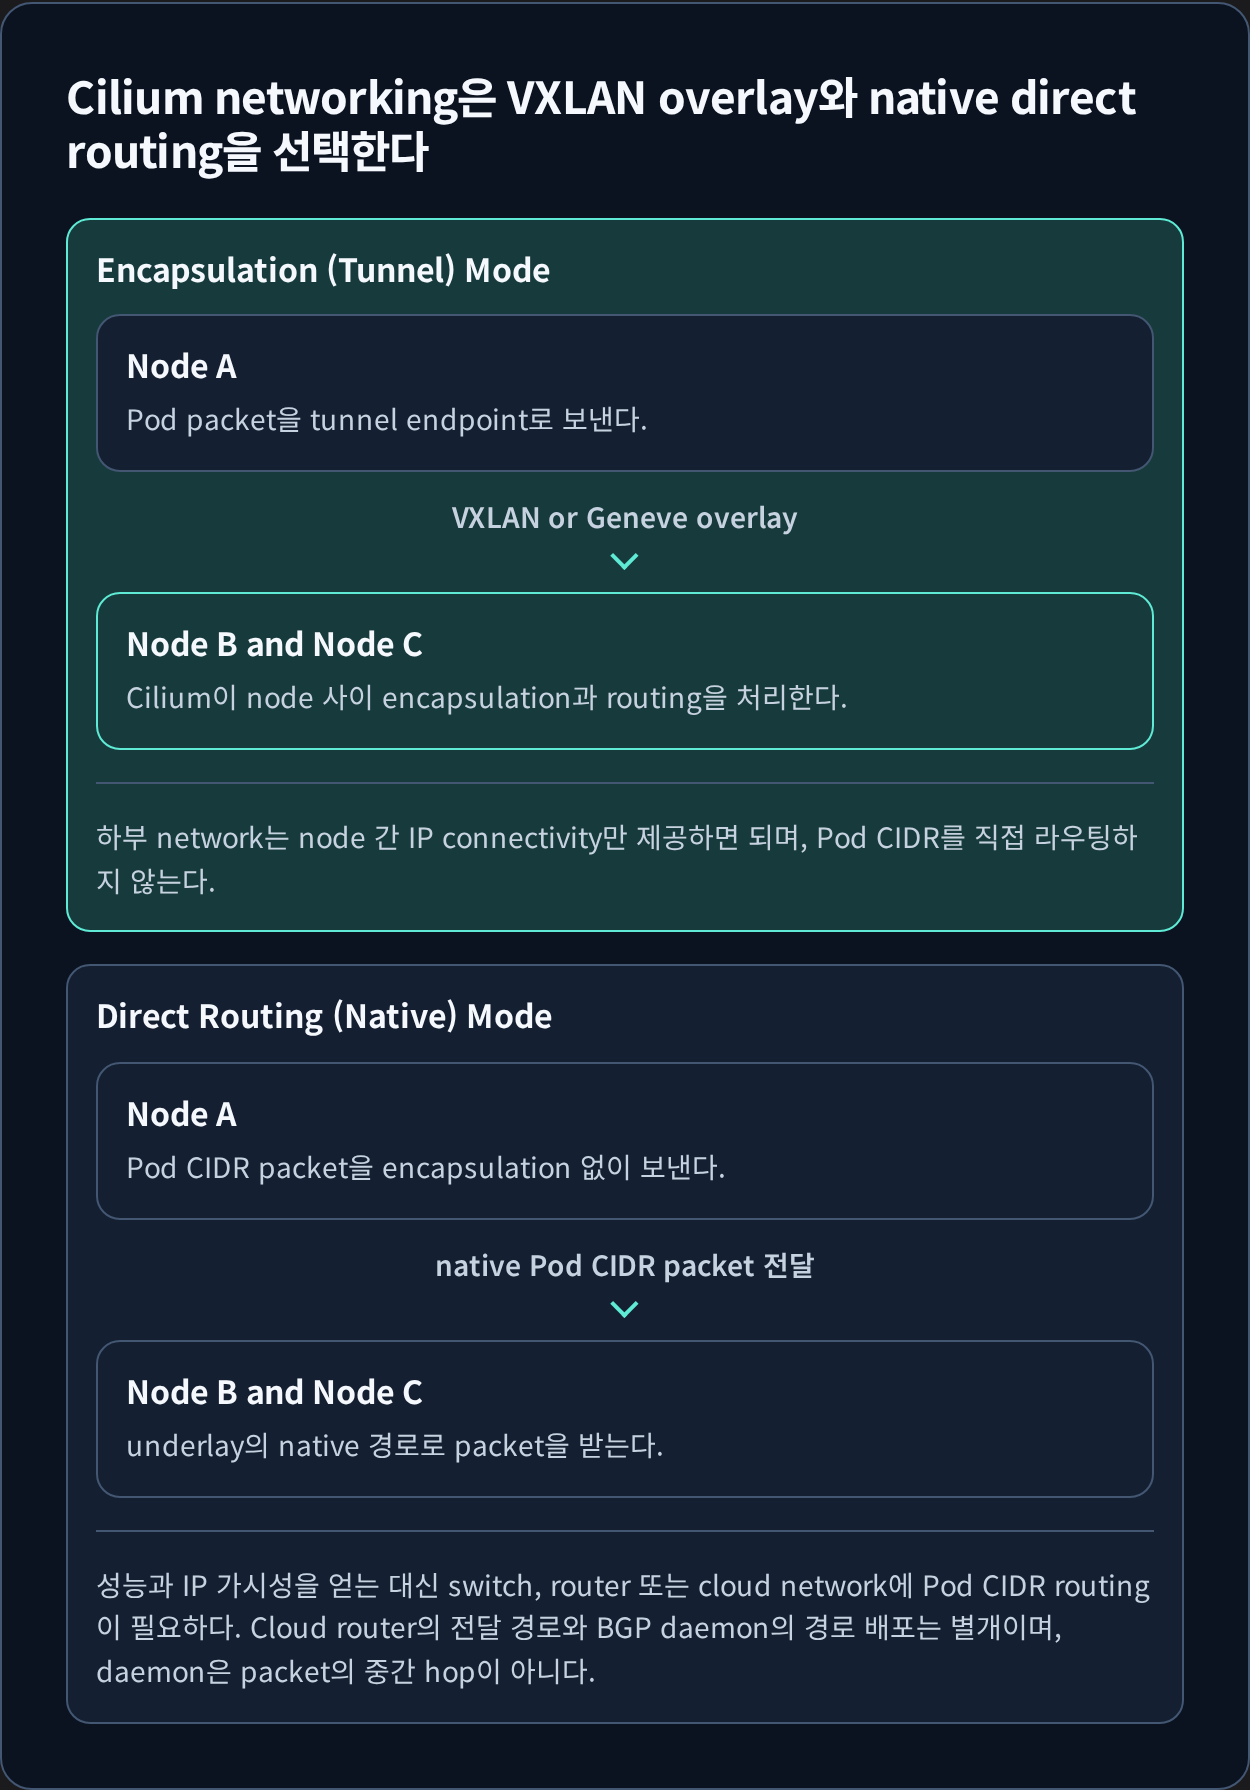
Cilium에는 크게 Encapsulation (Tunnel) Mode와 Direct Routing (Native) Mode가 있습니다.
하부 network는 node 간 IP connectivity만 제공하면 되며, Pod CIDR를 직접 라우팅하지 않는다.
성능과 IP 가시성을 얻는 대신 switch, router 또는 cloud network에 Pod CIDR routing이 필요하다. Cloud router의 전달 경로와 BGP daemon의 경로 배포는 별개이며, daemon은 packet의 중간 hop이 아니다.
6.1. Encapsulation (Tunnel) Mode - VXLAN(Virtual Extensible LAN) / Geneve
모든 클러스터 노드가 UDP 기반 캡슐화 프로토콜인 VXLAN 또는 Geneve를 사용하여 mash of tunnels를 형성해 통신합니다. Cilium 노드 간의 모든 트래픽은 캡슐화됩니다.
| Encapsulation Mode | Port Range / Protocol |
|---|---|
| VXLAN (Default) | 8472 / UDP |
| Geneve | 6081 / UDP |
6.1.1. Encapsulation (Tunnel) Mode의 장점
- Simplicity 물리망이 Pod CIDR를 전혀 알 필요 없으며, 노드 간 IP/UDP 통신만 되면 즉시 동작합니다.
- Addressing space 하부 네트워크 제약에서 자유로워, PodCIDR 크기만 넉넉히 잡으면 노드당 원하는 만큼 Pod를 수용할 수 있습니다.
- Auto-configuration Kubernetes와 같은 오케스트레이션이 노드 정보를 자동 전달하므로, 새 노드가 클러스터에 합류하면 터널 메시에 즉시 편입됩니다.
- Identity context 캡슐화 헤더에 소스 Security Identity 등을 함께 실어 보내므로, 원격 노드에서의 추가 ID 조회가 생략되어 성능을 최적화합니다.
6.1.2. Encapsulation (Tunnel) Mode의 단점
- MTU Overhead VXLAN 기준 패킷당 약 50 바이트의 헤더가 추가되어 실질 MTU가 줄어듭니다. 일반 1500-byte MTU 환경에서는 대역폭 손실이 발생할 수 있으며, 이를 완화하려면 점보 프레임(예: 9000 MTU)을 사용해야 합니다.
6.2. Direct Routing (Native) Mode
캡슐화 없이 각 노드의 eBPF datapath가 패킷을 처리하고, 물리 네트워크가 원격 Pod CIDR를 라우팅해야 합니다.
10.10.10.1/32 via lxc1, 10.10.10.2/32 via lxc210.10.10.0/24 local, 10.10.20.0/24 via 192.168.1.210.10.20.1/32 via lxc1, 10.10.20.2/32 via lxc210.10.20.0/24 local, 10.10.10.0/24 via 192.168.1.1Native mode의 전제는 노드와 cloud network가 서로의 Pod CIDR를 알고 전달하는 것입니다. 이 경로가 없으면 tunnel mode처럼 캡슐화할 수 없습니다.
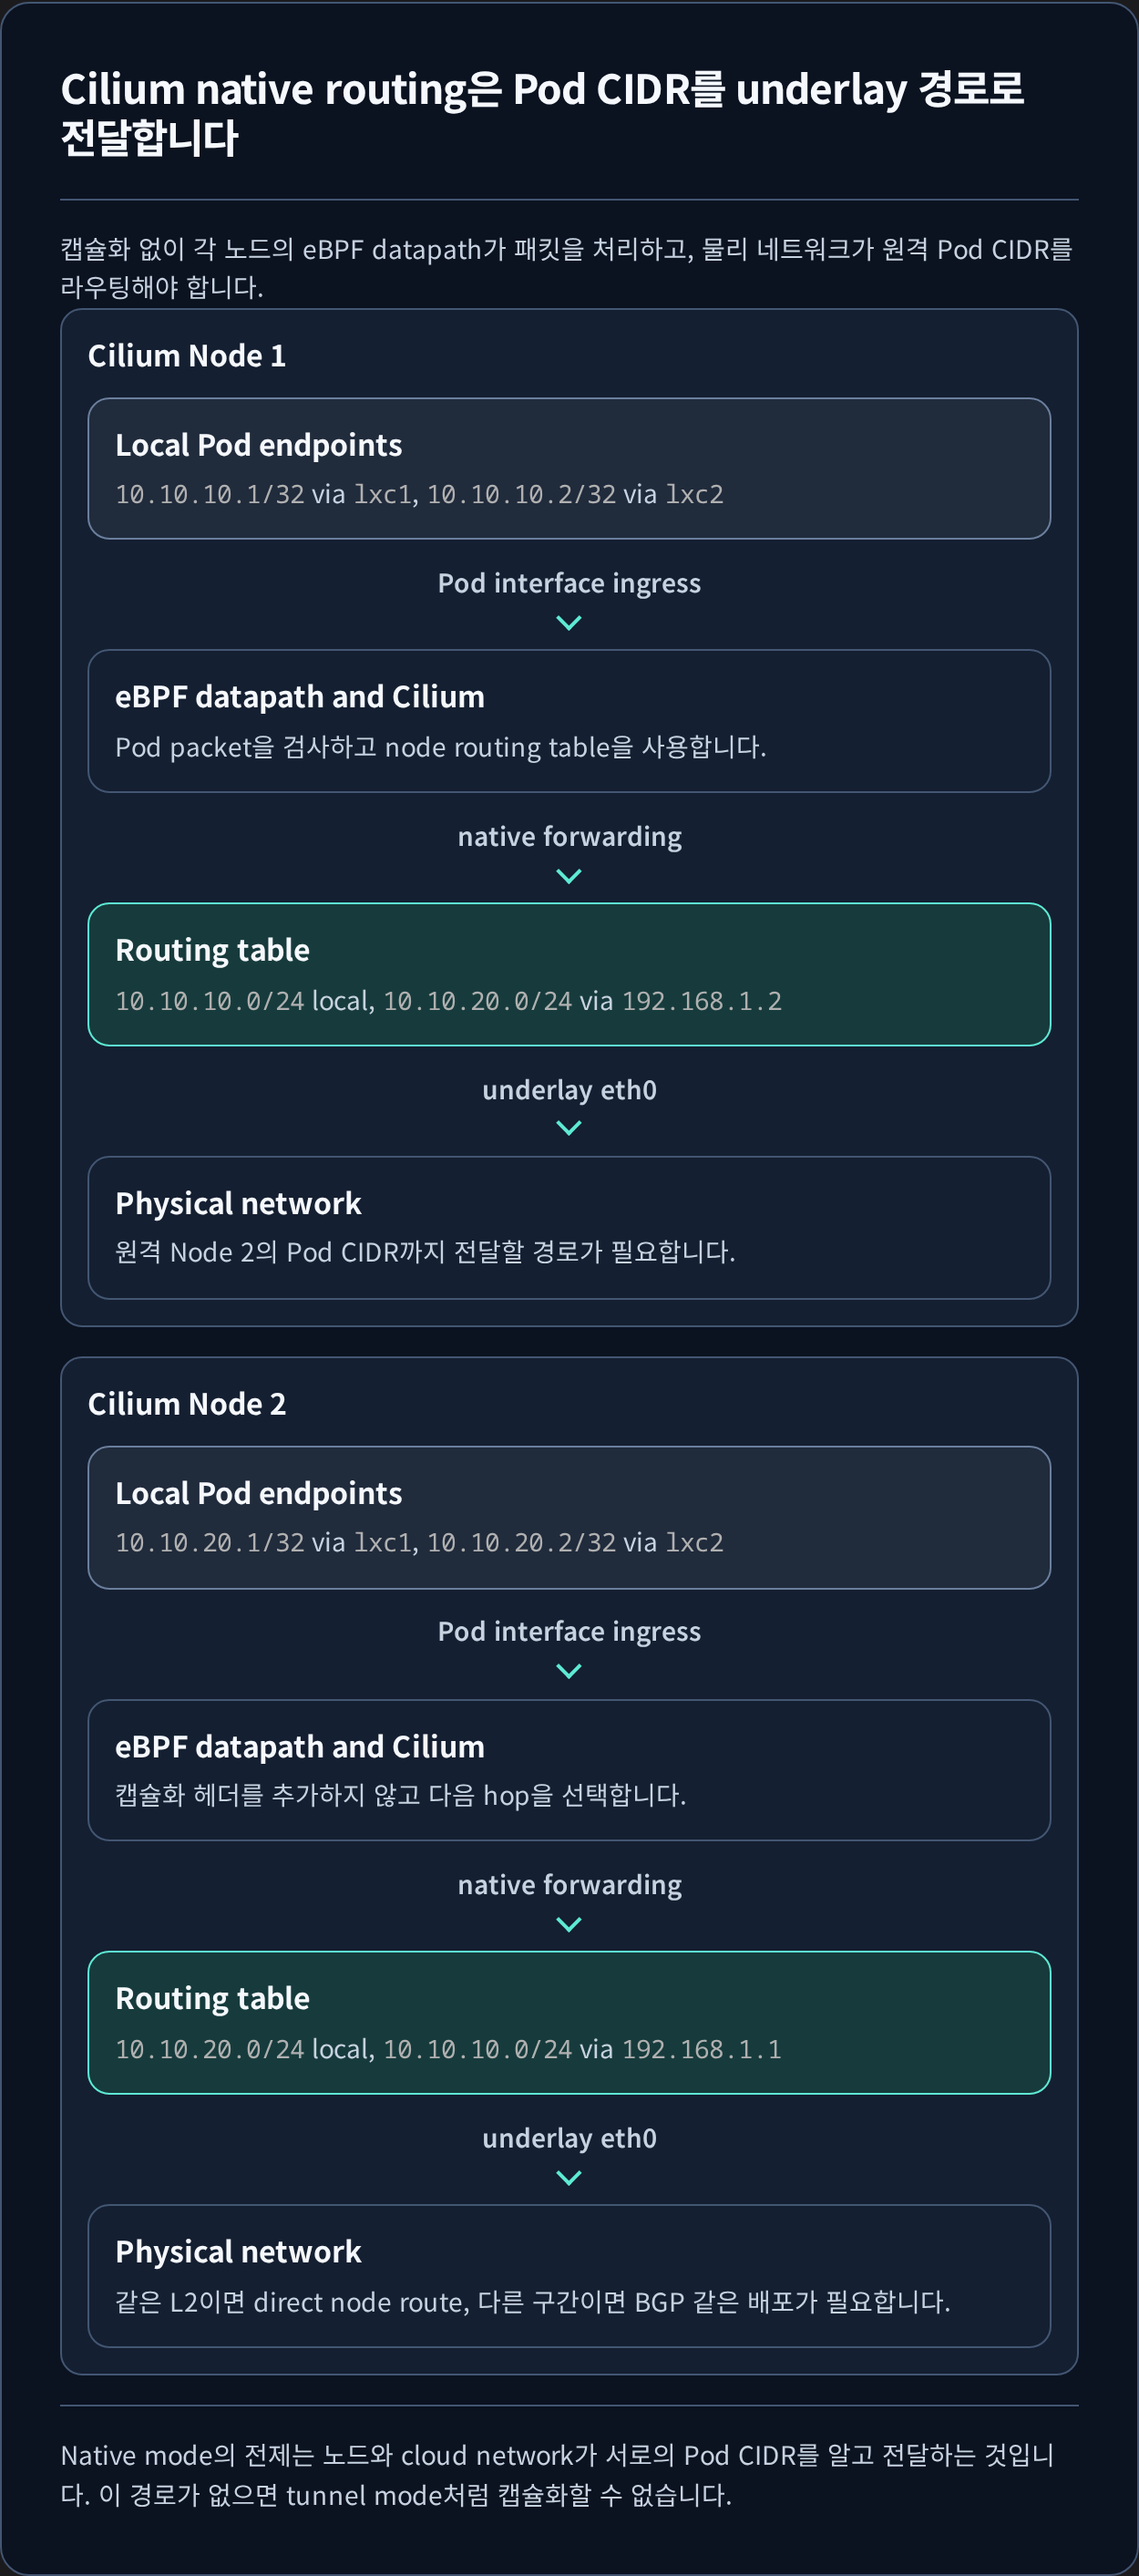
캡슐화를 쓰지 않고, Pod CIDR 자체를 물리 스위치, 라우터 또는 클라우드 네트워크가 전달하도록 해 패킷을 바로 전달합니다. 현재 Cilium에서는 routing-mode: native로 활성화합니다. 이 모드에서는 노드와 네트워크가 다른 노드의 Pod CIDR를 전달할 수 있어야 하며, 같은 L2(Layer 2) 구간에서는 direct node route를 사용하거나 그 밖의 환경에서는 BGP(Border Gateway Protocol) 같은 경로 배포 방식을 선택합니다.
6.2.1. Direct Routing (Native) Mode의 장점
- 최고 성능,최저 지연 캡슐화가 없으므로 MTU 손실 없이 최대 PPS를 달성합니다.
- 완전한 IP 가시성 Pod IP가 실제 라우팅 경로에 드러나므로 VPC(Virtual Private Cloud) Flow Logs 같은 네트워크 관측과 연결하기 쉽습니다. 다만 Pod IP가 항상 VPC IP나 Security Group과 1:1로 매핑되는 것은 IPAM과 클라우드 integration에 따라 달라집니다.
- 클라우드 통합 용이 AWS ENI, GKE(Google Kubernetes Engine) Alias IP, Azure IPAM 등과 결합하면 “Pod IP = VPC IP” 구조를 손쉽게 구현할 수 있습니다.
- eBPF 기반 L4/L7 LB와 자연스러운 결합 커널 내 로드밸런싱이 터널 헤더를 제거할 필요 없이 바로 적용됩니다.
6.2.2. Direct Routing (Native) Mode의 단점
- 네트워크 라우팅 요구 스위치,라우터가 Pod CIDR 전체를 학습해야 하며, BGP 설정 등 인프라 구성이 추가로 필요합니다.
- 라우팅 테이블 확장 클러스터 규모가 커질수록 물리 장비의 라우팅 엔트리가 크게 늘어날 수 있습니다.
- BGP/SDN 운용 복잡도 ToR 스위치의 펌웨어,정책 관리, 클라우드 경로 제한, IP 할당 한도(예: ENI IP 슬롯) 등 운영 부담이 존재합니다. SDN(Software-Defined Networking) 환경에서는 경로 배포와 정책 변경 절차도 함께 점검해야 합니다.
7. Cilium IPAM(IP Address Management)
IP 주소 관리(IPAM)는 Cilium endpoint가 사용할 IP 주소의 할당자와 주소 풀을 결정하는 기능입니다. 선택 가능한 모드는 cluster의 Kubernetes PodCIDR 관리 방식, 클라우드 네트워크 통합, 필요한 IP 풀 분리 여부에 따라 달라집니다. Kubernetes Host Scope, cluster-pool, multi-pool 외에도 Kubernetes CustomResourceDefinition(CRD)-backed, AWS ENI, Azure IPAM, GKE 같은 모드가 있습니다.
7.1. Kubernetes Host Scope
노드마다 부여된 PodCIDR 범위 안에서 kube-controller-manager가 직접 IP를 할당하는 방식입니다.
Kubernetes control plane이 node별 CIDR을 정하고, Cilium agent는 해당 v1.Node 정보에서 읽은 범위만 사용합니다.
spec.podCIDR 또는 spec.podCIDRs에 10.1.1.0/24와 선택적 IPv6 범위를 둡니다.10.1.1.110.1.1.2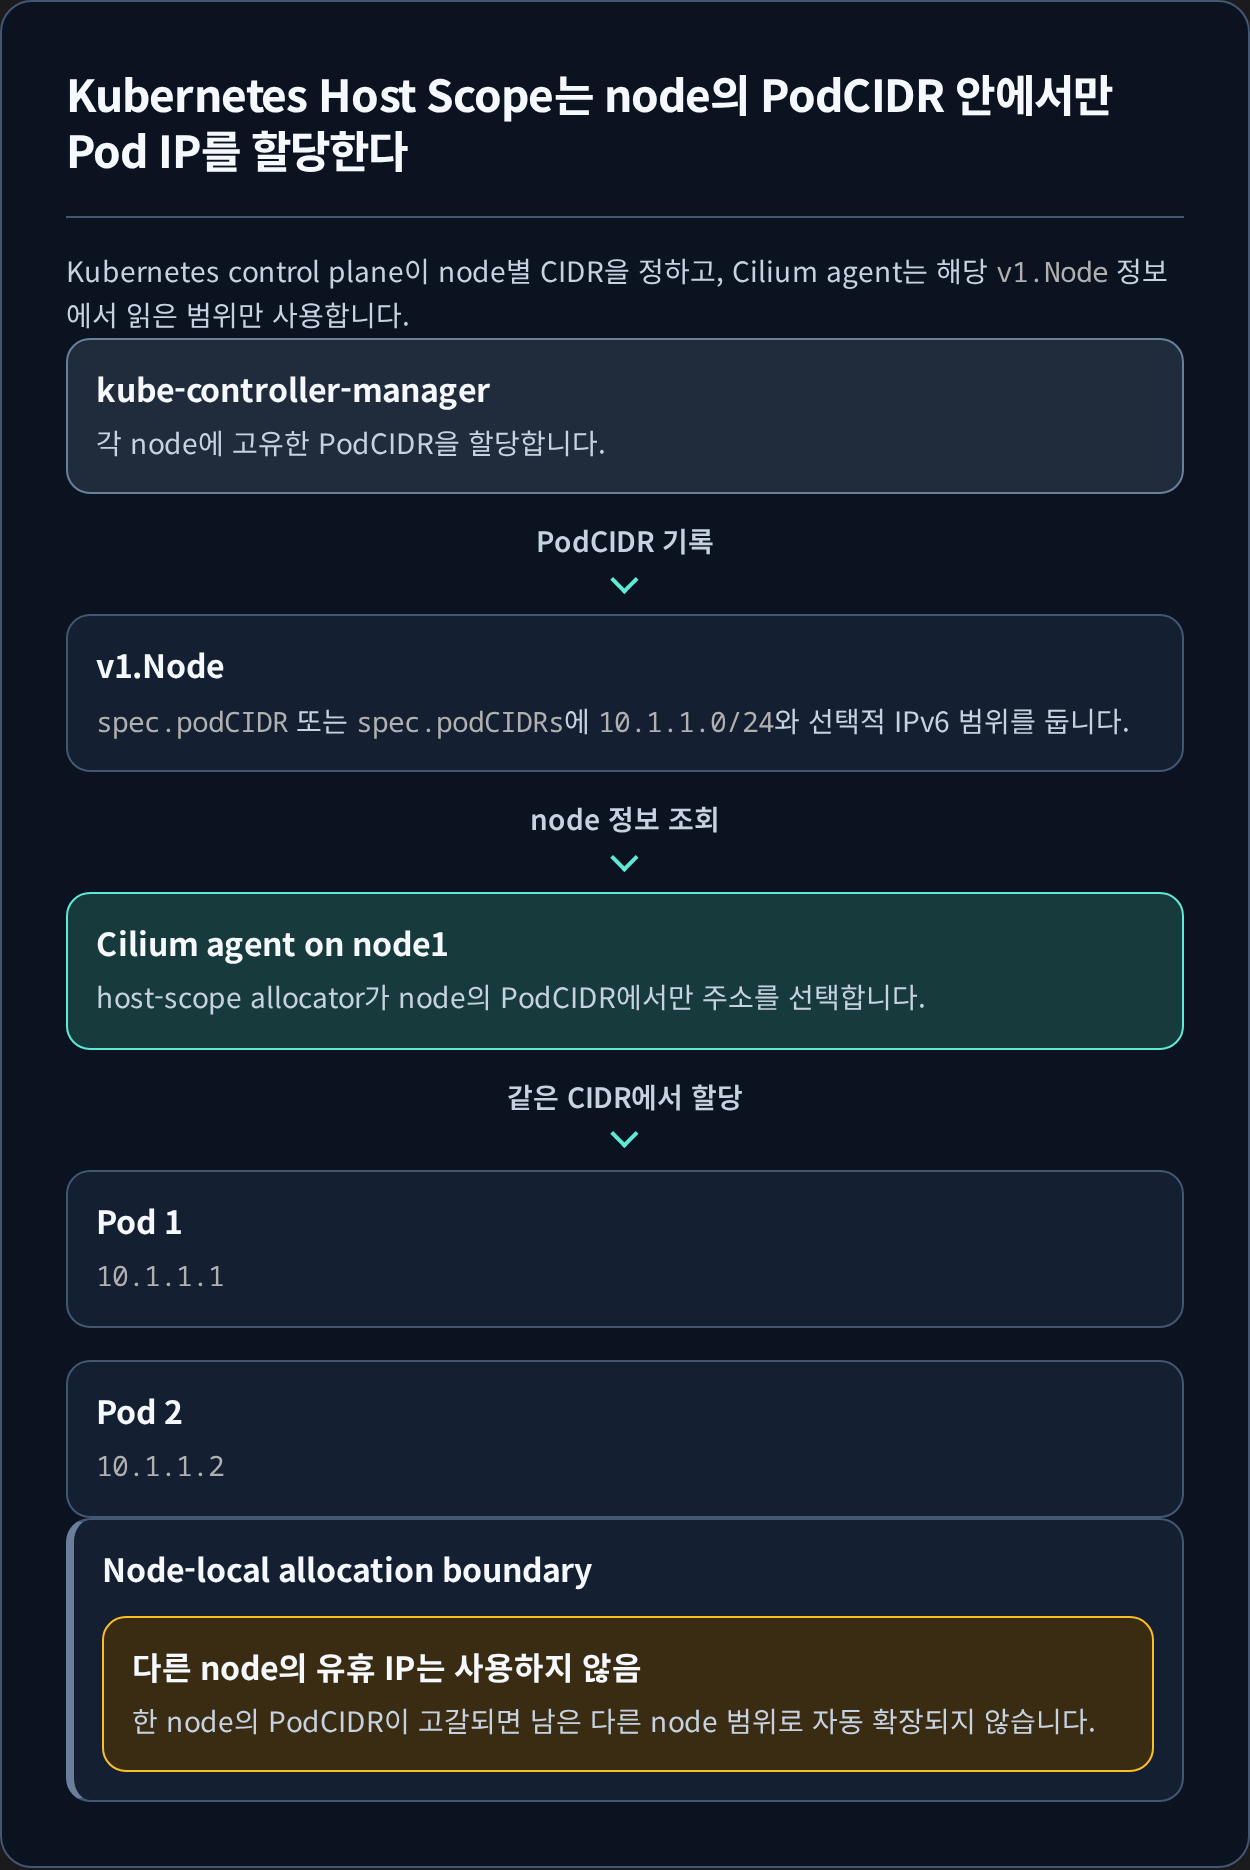
7.2. Cluster Scope
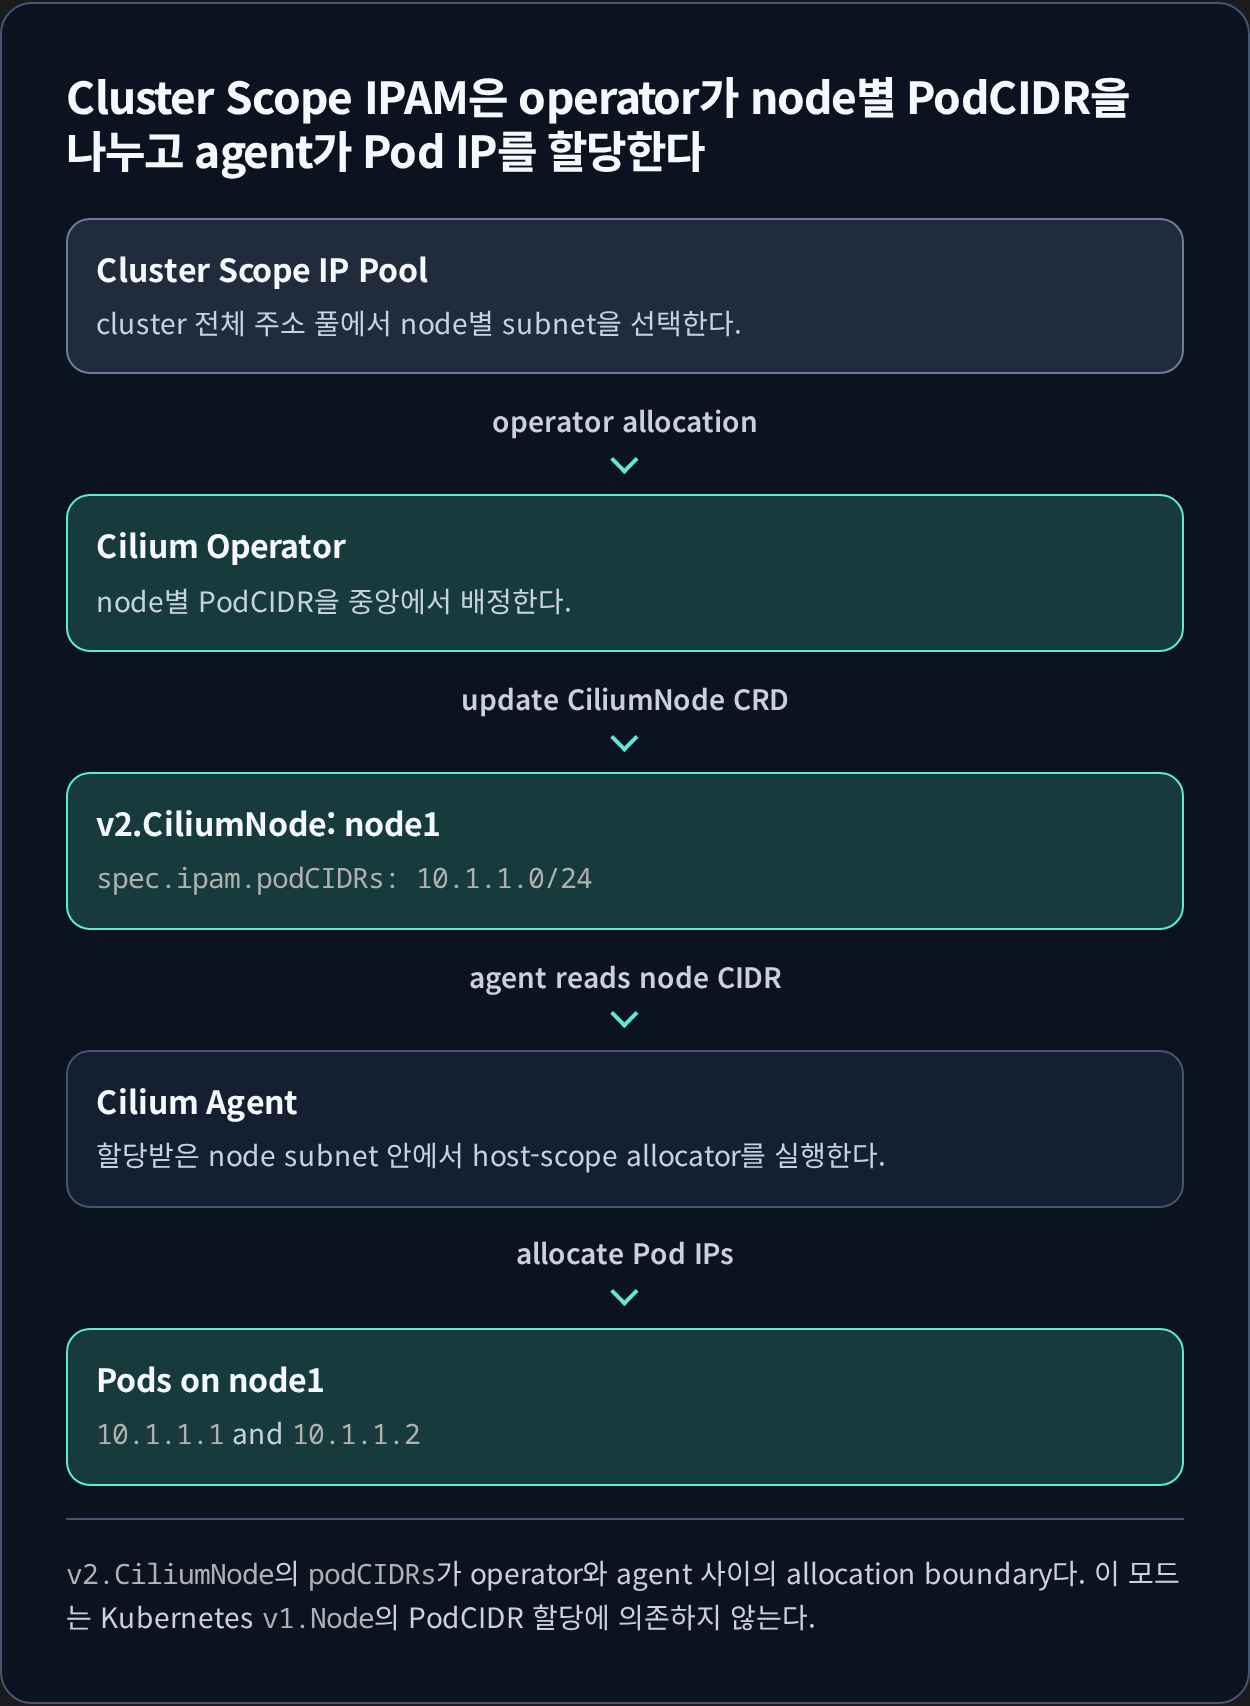
각 노드에 노드별 PodCIDR을 할당하고, 각 노드의 호스트 범위 할당자를 사용하여 IP를 할당한다는 점에서 Kubernetes Host Scope와 비슷하지만 Cilium operator가 v2.CiliumNode 리소스를 통해 노드별 PodCIDR을 관리한다는 점에서 차이가 있습니다. 따라서 Kubernetes v1.Node 리소스에 의존하지 않아 Kubernetes가 PodCIDR을 배포하도록 구성할 수 없거나 더 많은 제어가 필요한 경우에 유용하게 사용할 수 있습니다.
spec.ipam.podCIDRs: 10.1.1.0/2410.1.1.1 and 10.1.1.2v2.CiliumNode의 podCIDRs가 operator와 agent 사이의 allocation boundary다. 이 모드는 Kubernetes v1.Node의 PodCIDR 할당에 의존하지 않는다.
7.3. Multi-Pool (Beta)
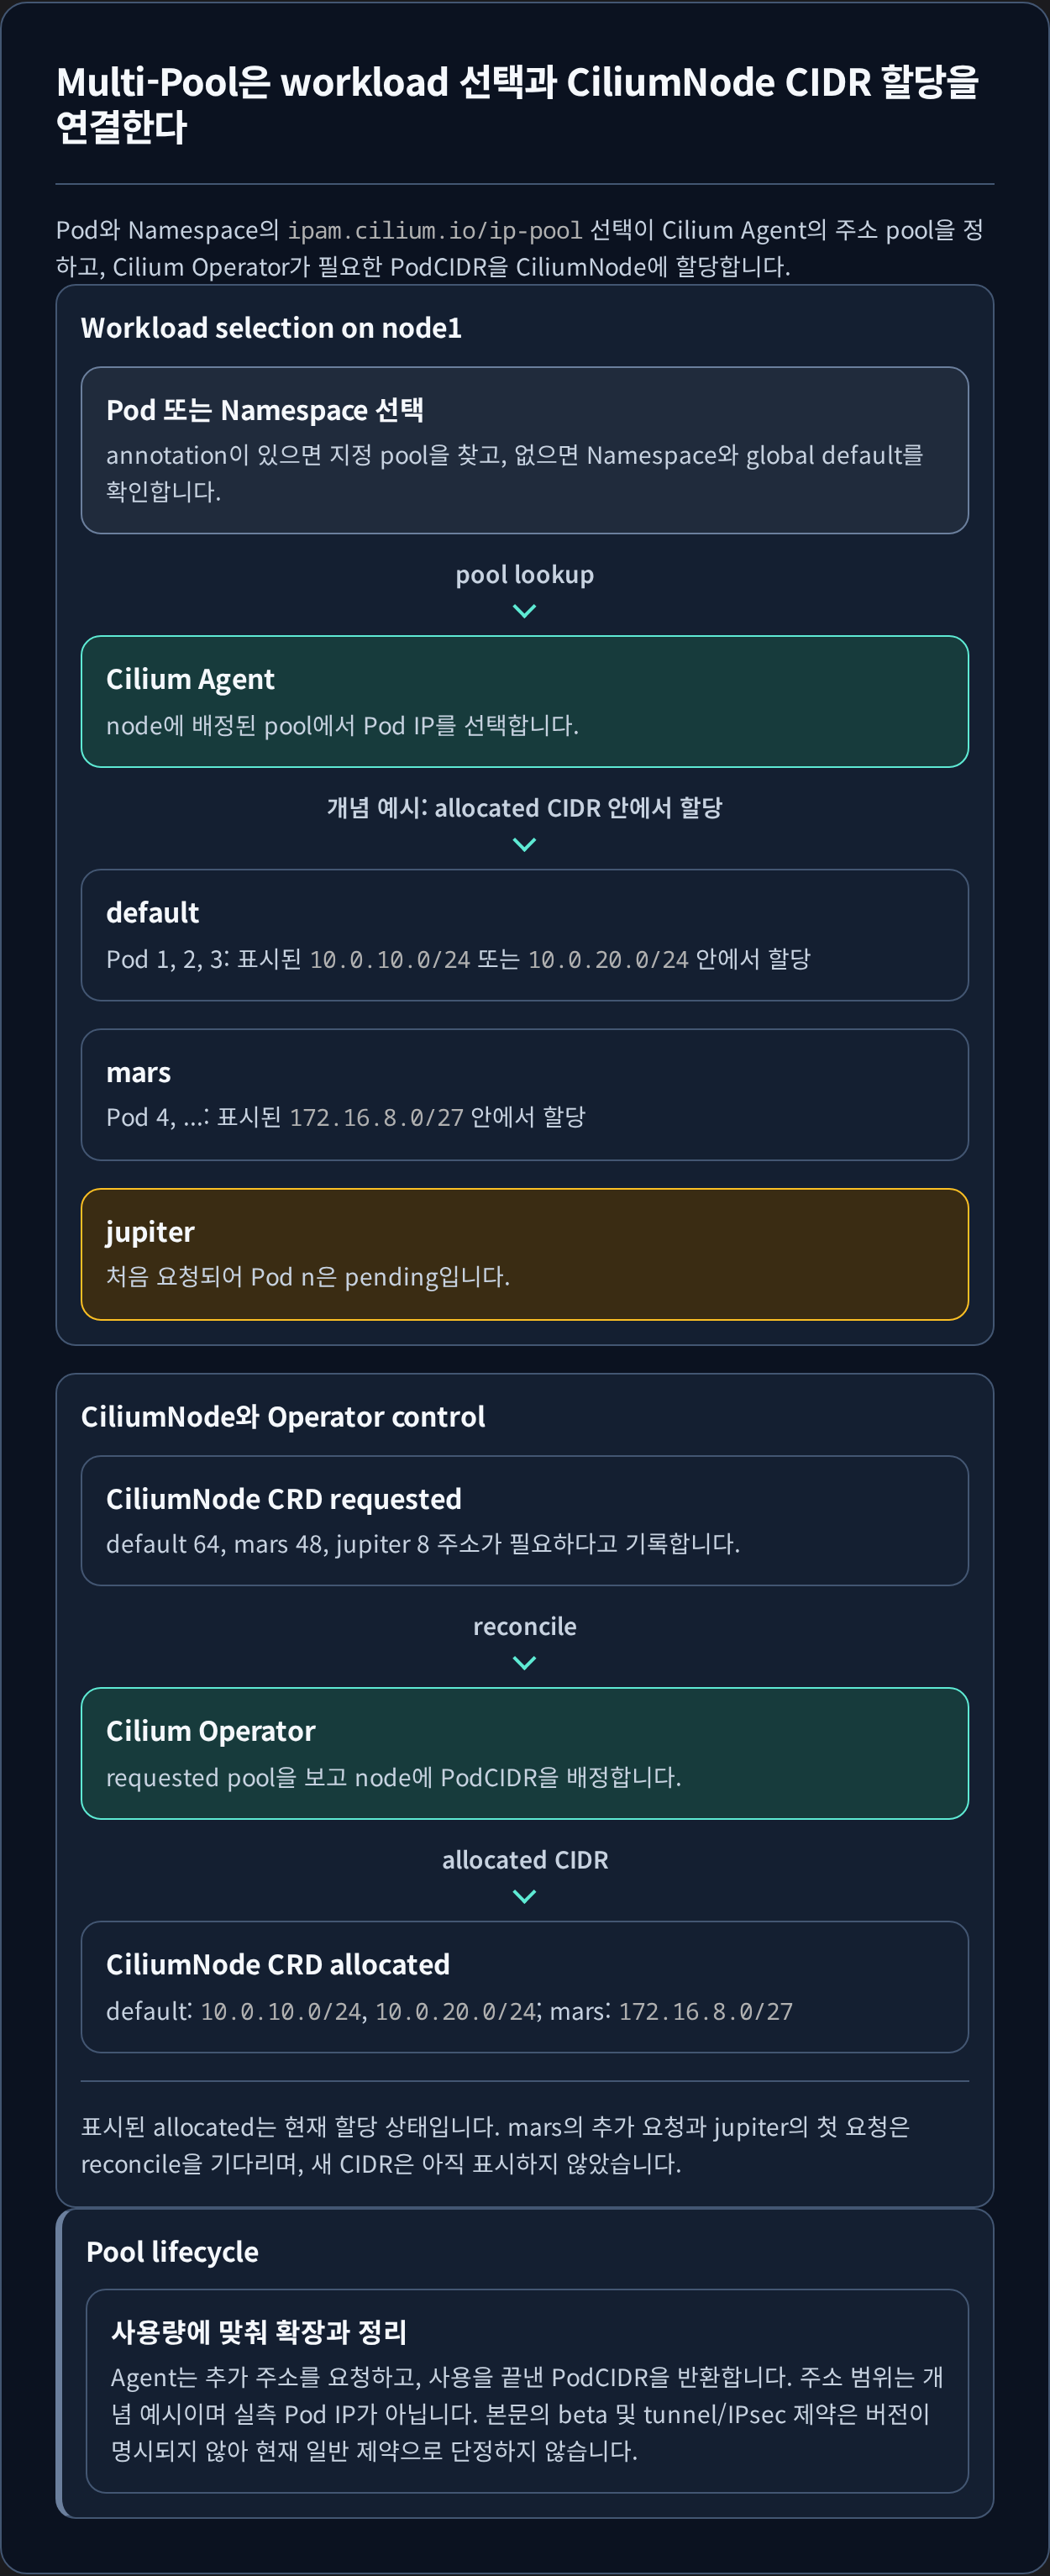
사용자가 정의한 작업 주석 및 노드 레이블에 따라 여러 개의 다른 IPAM 풀에서 PodCIDR을 할당하는 것을 지원합니다.
Pod와 Namespace의 ipam.cilium.io/ip-pool 선택이 Cilium Agent의 주소 pool을 정하고, Cilium Operator가 필요한 PodCIDR을 CiliumNode에 할당합니다.
10.0.10.0/24 또는 10.0.20.0/24 안에서 할당172.16.8.0/27 안에서 할당10.0.10.0/24, 10.0.20.0/24; mars: 172.16.8.0/27표시된 allocated는 현재 할당 상태입니다. mars의 추가 요청과 jupiter의 첫 요청은 reconcile을 기다리며, 새 CIDR은 아직 표시하지 않았습니다.
8. Kube-Proxy Replacement
Cilium은 eBPF service datapath로 kube-proxy의 Service 구현을 대체할 수 있습니다. 이는 iptables chain을 단순히 건너뛰는 기능이 아니라 ClusterIP, NodePort, LoadBalancer 같은 Service traffic을 처리하는 책임을 Cilium으로 옮기는 전환입니다.
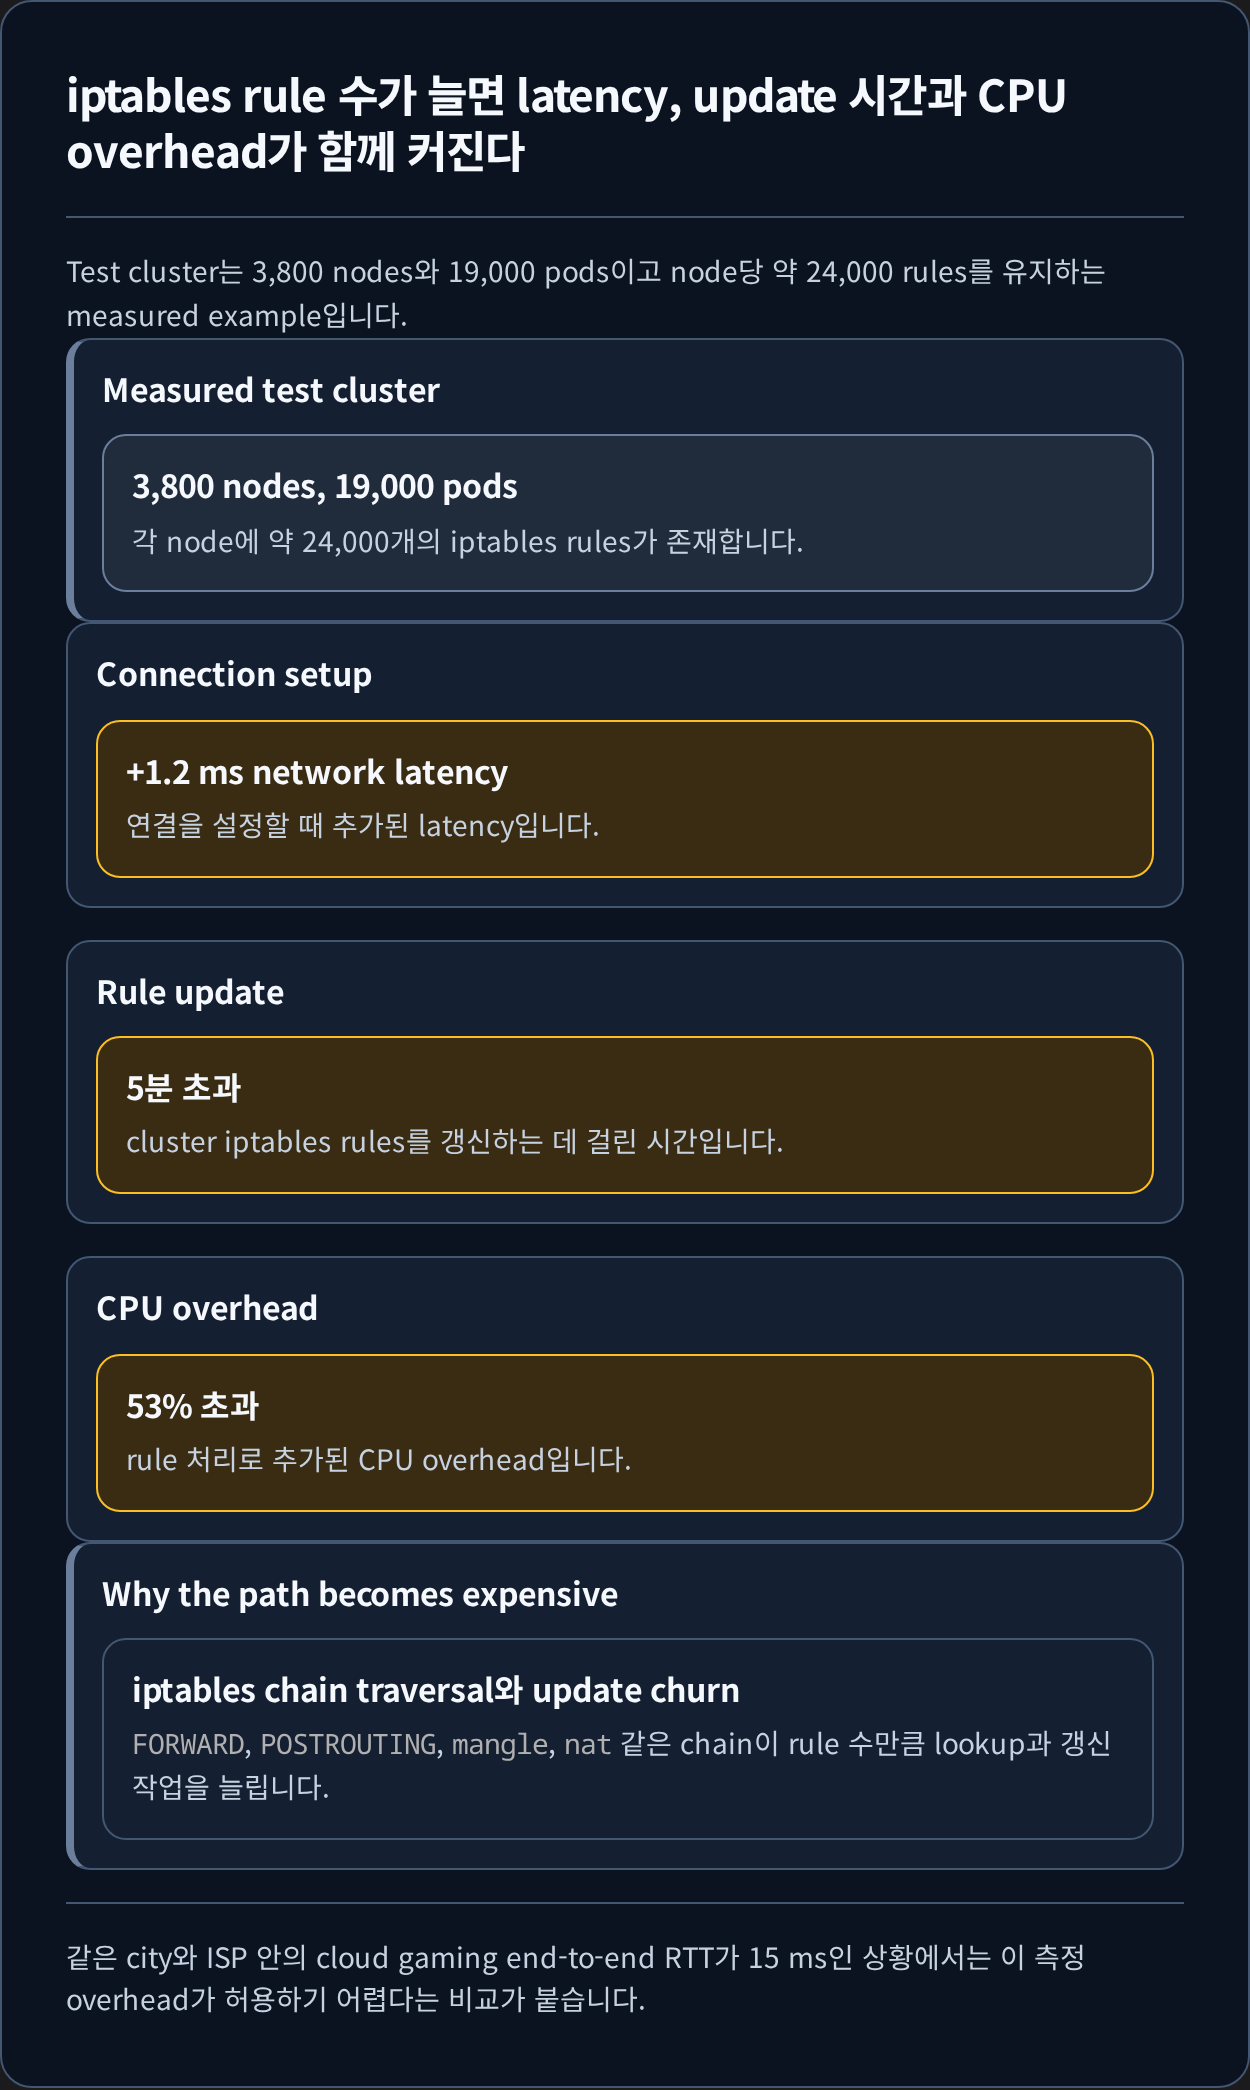
Test cluster는 3,800 nodes와 19,000 pods이고 node당 약 24,000 rules를 유지하는 measured example입니다.
FORWARD, POSTROUTING, mangle, nat 같은 chain이 rule 수만큼 lookup과 갱신 작업을 늘립니다.같은 city와 ISP 안의 cloud gaming end-to-end RTT가 15 ms인 상황에서는 이 측정 overhead가 허용하기 어렵다는 비교가 붙습니다.
같은 Service 요청이라도 기존 경로는 kube-proxy가 만든 iptables와 host stack을 거치고, replacement 경로는 Cilium eBPF가 endpoint lookup과 forwarding을 맡습니다.
curl이 Service ClusterIP로 요청을 보냅니다.PREROUTING, FORWARD, POSTROUTING chain을 통과합니다.socketLB.hostNamespaceOnly=true는 Pod namespace의 socket rewrite 대신 tc/veth fallback을 사용합니다. socket과 veth를 필수 연속 LB 단계로 읽으면 안 됩니다.
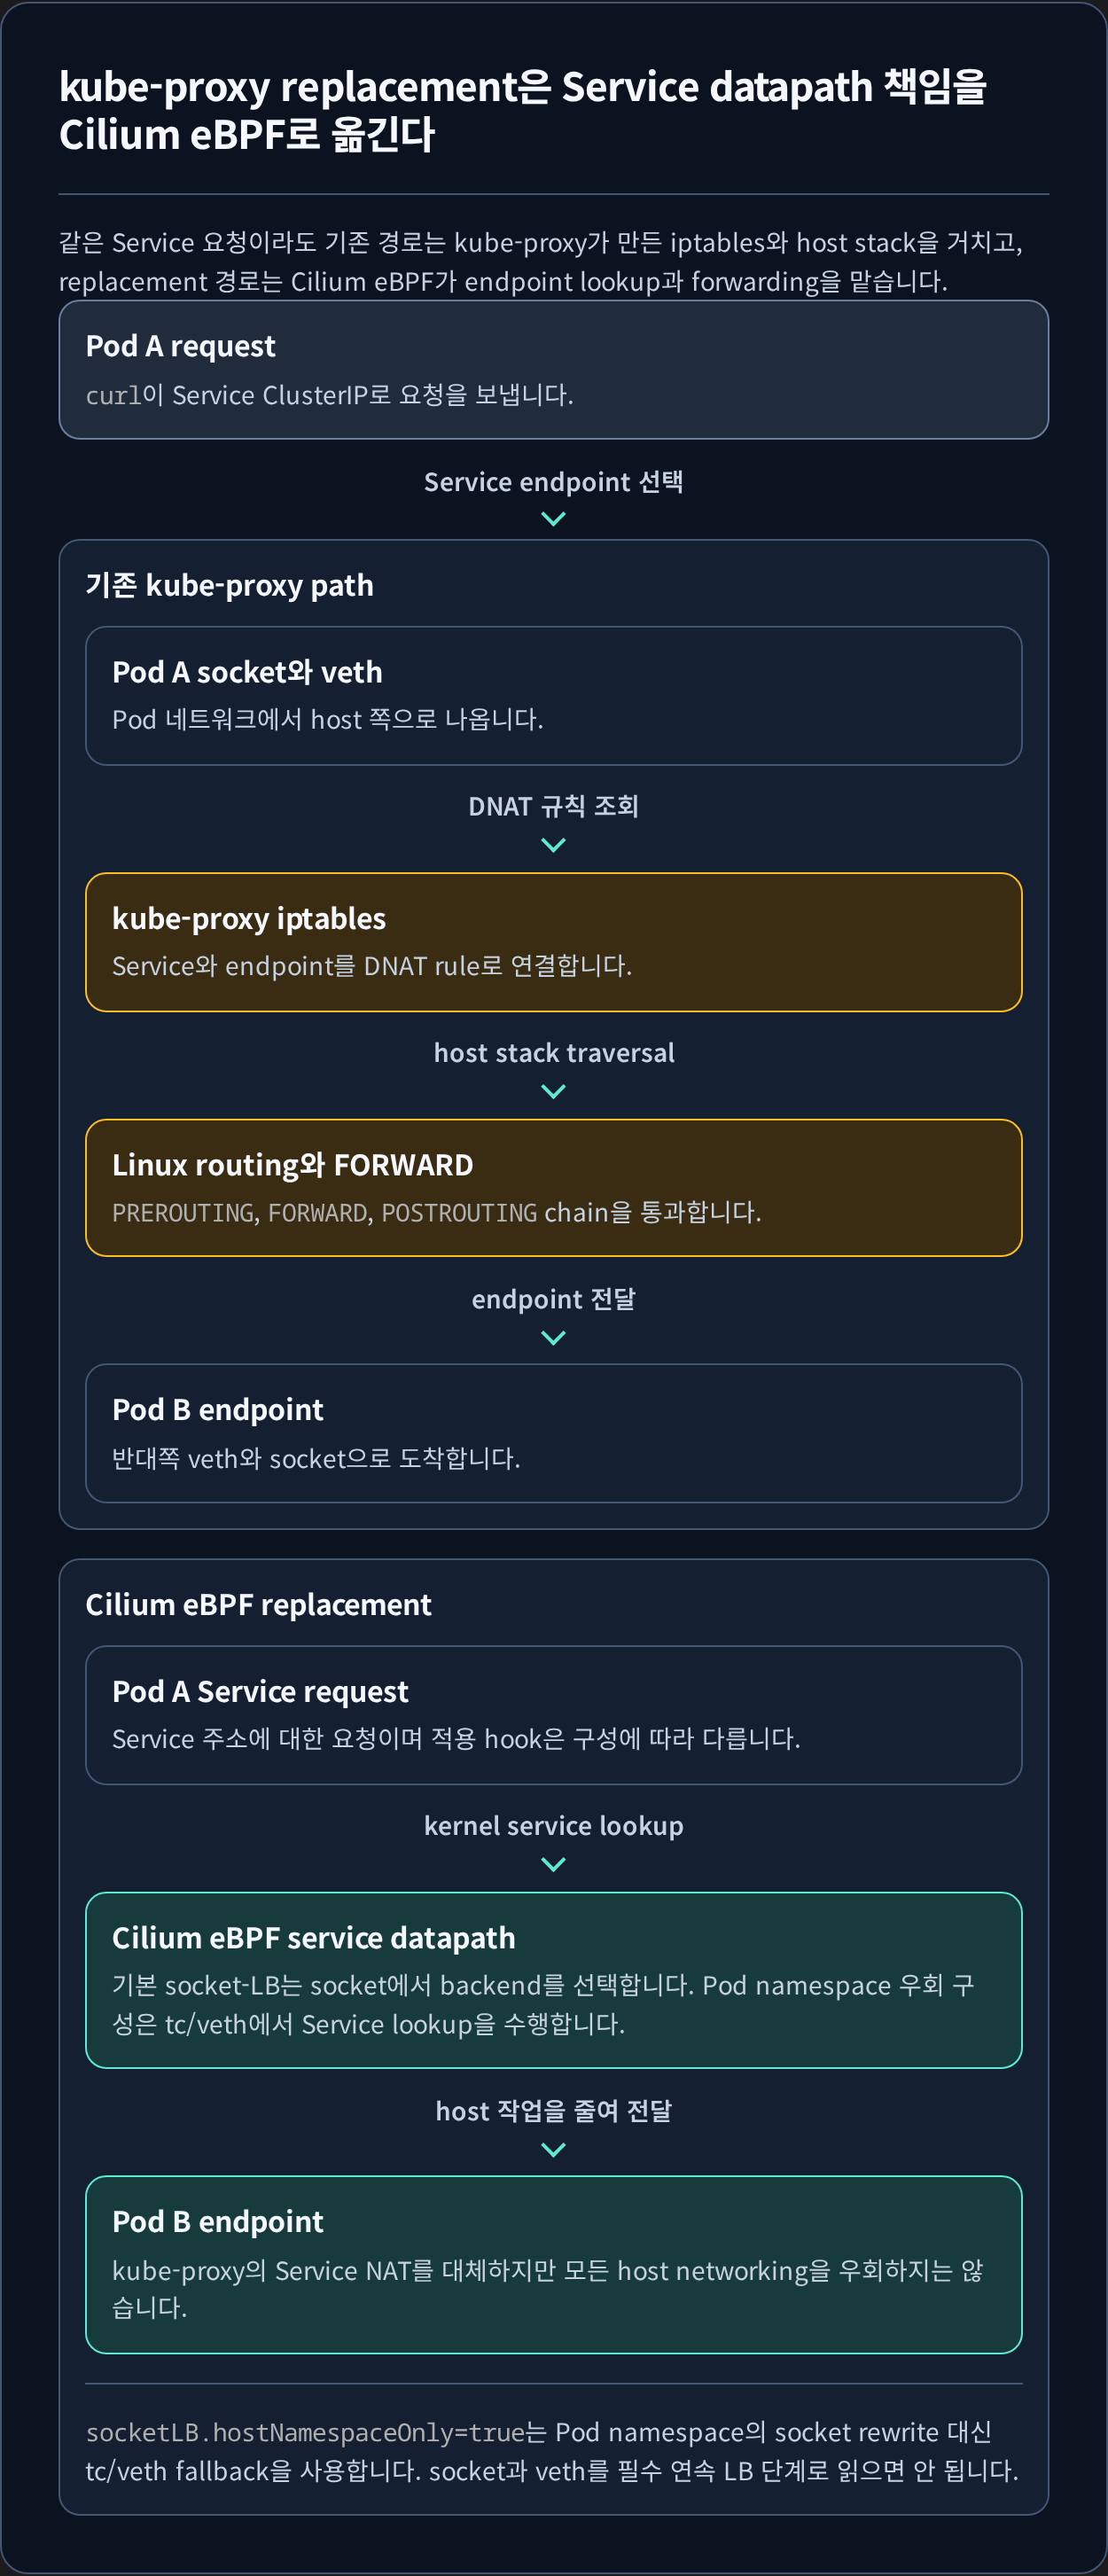
기존 cluster에서 kube-proxy를 제거하거나 replacement를 켜고 끄는 작업은 기존 Service 연결을 끊을 수 있습니다. 새 cluster에서 지원되는 구성으로 시작하는 편이 가장 단순하며, migration이라면 Service connectivity, source IP 보존, NodePort, health check를 사전 검증하고 즉시 되돌릴 수 있는 절차를 준비해야 합니다.
9. 마무리
Cilium의 routing mode와 IPAM은 독립 설정이 아니라 Pod CIDR 전달 가능 여부와 클라우드 네트워크 통합 방식에 함께 맞춰야 합니다. kube-proxy replacement까지 사용할 때는 새 클러스터에서 지원 구성을 확인하거나, 기존 클러스터에서는 Service 연결과 rollback 절차를 검증한 뒤 전환합니다.
10. Reference
- Cilium Docs - Cilium Official Website
- GitHub - Cilium GitHub
- Cilium Docs - Introduction to Cilium & Hubble
- eBPF Docs - eBPF Official Website
- eBPF Docs - What is eBPF?
- eBPF - The Future of Networking & Security
- Cilium Blog - Benchmarking CNI Performance
- Cilium Docs - Routing
- Cilium Docs - IP Address Management
- Cilium Docs - Kubernetes Without kube-proxy
궁금하신 점이나 추가해야 할 부분은 댓글이나 아래의 링크를 통해 문의해주세요.
Written with KKamJi