Agent Router - Envoy 기반 AI 트래픽 제어 [AI Gateway 2]
Envoy AI Gateway가 Agent Router로 바뀌었다면 기존 manifest의 aigateway.envoyproxy.io도 바꿔야 할까요? 공식 발표는 배포 식별자를 그대로 유지한다고 명시합니다. Agent Router는 Envoy Gateway에 AI 전용 controller와 external processor를 결합하는 같은 Apache-2.0 프로젝트입니다.
2026-08-28 조사 기록과 2026-09-08의 태그 소스 대조를 바탕으로, 2026-10-06에 공식 리네이밍 발표와 안정판 문서를 추가 확인했습니다. 아래 구현 설명은 v1.1.0 기준이며 설치, 실제 provider 호출과 장애 주입은 실행하지 않았습니다.
TL;DR
2026-09-09에 Agent Router로의 이름 변경을 발표했고, 2026-09-10에 AAIF로 공식 편입됐다. CRD, CLI와 배포 경로는 유지된다. Envoy Proxy가 provider 연결을 담당하고 ext-proc가 모델과 토큰 사용량을 해석한다. v1.1의 토큰 quota는 사후 집계이며 서비스 장애 시 fail-open이 기본값이므로, 엄격한 금액 상한으로 취급하지 않는다.
1. 2026년 9월의 이름 변경과 유지되는 식별자
공식 발표 페이지의 게시일은 2026-09-09, 본문에 명시된 Agentic AI Foundation(AAIF) 공식 편입일은 2026-09-10입니다. Envoy AI Gateway가 Agent Router라는 이름의 독립 프로젝트로 AAIF에 옮겨간 전환이며, GitHub 저장소 이름 변경 작업의 정확한 시각을 뜻하지는 않습니다.
| 구분 | 변경 또는 유지 내용 |
|---|---|
| 프로젝트 이름 | Envoy AI Gateway에서 Agent Router로 변경 |
| 저장소와 홈페이지 | theagentrouter/agent-router, theagentrouter.ai로 이전 |
| CRD와 API group | AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, aigateway.envoyproxy.io 유지 |
| CLI와 설치 namespace | aigw, envoy-ai-gateway-system 유지 |
| 이미지 경로 | docker.io/envoyproxy/ai-gateway-controller, docker.io/envoyproxy/ai-gateway-extproc 유지 |
| Helm OCI 경로 | oci://docker.io/envoyproxy/ai-gateway-helm, oci://docker.io/envoyproxy/ai-gateway-crds-helm 유지 |
| Go module | github.com/envoyproxy/ai-gateway 유지 |
공식 설명은 같은 코드, 유지보수자, 릴리즈 주기와 Apache-2.0 라이선스를 유지하며 Envoy와 Envoy Gateway 기반도 바뀌지 않는다고 밝힙니다. 기존 manifest의 envoyproxy/ai-gateway 계열 이미지나 Helm 경로를 새 저장소 이름으로 일괄 치환할 필요는 없습니다. 이름 변경은 버전 업그레이드나 운영 안전성의 보장이 아닙니다.
Tetrate Agent Router Service(TARS)는 상용 호스팅 서비스이며 OSS 프로젝트의 새 이름과 구분합니다. 별도 agentgateway 프로젝트도 이번 리네이밍 대상이 아닙니다.
2. 독립 LLM 프록시와 Envoy Gateway 통합
설정: 모델/라우팅 YAML, 환경변수, DB 관리 레코드
설정: Kubernetes CRD와 controller
둘 다 요청 데이터 경로에 놓인다. 선택한 모델로 요청을 전달하며, 클라이언트가 Gateway endpoint를 지정한다. Python SDK는 필수가 아니다.
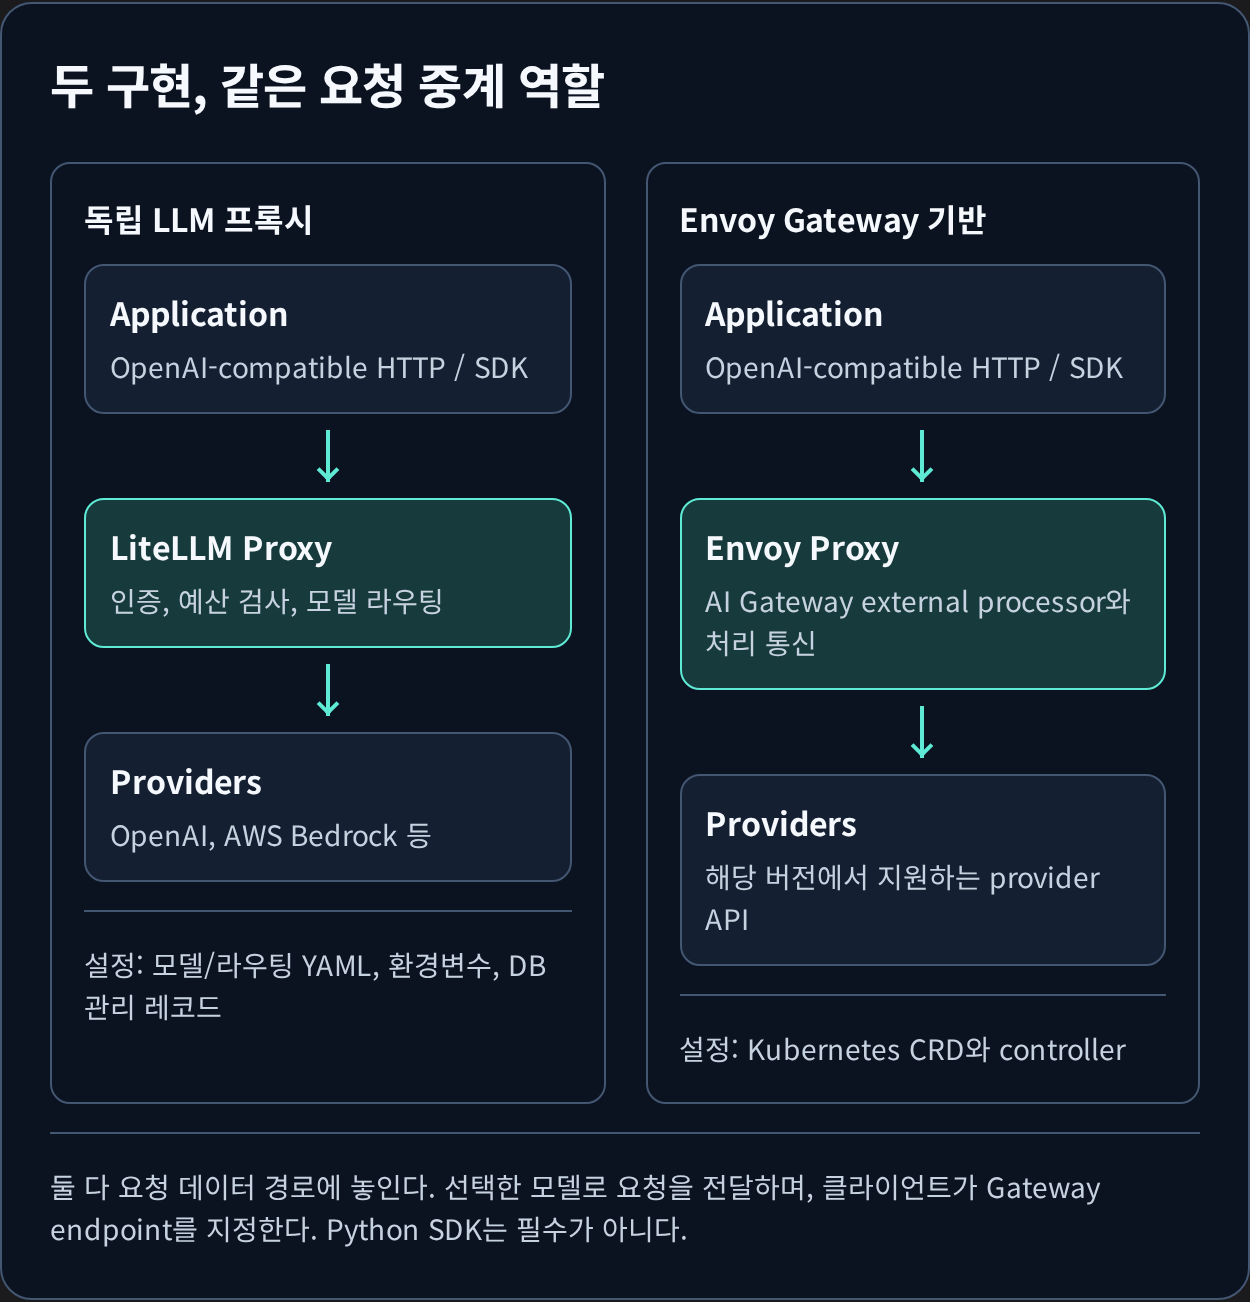
LiteLLM Proxy와 Agent Router는 모두 애플리케이션과 provider 사이에서 실제 요청을 중계합니다. LiteLLM Proxy는 Python 기반 독립 LLM 프록시이고, Agent Router는 Envoy Gateway의 라우팅과 정책 체계에 AI 처리를 결합합니다. LLM Gateway의 키 정책과 비용 집계는 공통 관심사지만, 설정 체계와 운영 구성은 다릅니다.
| 비교 항목 | LiteLLM Proxy | Agent Router |
|---|---|---|
| 요청 처리 | Python 기반 독립 LLM 프록시 | Envoy Proxy와 Go ext-proc의 협업 |
| 클라이언트 연결 | OpenAI 호환 HTTP/SDK로 Proxy endpoint 호출 | 지원 API의 HTTP/SDK로 Gateway endpoint 호출 |
| 주요 설정 체계 | Proxy 설정과 관리 API | AI Gateway CRD와 Envoy Gateway 정책 |
| Kubernetes 운영 | Proxy와 사용하는 기능의 저장소 관리 | 두 controller의 연동, sidecar, 제한 및 관측 인프라 관리 |
어느 쪽이든 클라이언트가 Gateway endpoint를 사용하도록 설정해야 합니다. 기존 Gateway API를 운영하는 팀은 리소스 관리 방식을 재사용할 수 있지만 AI 처리가 자동 적용되지는 않습니다. 두 프록시를 연속 배치한다면 인증과 사용량 집계의 책임을 나누어 중복 처리를 피해야 합니다. LiteLLM의 배포 관측도 함께 비교할 수 있습니다.
Kubernetes가 필수 실행 환경은 아닙니다. v1.1의 aigw run은 Linux와 macOS에서 Docker나 Kubernetes 없이 standalone 프록시를 실행하는 형태입니다. provider 설정과 자격증명을 준비한 뒤 사용하는 기본 OpenAI 호환 base URL은 http://localhost:1975/v1이며, /v1/chat/completions를 제공합니다. 로컬 실행 형태가 있다는 사실과 운영용 인증, quota, 관측 구성이 준비됐다는 사실은 별개입니다.
3. 설정 경로, 요청 경로와 최소 route
external processor는 Proxy와 통신한다. Provider 호출 홉이 아니다.
BackendSecurityPolicy
사용량 제한 설정
Envoy Gateway
external processor 처리 설정
선언을 감시하고 구성으로 변환하여 두 런타임에 각각 반영한다. Controller별 내부 변환 단계는 생략했다.
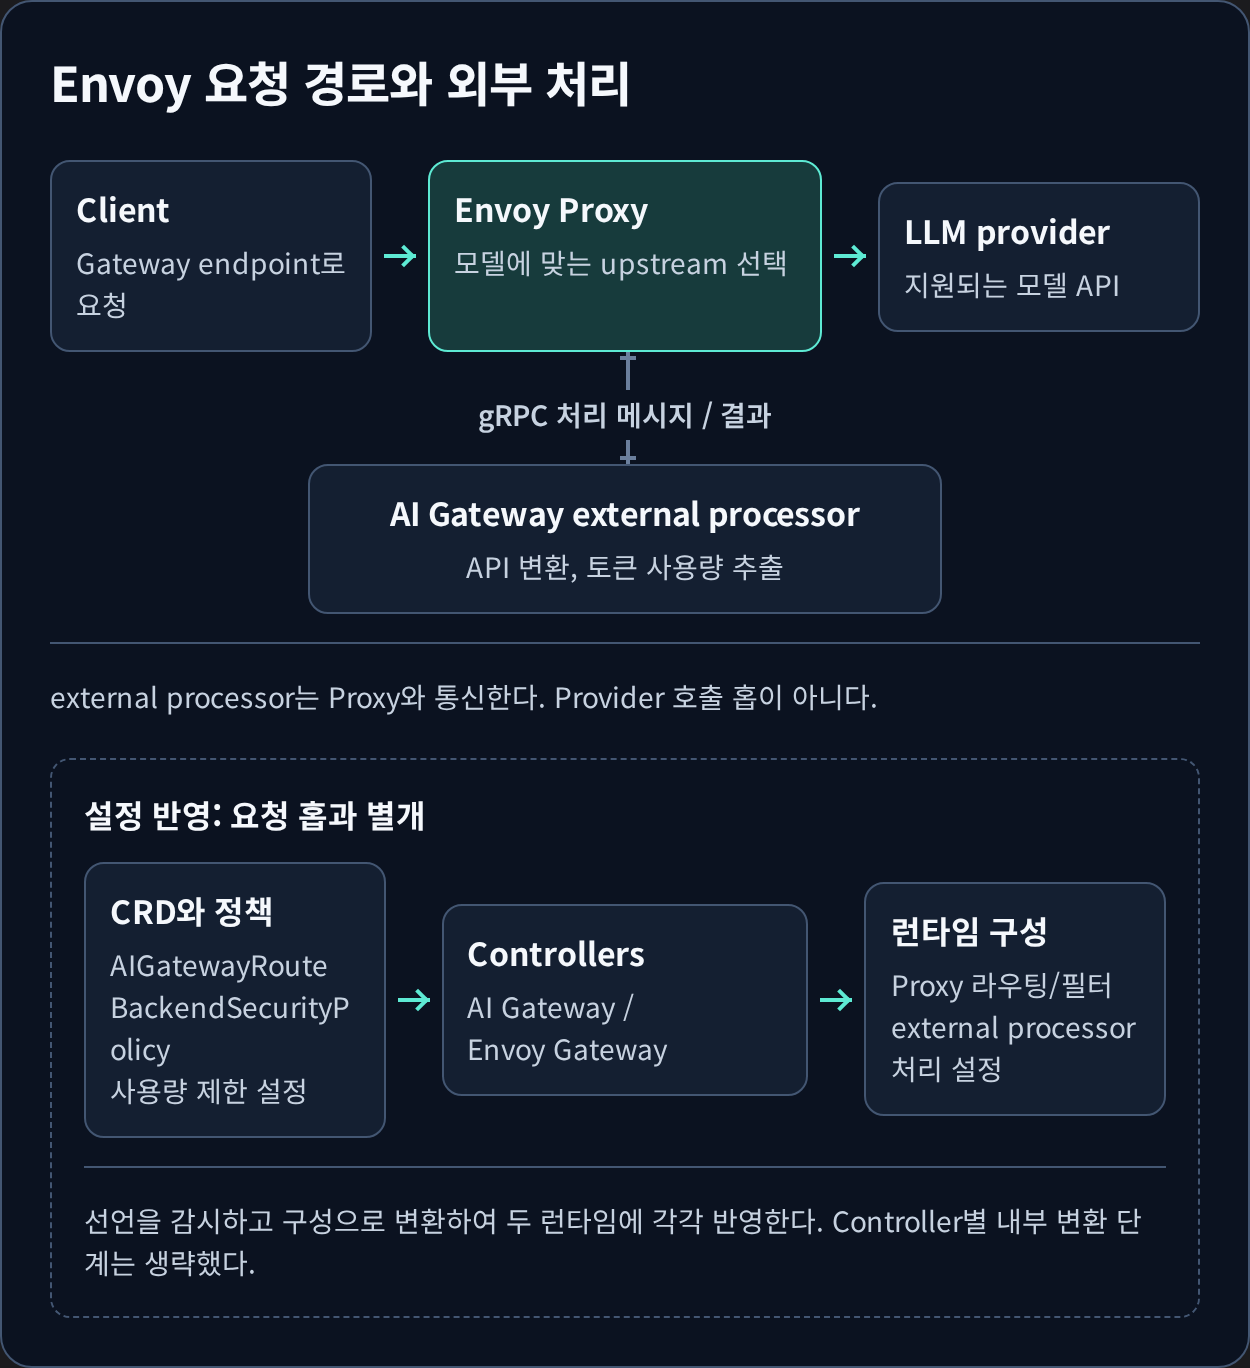
컨트롤 플레인은 Envoy Gateway와 AI Gateway controller가 함께 구성합니다. AI Gateway controller는 AI 전용 리소스를 감시하고 HTTPRoute, HTTPRouteFilter와 ext-proc 설정 Secret을 생성하거나 갱신합니다. extension server가 xDS 설정을 보완하고 Envoy Gateway가 최종 설정을 Proxy에 배포합니다. 그림의 AI Gateway와 ext-proc는 유지되는 기술 구성 요소 이름입니다.
C++ Envoy Proxy와 Go external processor(ext-proc)는 별도 프로세스입니다. 공식 Kubernetes 배포에서는 admission webhook이 ext-proc를 Envoy Proxy Pod의 sidecar로 주입하며, 둘은 로컬 Unix Domain Socket(UDS)으로 통신합니다. Proxy가 필요한 단계에서 ext-proc에 모델 추출, provider 형식 변환과 사용량 추출을 맡깁니다. 실제 upstream HTTP 연결은 Envoy Proxy가 담당합니다. CRD는 설정 객체이며 요청이 통과하는 네트워크 홉이 아닙니다.
2026-10-06 확인 시 최신 정식 릴리즈는 여전히 v1.1.0이며, 발행 시각은 2026-08-21T18:23:16Z입니다. 공식 v1.1.x 호환 범위와 해당 태그의 의존 버전은 구분해야 합니다.
| 구성 요소 | v1.1.x 공식 호환 범위 | v1.1.0 태그 의존 버전 |
|---|---|---|
| Envoy Gateway | v1.8.1+ | v1.8.1 |
| Envoy Proxy | v1.38.x | v1.38.1 |
| Kubernetes | v1.32+ | 배포 환경에서 확인 |
| Gateway API | v1.5.x | v1.5.1 |
| Gateway API Inference Extension | 기능 사용 시 별도 확인 | v1.0.2 |
AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig, MCPRoute는 core v1beta1 API입니다. v1.1은 v1.0에서 CRD migration을 요구하지 않지만 Helm controller의 security context 기본값 변경은 확인해야 합니다. 기존 Envoy Gateway에는 AI Gateway controller, extension server 연동, webhook과 sidecar 구성이 필요합니다.
다음은 공식 v1.1 basic 예제에서 AIGatewayRoute 객체만 가져온 설정입니다. default namespace의 Gateway envoy-ai-gateway-basic과 AIServiceBackend envoy-ai-gateway-basic-testupstream을 참조합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
apiVersion: aigateway.envoyproxy.io/v1beta1
kind: AIGatewayRoute
metadata:
  name: envoy-ai-gateway-basic
  namespace: default
spec:
  parentRefs:
    - name: envoy-ai-gateway-basic
      kind: Gateway
      group: gateway.networking.k8s.io
  rules:
    - matches:
        - headers:
            - type: Exact
              name: x-ai-eg-model
              value: some-cool-self-hosted-model
      backendRefs:
        - name: envoy-ai-gateway-basic-testupstream
x-ai-eg-model은 요청에서 추출한 모델명을 매칭하는 키이고 backendRefs는 연결할 AIServiceBackend를 선택합니다. 이 route 하나만으로 설치나 provider 연결이 완료되지는 않습니다. 참조한 Gateway, GatewayClass, AIServiceBackend와 실제 upstream Backend 등의 구성은 원본 예제에서 함께 확인해야 합니다. 실제 적용 후에는 route 상태와 생성된 HTTPRoute 및 Proxy 설정을 확인하고, 사용할 모델의 요청과 응답을 별도로 검증해야 합니다.
4. 응답 토큰 제한과 모델별 quota
4.1. Usage-based Rate Limiting
출력 토큰을 포함한 최종 사용량은 응답 완료 시점에 확정됩니다. AIGatewayRoute.spec.llmRequestCosts가 입력, 출력, 전체 토큰 또는 CEL 비용을 dynamic metadata로 정의하고, Envoy Gateway BackendTrafficPolicy가 이를 응답 비용으로 사용합니다. Envoy Gateway의 global Rate Limit Service와 Redis 구성이 필요합니다.
요청을 받을 때는 이미 집계된 사용량으로 허용 여부를 판단하고, 허용된 요청의 응답이 완료되면 사용량을 차감합니다. v1.1 문서는 스트리밍도 마지막 사용량을 반영하며 이미 허용한 스트림을 한도 초과로 중간에 끊지는 않는다고 설명합니다. 후속 요청을 429 Too Many Requests로 거절하는 제어이므로 정밀한 선불 비용 예약과는 다릅니다.
4.2. QuotaPolicy
QuotaPolicy는 AIServiceBackend에 부착하는 모델별 토큰 예산 정책입니다. 완료된 요청의 사용량을 기본 total_tokens 또는 CEL 비용식으로 계산합니다. rate limit 인프라를 활용하지만 Usage-based Rate Limiting과 설정 API 및 정책 적용 대상은 다르며, controller의 quotaRateLimitServiceAddr에 지정한 quota 서비스와 Redis 연결을 확인해야 합니다.
| 설정 | v1.1에서 확인할 동작 |
|---|---|
perModelQuotas[].modelName | route의 해당 backendRef에 지정한 modelNameOverride와 일치해야 적용 |
bucketRules[].clientSelectors | 현재는 header 조건만 반영 |
mode: Shared | 일치하는 bucket rule과 default bucket 모두에 집계하되, 관련 bucket 중 하나라도 잔여량이 있으면 허용 |
serviceQuota | 필드는 존재하지만 enforcement 미구현, 설정해도 트래픽에 영향 없음 |
bucketRules[].shadowMode | 검사와 집계는 하되 초과 결과로 요청을 거절하지 않음 |
| API 버전 | QuotaPolicy는 v1alpha1, core v1beta1 안정성 보장과 구별 |
Shared는 팀 bucket이나 전체 bucket 하나만 소진돼도 차단하는 계층형 hard cap이 아닙니다. 팀별 식별 헤더는 신뢰된 인증 단계에서 검증하거나 덮어써야 합니다. 클라이언트가 임의로 보낸 팀 ID를 신뢰하면 다른 팀의 bucket을 선택할 수 있습니다.
v1.1 Helm 기본값은 controller.quotaRateLimitFailureModeDeny: false입니다. quota 서비스가 unavailable일 때 요청을 거절하지 않는 fail-open 설정이므로, 연결 누락이나 장애 시 quota 강제를 보장할 수 없습니다. true로 바꾸면 서비스 장애 시 요청을 거절하는 fail-closed를 선택하지만 정상 추론의 가용성도 quota 서비스에 종속됩니다. 이 설명은 설정과 문서 대조이며 장애 주입 결과가 아닙니다.
토큰 집계는 금액 정산과 다릅니다. 모델별 단가와 캐시 과금 조건을 반영하지 않은 토큰 한도로 조직 전체 청구액을 보장할 수는 없습니다. 동시 요청의 초과량, Redis 장애와 복구 동작도 별도 실행 검증이 필요합니다.
5. Provider 연결과 prompt cache의 지원 범위
공식 provider 지원표는 API schema 변환과 upstream 인증을 구분합니다. 전자는 AIServiceBackend.spec.schema, 후자는 BackendSecurityPolicy로 설정합니다. OpenAI, AWS Bedrock, Azure OpenAI와 Google 계열 연결을 지원한다는 사실이 모든 endpoint와 vendor-specific 필드의 동일 동작을 보장하지는 않습니다.
v1.1의 Google Gemini on AI Studio는 OpenAI 호환 endpoint를 사용합니다. Google Vertex AI는 GCPVertexAI, Vertex AI의 Claude는 GCPAnthropic schema로 구분합니다. 배포할 모델의 endpoint, 요청 형식과 인증 조합을 지원표 및 provider 가이드에서 함께 확인해야 합니다.
unified cache_control 지원 백엔드 | API schema | Gateway 처리 |
|---|---|---|
| Anthropic Direct | Anthropic | native cache_control 사용 |
| GCP Vertex AI의 Claude | GCPAnthropic | provider 형식으로 변환 |
| AWS Bedrock의 Claude | AWSBedrockAnthropic | provider 형식으로 변환 |
요청 content block 등에 cache_control: {"type": "ephemeral"}을 지정하면 Gateway가 전달하거나 변환합니다. 캐시는 Gateway가 아니라 각 provider가 유지합니다. Gateway 내부의 범용 응답 캐시나 semantic cache가 아니며 provider 간 공유 캐시도 아닙니다. 표는 v1.1 unified API 범위입니다. 다른 provider 자체의 캐시 지원, 최소 입력 길이, TTL과 과금은 해당 모델 문서에서 확인해야 합니다.
6. 클라이언트 인증과 provider 자격증명
클라이언트 인증과 provider 자격증명은 서로 다른 신뢰 경계에 있습니다.
| 목적 | 사용하는 리소스 |
|---|---|
| 클라이언트 JWT, OIDC, IP 접근 제어 | Envoy Gateway SecurityPolicy |
| 클라이언트 mTLS | Gateway HTTPS/TLS listener와 ClientTrafficPolicy.spec.tls.clientValidation |
| provider 인증 방식과 자격증명 참조 | AI Gateway BackendSecurityPolicy |
| 장기 API 키 저장 | Kubernetes Secret |
정책 종류별 targetRefs를 확인해 Gateway 또는 생성된 HTTPRoute에 연결하고, 클라이언트 mTLS는 listener와 ClientTrafficPolicy로 구성합니다. 지원되는 AWS, Azure와 GCP 인증에서는 cloud identity 기반 단기 자격증명을 사용할 수 있습니다. controller는 자격증명을 담은 ext-proc 설정 Secret도 관리하므로 원본 키뿐 아니라 생성된 Secret의 RBAC, 저장 암호화와 회전 운영도 고려해야 합니다.
v1.1의 credentialOverride는 신뢰된 필터가 요청별 upstream 자격증명을 제공하는 기능입니다. dynamic metadata 또는 요청 헤더 중 하나를 소스로 선택하며 릴리즈는 dynamic metadata를 권장합니다. 헤더를 사용한다면 클라이언트 입력을 그대로 신뢰하지 않아야 합니다. fallbackToConfigured 기본값은 true이므로 override가 없을 때 정적 자격증명으로 처리할지도 의도에 맞게 설정해야 합니다.
7. 관측 데이터의 생성과 노출
Agent Router는 토큰 사용량, 최초 토큰까지의 시간과 토큰 사이 지연 등을 Prometheus 메트릭으로 제공합니다. access log 필드는 별도 출력 설정으로 선택합니다. AIGatewayRoute.spec.llmRequestCosts로 사용량 metadata를 정의하고 EnvoyProxy.spec.telemetry.accessLog에서 참조합니다. 공식 예제는 요청 모델을 X-AI-EG-MODEL 헤더에서, 응답 모델과 사용량을 io.envoy.ai_gateway dynamic metadata에서 추출하며 EnvoyProxy를 Gateway 또는 GatewayClass에 연결합니다.
트레이싱은 OpenTelemetry collector endpoint를 설정해 활성화합니다. v1.1 기본 semantic convention은 OpenInference이며 ext-proc에 AI_GATEWAY_TRACING_SEMCONV=gen_ai를 지정하면 OpenTelemetry GenAI 속성을 선택할 수 있습니다. span과 속성 이름이 달라지므로 대시보드 및 알림 쿼리도 확인해야 합니다.
OpenInference는 기본적으로 요청과 응답 내용을 포함할 수 있어 OPENINFERENCE_HIDE_INPUTS, OPENINFERENCE_HIDE_OUTPUTS 등으로 수집 범위를 정해야 합니다. gen_ai의 내용 수집은 opt-in이며 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true로 활성화합니다. OPENINFERENCE_HIDE_* 설정은 gen_ai에 적용되지 않습니다. convention만 바꾸고 기존 redaction 설정이 계속 유효하다고 가정하면 안 됩니다.
8. InferencePool의 endpoint 선택과 AI 처리
v1.1 문서는 HTTPRoute + InferencePool과 AIGatewayRoute + InferencePool 경로를 각각 설명합니다. InferencePool은 추론 endpoint 집합을 선언하고 Gateway API Inference Extension의 Endpoint Picker Provider(EPP)가 endpoint 선택을 담당합니다. EPP와 ext-proc는 별도 역할입니다.
HTTPRoute 경로에서는 Envoy가 EPP에 endpoint 선택을 요청합니다. AIGatewayRoute 경로에서는 모델 추출, 요청과 응답 변환 및 사용량 metadata 생성도 결합됩니다. Inference Extension CRD, Envoy Gateway의 InferencePool 지원 설정과 Endpoint Picker 배포가 필요하며, endpoint 선택 문제와 AI 처리 문제를 구분해 추적해야 합니다.
9. MCP 도구 집계와 개발 문서의 A2A
v1.1의 MCPRoute는 여러 MCP 서버를 하나의 endpoint로 집계하고 Streamable HTTP 트래픽을 처리합니다. toolSelector는 include 또는 includeRegex 중 하나로 노출할 도구를 제한하며, 생략하면 해당 서버의 모든 도구가 노출됩니다. OAuth 인증과 JWT claims, scopes, CEL 기반 인가 및 upstream API 키 설정을 지원합니다. 도구 목록 필터링과 호출자의 권한 검사는 구분해 구성해야 합니다.
안정판의 도구 이름은 기본적으로 backend__tool 형태로 prefix가 붙습니다. 예를 들어 github__issue_read는 backend를 선택하는 데 사용됩니다. standalone CLI는 --mcp-config 또는 --mcp-json으로 HTTP 계열 MCP 서버를 설정하고 http://localhost:1975/mcp를 제공하지만 모든 stdio 서버의 지원을 뜻하지는 않습니다.
2026-10-06 확인한 main의 MCP prefixMode=Never, injectionPolicy와 quota 수정은 v1.1.0 출시 기능으로 합치지 않습니다. 운영 설정은 안정판 태그에서 필드와 동작을 확인해야 합니다.
개발 문서의 A2A는 Envoy의 alpha envoy.filters.http.a2a와 EnvoyPatchPolicy를 사용하는 preview입니다. 전용 A2A route 타입은 아직 없으며 v1.1의 정식 A2ARoute 출시로 해석하면 안 됩니다. 해당 문서는 신뢰된 클라이언트와 agent 환경, 패치 권한 제한을 요구하는 별도 경로입니다.
10. Reference
- Agent Router - Rename and AAIF Announcement
- Agent Router - README
- Agent Router - v1.1.0 Release
- Agent Router - v1.1 Compatibility Matrix
- Agent Router v1.1 - License
- Agent Router v1.1 - Standalone CLI
- Agent Router v1.1 - Control Plane
- Agent Router v1.1 - Go External Processor
- Agent Router v1.1 - Basic Configuration
- Agent Router v1.1 - Usage-based Rate Limiting
- Agent Router v1.1 - Quota Policy
- Agent Router v1.1 - QuotaPolicy API Source
- Agent Router v1.1 - Helm Values
- Agent Router v1.1 - Supported Providers
- Agent Router v1.1 - Prompt Caching
- Agent Router v1.1 - Upstream Authentication
- Agent Router v1.1 - Security Policy Attachment
- Envoy Gateway v1.8.1 - External Client Mutual TLS
- Agent Router v1.1 - Access Logs
- Agent Router v1.1 - Distributed Tracing
- Agent Router v1.1 - InferencePool Support
- Agent Router v1.1 - MCP Gateway
- Agent Router Development - MCP Gateway
- Agent Router Development - A2A Preview
궁금하신 점이나 추가해야 할 부분은 댓글이나 아래의 링크를 통해 문의해주세요.
Written with KKamJi