Cilium Service Mesh [Cilium Study 6주차]
Service란 특정 비즈니스 기능을 제공하는 독립 배포 가능한 소프트웨어 단위입니다. Micro Service Architecture는 수십 개 이상의 서비스가 상호 호출하며 전체 제품을 구성합니다. 이로 인해 각 서비스마다의 가용성 확보, Service 종단 간 암호화, 복잡해진 트래픽 흐름에 대한 가시성 확보 등의 추가적인 요구사항이 더욱 중요해졌습니다. 이런 문제를 해결하기 위해 초기에는 각 Application에 해당 기능의 역할을 수행하는 라이브러리를 사용해 해결했지만 규모가 커질수록 Code 중복과 일관성 저하 문제가 생기게 되었습니다.
아래 EXAMPLE A, B, C는 특정 workload가 아닌 개념 예시입니다. 직접 호출이 늘수록 각 service가 retry, auth, traffic control, telemetry를 반복해서 관리해야 합니다.
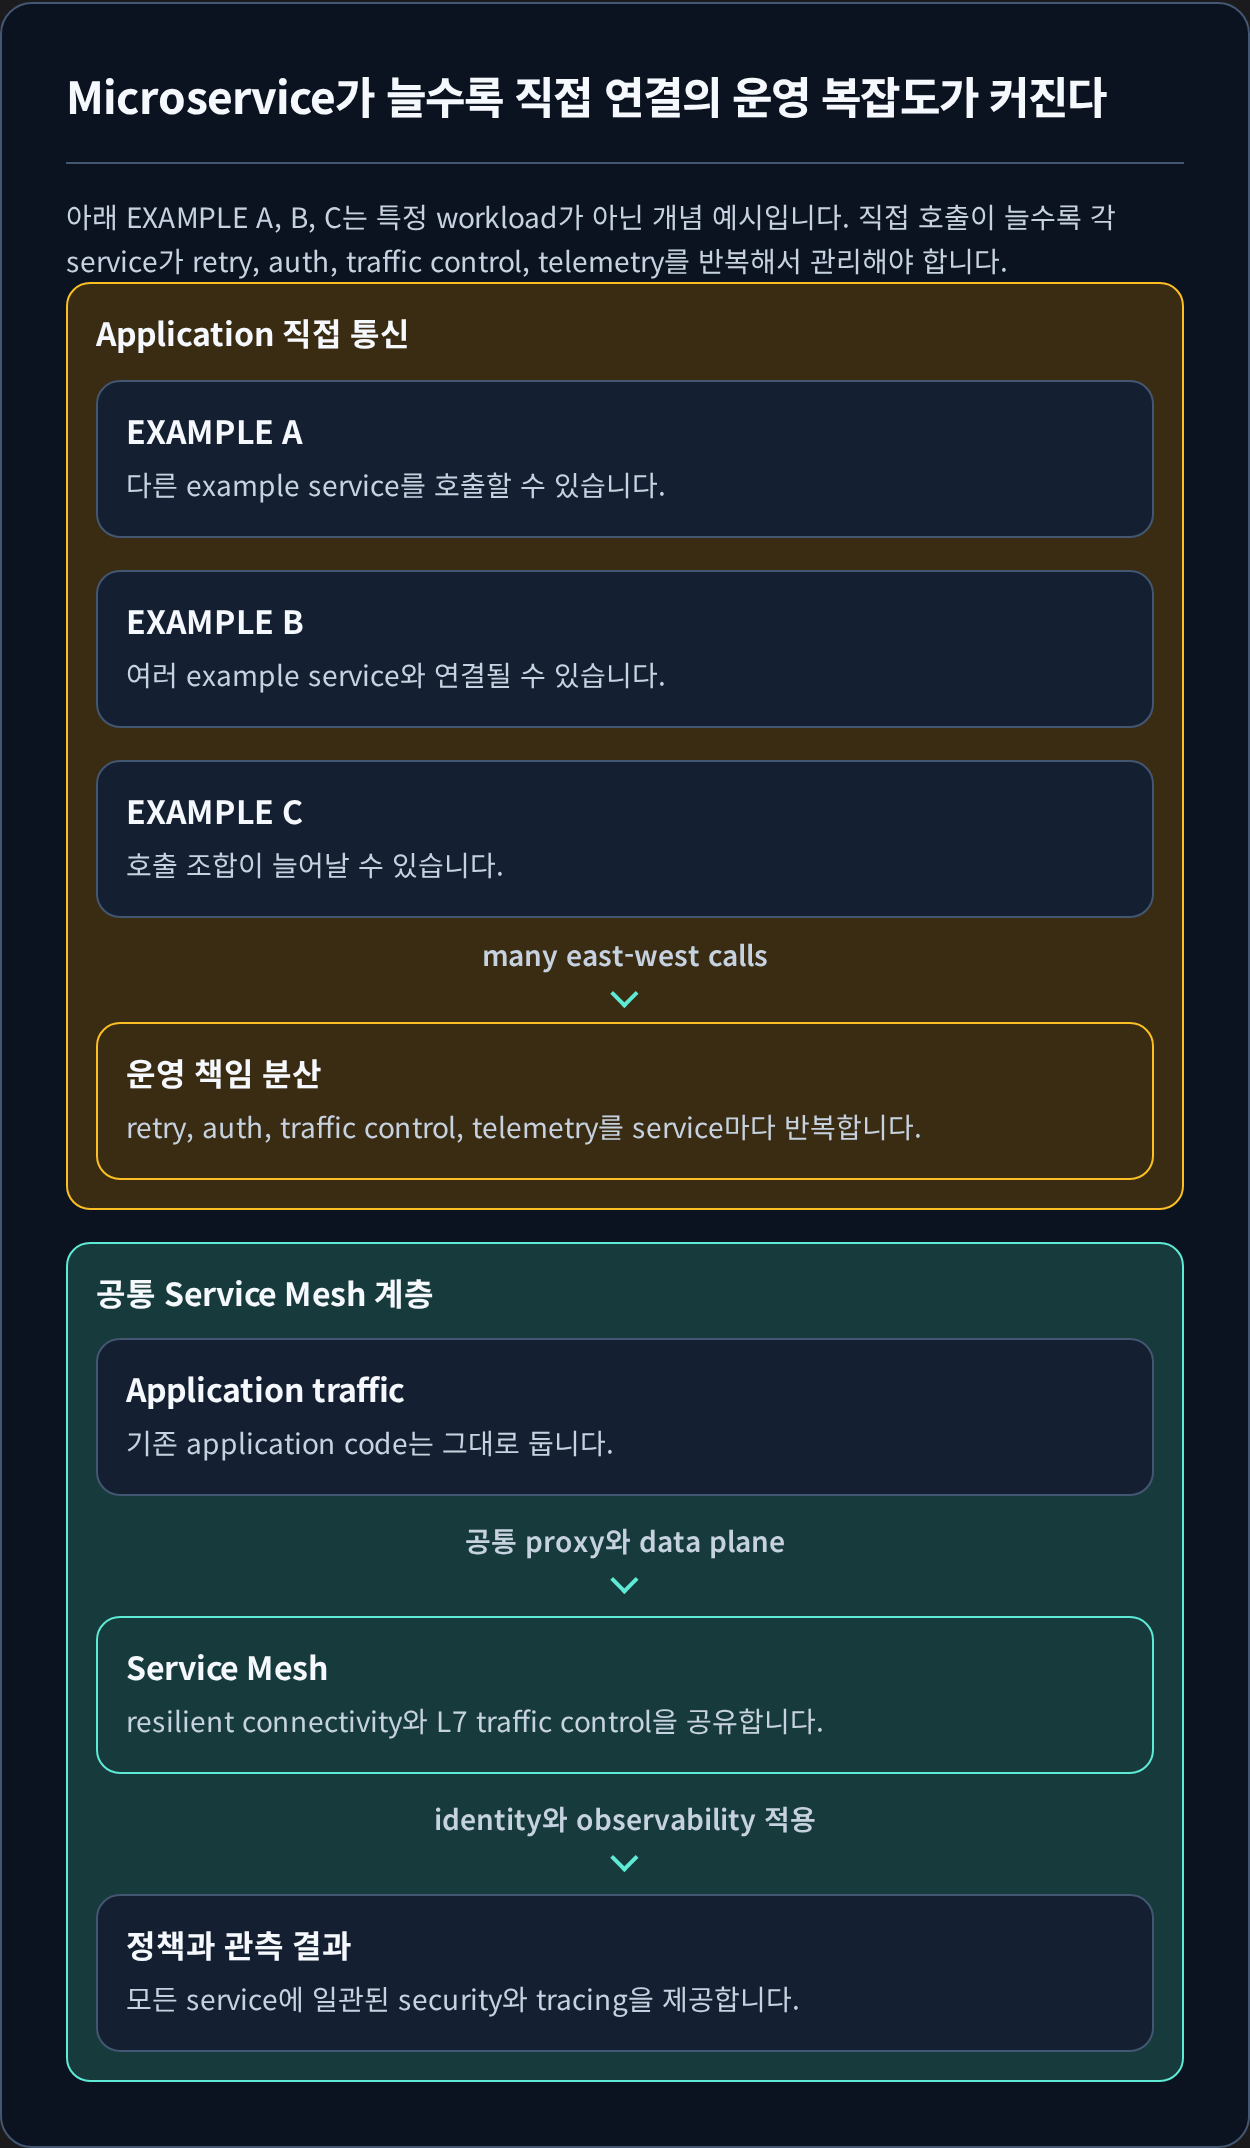
Service Mesh는 아래와 같은 요구사항을 충족 시키기 위한 기능들을 Application 바깥의 Infra 구성요소로 추상화해 모든 Application이 공통 기능을 재사용하도록 합니다.
- Resilient Connectivity - Cloud, Cluster, On-Premise 등의 경계를 넘어 서비스 간 통신이 가능해야 하고, 통신은 복원력과 내결함성(FT)을 갖춰야 함
- L7 Traffic Management - Load balancing, rate limiting, and resiliency must be L7-aware (
HTTP,REST,gRPC,WebSocket, …). - Identity-based Security - 서비스간 통신에 있어, 네트워크 식별자를 기반으로 하는 인증 대신 Identities를 기반으로 서로 인증 할 수 있어야함
- Observability & Tracing - Application 안정성, 성능 및 가용성을 이해하고, 모니터링하고, 문제를 해결하기 위해 추적 및 측정 형태로 관찰 가능해야 함
- Transparency - Application Code를 변경하지 않고도 사용할 수 있어야 합
TL;DR
- Service Mesh는 Pod 사이 통신 경로에 프록시를 놓아 애플리케이션 코드를 고치지 않고 트래픽을 관측하고 제어하는 방식입니다.
- Istio나 Linkerd는 Pod마다 사이드카를 붙이지만, Cilium은 노드 단위 Envoy와 eBPF로 처리해 사이드카를 없앱니다.
- 실습 환경은 k8s-ctr(192.168.10.100), k8s-w1(192.168.10.101), router(192.168.10.200)입니다.
1. 실습 환경
Pod CIDR: 172.20.0.0/16
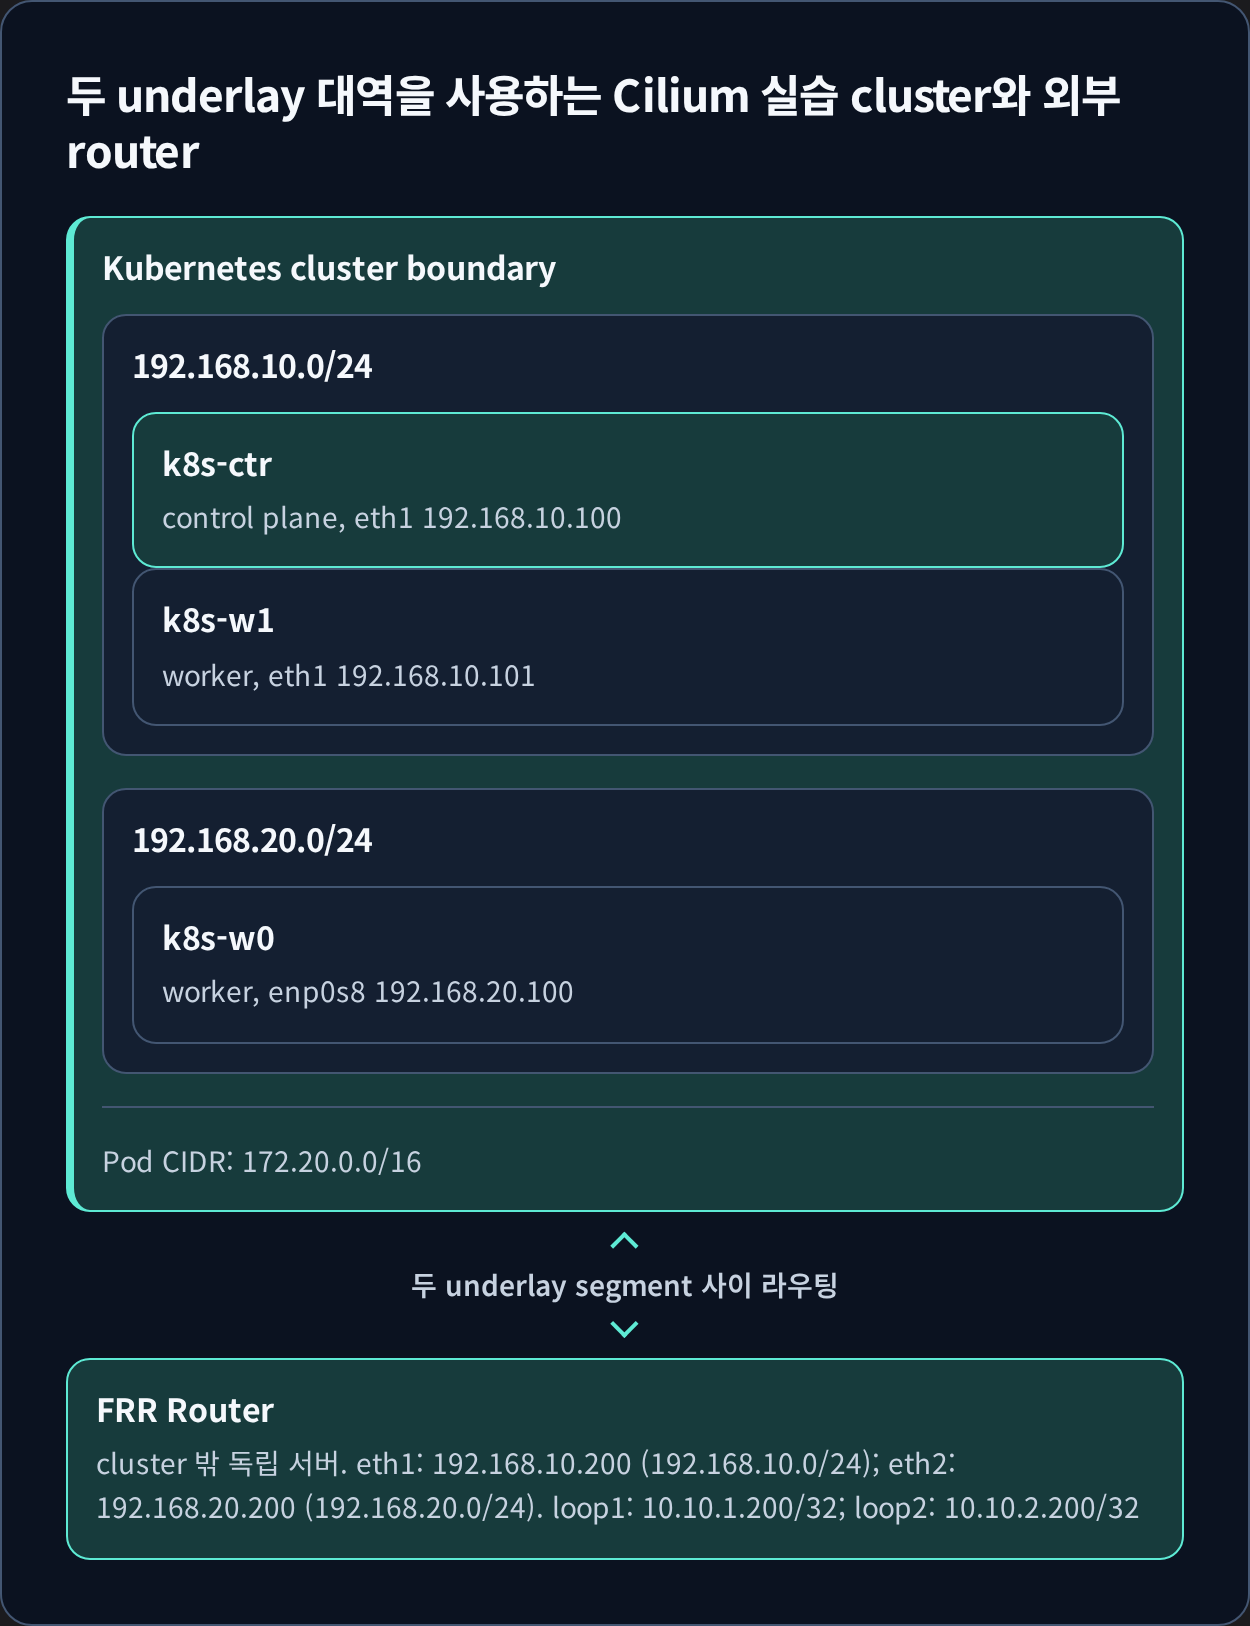
- k8s-ctr (192.168.10.100)
- k8s-w1 (192.168.10.101)
router (192.168.10.200, 192.168.20.200 but 192.168.20.0/24 CIDR은 사용하지 않음)
- GitHub - Vagrantfile & Setup Script
2. Service Mesh의 기본 개념
개념: 마이크로서비스 간에 매시 형태의 통신을 기반으로 통신 경로 제어 - ex) Istio, Linkerd
기본 동작: 파드 간 통신 경로에 프록시를 놓고 트래픽 모니터링이나 트래픽 컨트롤 -> 기존 Application 코드에 수정 없이 동작
2.1. 기존 통신 환경 소개
이 경로만으로는 traffic control, observability, security policy를 모든 Application에 일관되게 적용하기 어렵습니다.
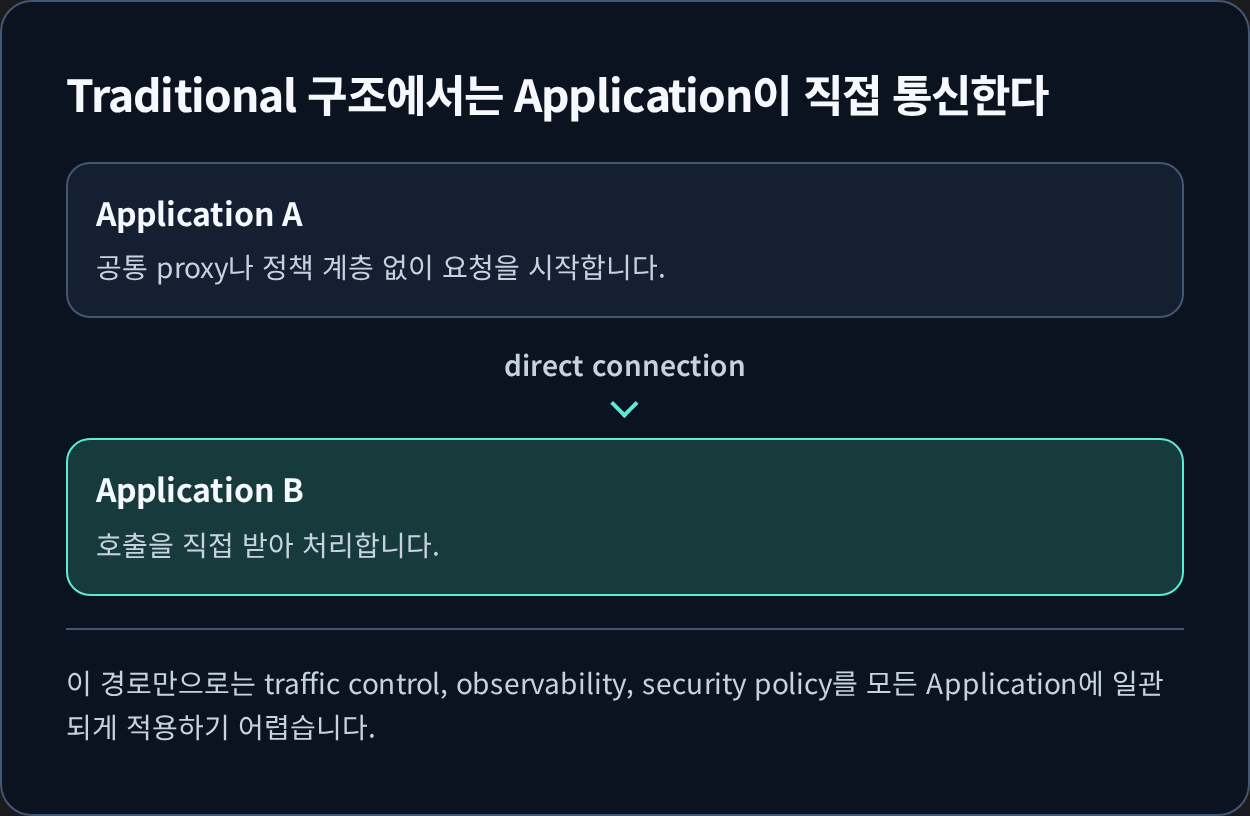
- Application <-> Application 간 별도의 제어 없이 직접 연결
- 문제: 트래픽 제어,관찰,보안 정책 적용이 어려움
2.2. Proxy 도입을 통한 제어
각 application에는 sidecar proxy가 있고, iptables rule은 application traffic을 local sidecar로 redirect한 뒤 proxy 사이의 경로로 전달한다.
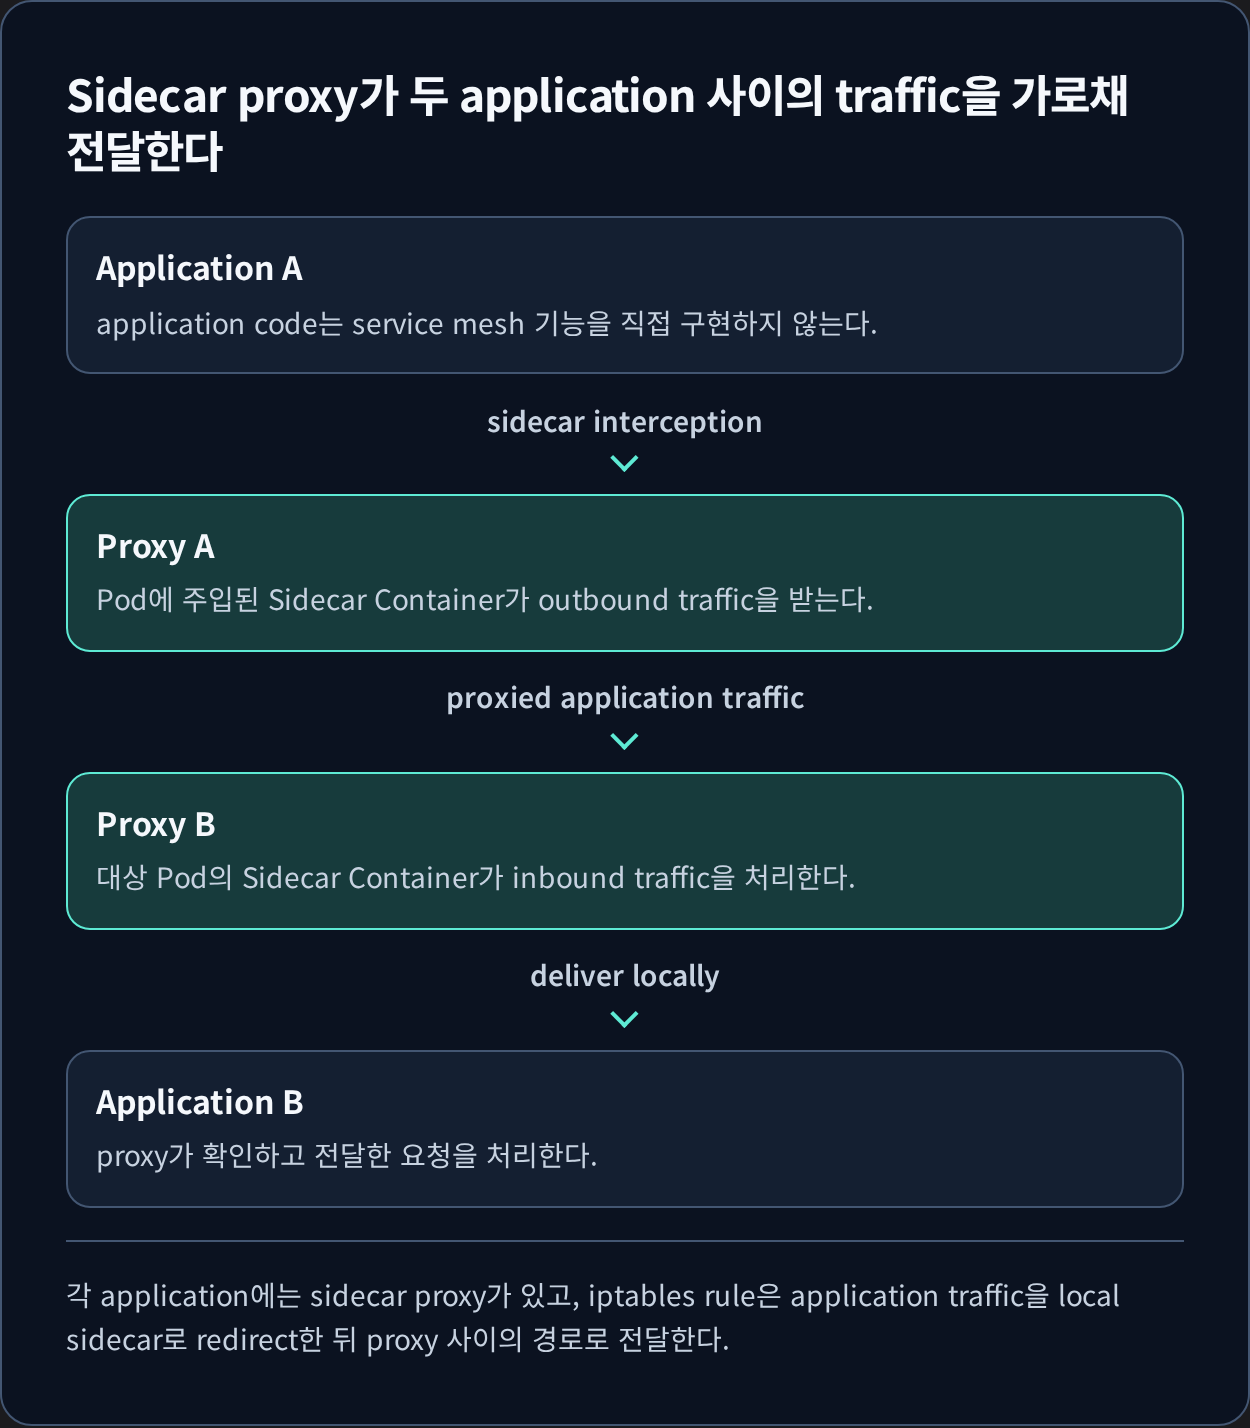
- 모든 Application 통신 사이에 Proxy를 두어 통신 흐름을 가로챔
- Proxy는 파드 내 Sidecar Container로 주입되어 동작
- Application 트래픽을 Proxy가 가로채려면 iptables rule 기반 구현 필요
- 장점: Application 코드 수정 불필요, 중앙집중식 정책 적용 가능
2.3. Control Plane을 통한 중앙 관리
Proxy 사이의 application traffic은 Data Plane이고, Control Plane configuration은 두 proxy에 전달된다. 각 proxy는 sidecar 기반 Data Plane으로 동작한다.
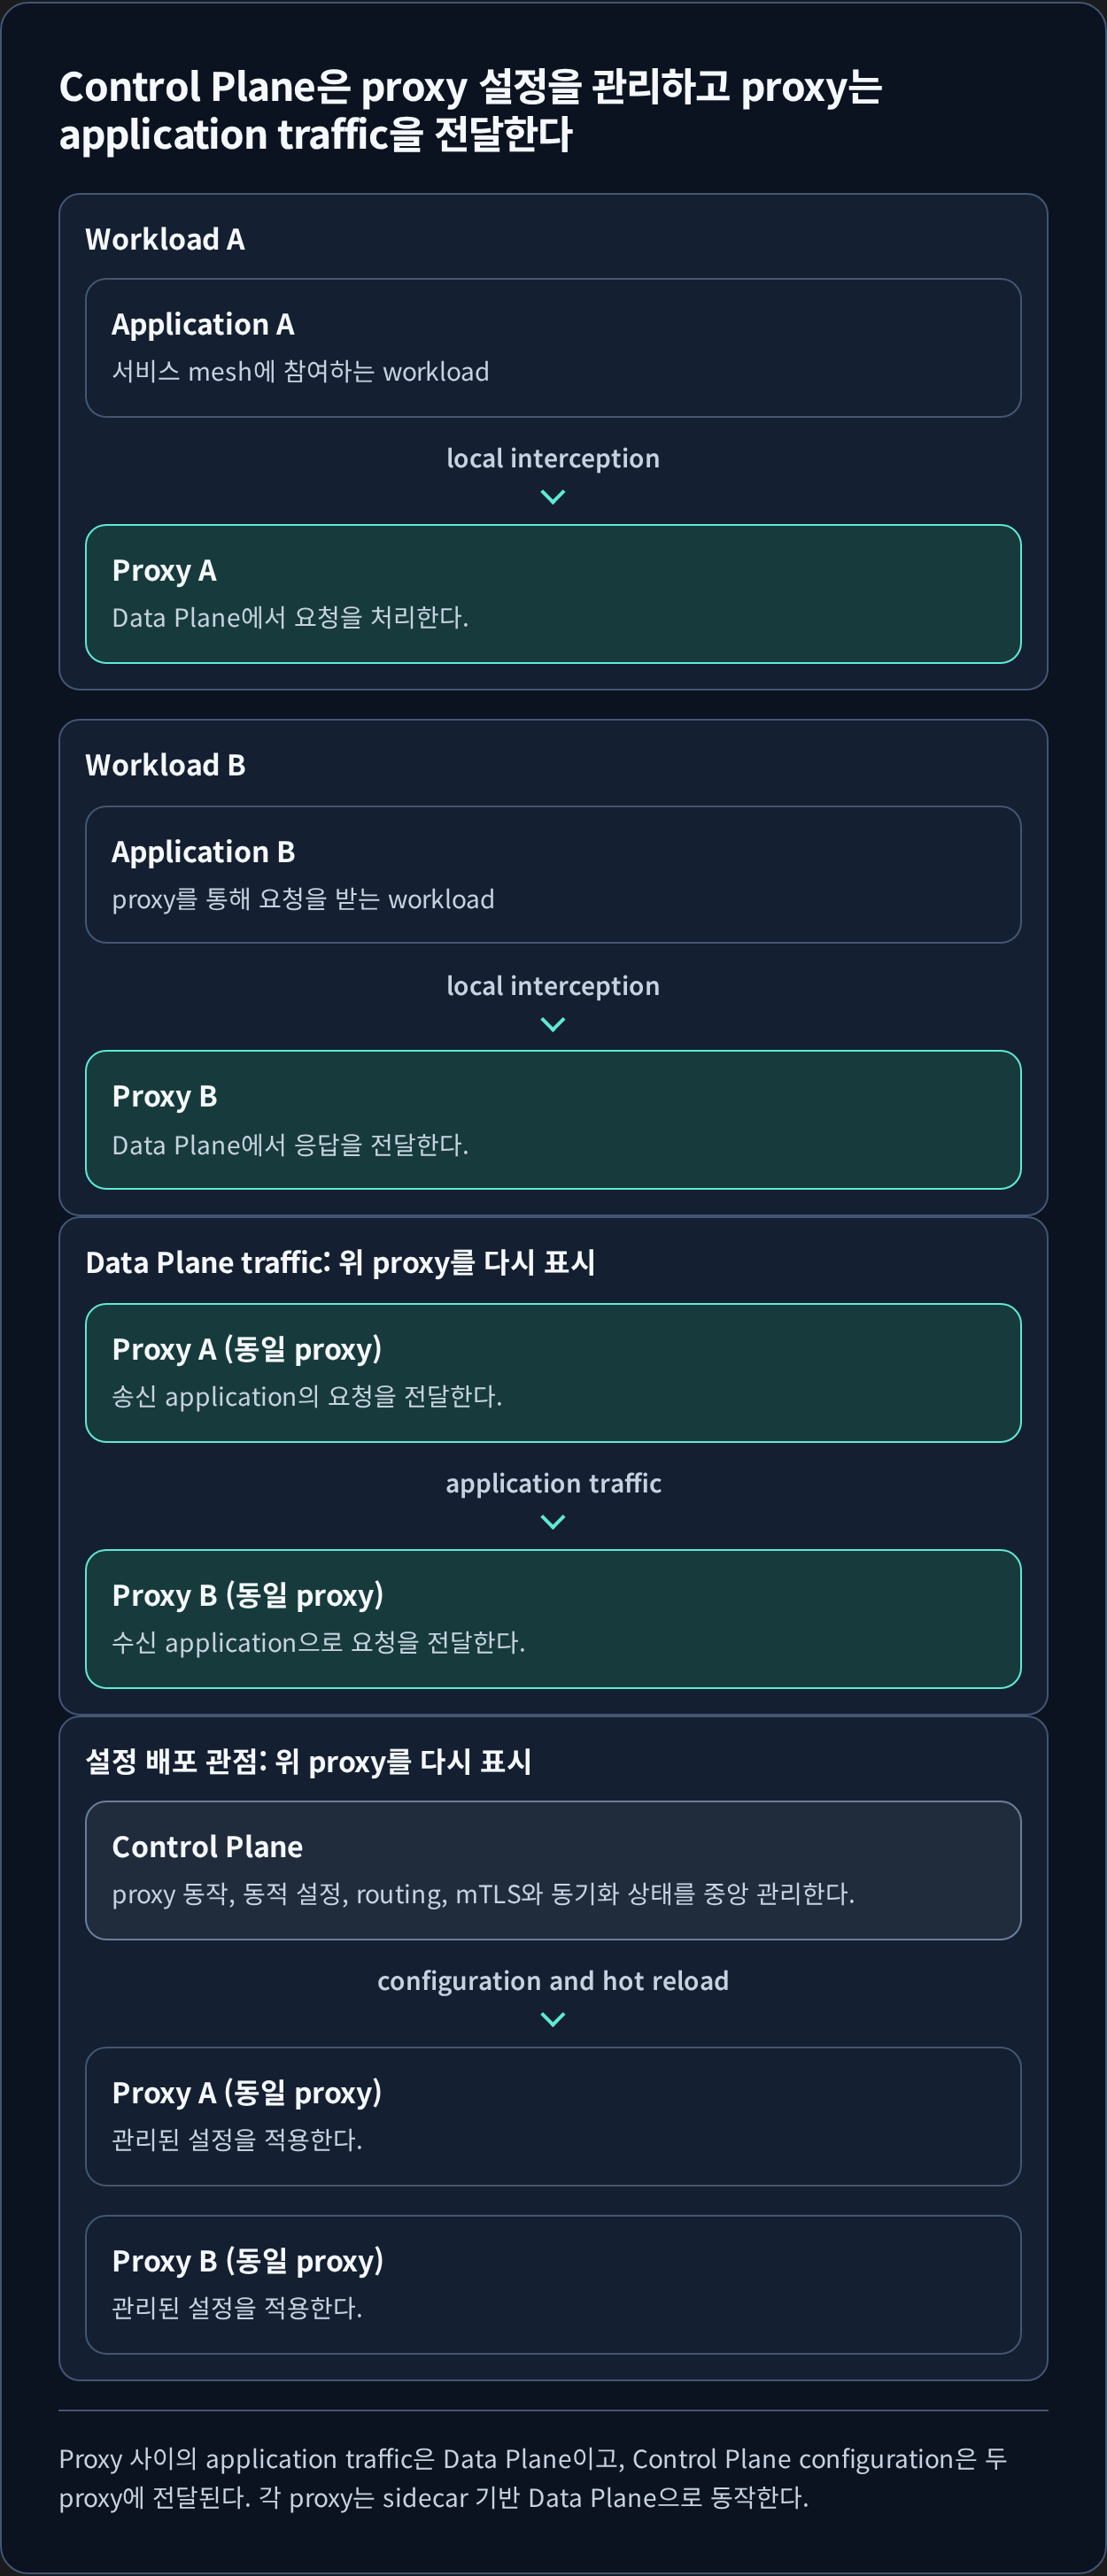
- Proxy는 결국 Data Plane이므로 중앙에서 관리할 Control Plane 필요
- Control Plane 역할
- Proxy의 동작/설정을 원격에서 동적으로 관리
- 풍부한 API 제공 및 hot reload 지원 필요
- 라우팅, mTLS 기반 보안 통신, 동기화 상태 정보 등 중앙 관리
- 대표 구현: Envoy Proxy (고성능, 동적 설정 API, 다양한
L3~L7필터 지원)
3. Sidecar 중심 Service Mesh 방식의 문제
기존 Sidecar 기반 메시(파드마다 프록시 주입)는 기능은 풍부하지만 다음 제약이 있습니다.
1) 운영 오버헤드
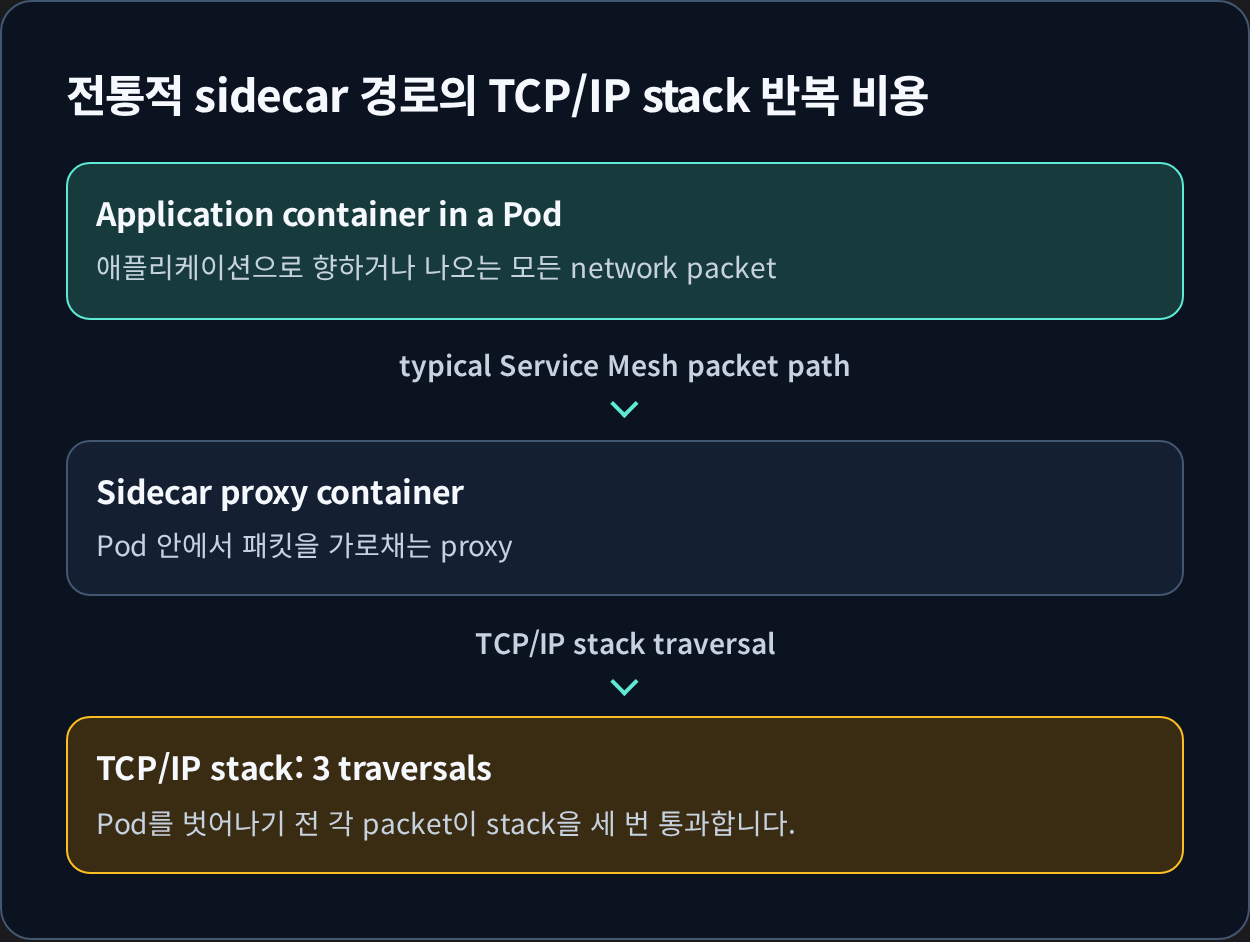
- 파드 수만큼 Proxy가 늘어나 CPU/Memory Overhead 증가, Cold-Start 지연 - Upgrade, Rollout, Sidecar-Application 동기화 부담 2) 데이터 경로 복잡도
- iptables 중심 리다이렉트 체인이 길어 디버깅과 예측 가능성이 떨어짐
3) 확장성과 경계 문제
- Multi-Cluster, On-Premise와 Cloud 경계를 넘는 통신에서 Routing, Load Balancing, Network Policy에 대한 일관성 유지가 어려움 4) 가시성과 보안의 분산
- 서비스별 라이브러리 구성은 관찰지표와 인증정책의 표준화에 지장을 줌
4. Cilium Service Mesh
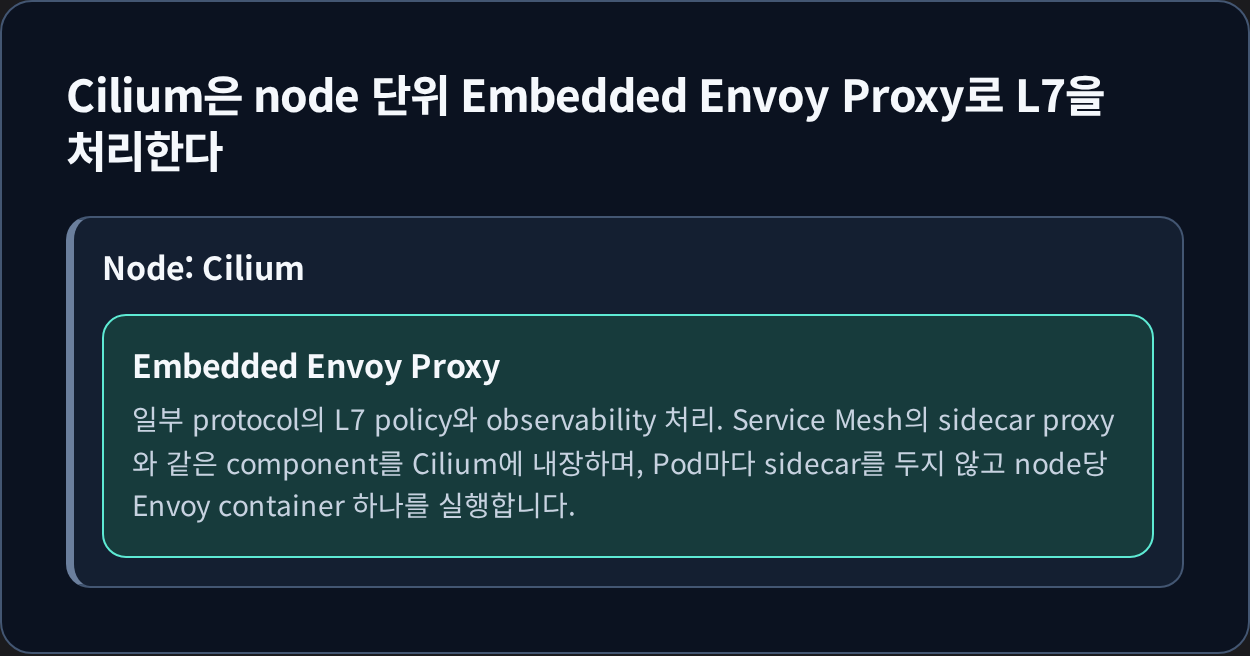
Cilium은 eBPF 기반 CNI에서 출발해 L3/L4은 eBPF Data-Path로, L7은 내장 Envoy로 처리하는 Service Mesh를 제공합니다. Sidecar가 필요하지 않아 경량이며, Kubernetes 리소스와 Gateway API로 선언적으로 제어합니다.
- Control Plane
- CiliumNetworkPolicy, ClusterwidePolicy로
L3~L7접근 제어 - Gateway, HTTPRoute, TLSRoute로
North-South,East-WestRouting 선언적 관리 SPIFFE/SPIRE,PKI와 연계해 상호 인증(mTLS) 구성
- CiliumNetworkPolicy, ClusterwidePolicy로
- Data Plane
L3/L4:IP,TCP,UDP처리 경로를 커널 eBPF로 단축L7:HTTP,gRPC,Kafka,DNS등은 cilium-agent 관리Envoy가 파싱,정책 평가- eBPF 훅이 Socket/Packet 수준에서 트래픽을 가로채
TPROXY경로로Envoy전달
- Observability
- Hubble로
L3~L7플로우, 지표, 드랍 원인을 즉시 관찰
- Hubble로
- 효과
- Sidecar 제거 -> 리소스 오버헤드,운영 복잡도 축소
- eBPF Data Path -> 지연 감소, 경로 단순화
- Identity 기반 정책,관찰성 표준화
- Multi-Cluster 및 On-premise/Cloud 경계 회복성 있는 연결성 확보
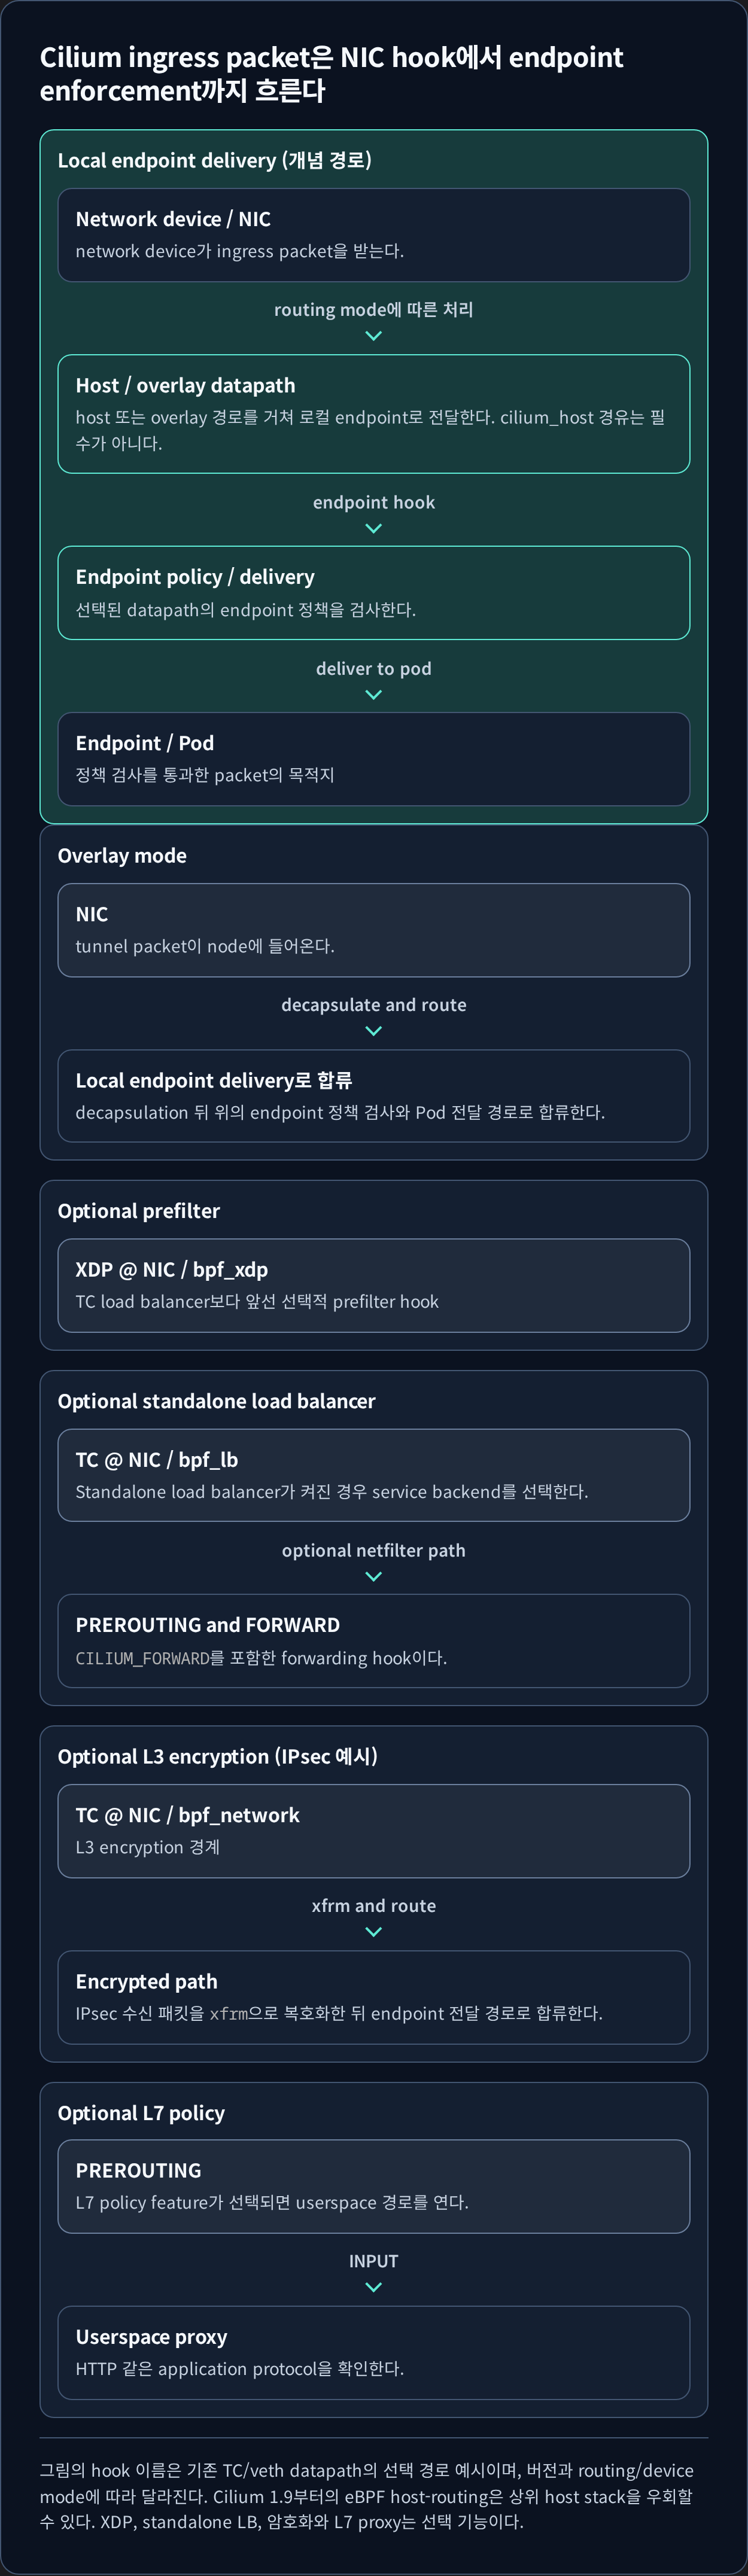
CILIUM_FORWARD를 포함한 forwarding hook이다.xfrm으로 복호화한 뒤 endpoint 전달 경로로 합류한다.그림의 hook 이름은 기존 TC/veth datapath의 선택 경로 예시이며, 버전과 routing/device mode에 따라 달라진다. Cilium 1.9부터의 eBPF host-routing은 상위 host stack을 우회할 수 있다. XDP, standalone LB, 암호화와 L7 proxy는 선택 기능이다.
- 트래픽 모니터링 : 요청의 ‘에러율, 레이턴시, 커넥션 개수, 요청 개수’ 등 메트릭 모니터링, 특정 서비스간 혹은 특정 요청 경로로 필터링 -> 원인 파악에 용이
- 트래픽 컨트롤 : 트래픽 시프팅(Traffic shifting), 서킷 브레이커(Circuit Breaker), 폴트 인젝션(Fault Injection), 속도 제한(Rate Limit)
- 트래픽 시프팅(Traffic shifting) : 예시) 99% 기존앱 + 1% 신규앱 , 특정 단말/사용자는 신규앱에 전달하여 단계적으로 적용하는 카니리 배포 가능
- 서킷 브레이커(Circuit Breaker) : 목적지 마이크로서비스에 문제가 있을 시 접속을 차단하고 출발지 마이크로서비스에 요청 에러를 반환 (연쇄 장애, 시스템 전제 장애 예방)
- 폴트 인젝션(Fault Injection) : 의도적으로 요청을 지연 혹은 실패를 구현
- 속도 제한(Rate Limit) : 요청 개수를 제한
5. Cilium Ingress
Cilium은 Kubernetes 표준 Ingress 리소스를 지원하며, ingressClassName: cilium을 사용합니다.
해당 방식으로 Path 기반 라우팅과 TLS 종료(Termination)를 제공할 수 있습니다.
기존 호환성을 위해 kubernetes.io/ingress.class: cilium annotation도 지원합니다.
5.1. Cilium Ingress의 동작 방식
- Ingress Controller는
LoadBalancer타입의 Service를 생성합니다 -> 클러스터가 존재하는 환경에서 LoadBalancer Type Resource 지원 필요 dedicatedMode: Ingress별 전용 LB를 생성- Dedicated 모드는 충돌을 방지하지만 LB 자원 소비가 늘어남
sharedMode: Kubernetes Cluster 전체 Ingress가 하나의 LB를 공유- Shared 모드는 자원 절약에 유리하지만, Path Prefix 충돌 가능성이 있음
- 모드 변경 시 LB IP가 바뀌며, 기존 연결이 종료될 수 있음
5.2. 필수 조건
nodePort.enabled=true또는kubeProxyReplacement=true설정 필요 -> kube-proxy replacementl7Proxy=true(기본값: true) 활성화 필요- Ingress Controller는 기본적으로
LoadBalancer Service를 생성하므로 Load Balancer 지원 환경 필요- LB가 불가능한 경우 NodePort 또는 Cilium 1.16+에서는 Host Network 모드로 Envoy를 직접 노출 가능
5.3. Cilium Ingress/Gateway API가 다른 Ingress Controller와 다른 점
- CNI와 밀접하게 통합 -> 다른 Ingress 컨트롤러와 달리 Cilium 네트워킹 스택 일부로 동작
- 일반적인 Ingress 컨트롤러는
Deployment/Daemonset형태로 배포되며 LB Service를 통해 노출 - Cilium의 Ingress/Gateway API
LoadBalancer/NodePort/HostNetwork등 다양한 방식으로 Envoy 노출 가능- 패킷이 Service IP:Port에 도달하면 eBPF가 이를 가로채고
TPROXY를 이용해 Envoy Proxy로 전달 - 원본
Source/DestinationIP,Port를 유지한 채 Envoy가 투명하게 트래픽 처리 가능
5.4. Cilium Ingress와 CiliumNetworkPolicy
- Ingress와 Gateway API 트래픽은 노드 단위 Envoy Proxy를 경유
- Envoy Proxy는 eBPF Policy Engine과 상호작용하여 정책 조회 수행. 즉, Ingress 트래픽에도 CiliumNetworkPolicy를 적용할 수 있음
외부에서 들어오는 트래픽에는 world identity가, Ingress 내부 트래픽에는 ingress identity가 부여됨
- Identity 흐름 예시
- 외부에서 들어오는 트래픽은 기본적으로
worldidentity - Envoy로 진입하면
ingressidentity - 백엔드로 나갈 때는 해당 워크로드의 identity
- 외부에서 들어오는 트래픽은 기본적으로
world identity입니다.ingress입니다.productpage인 backend입니다. source는 ingress로 평가합니다.정책 집행 지점은 world에서 ingress로 들어오는 경계와 ingress에서 backend로 나가는 경계에 각각 있습니다.
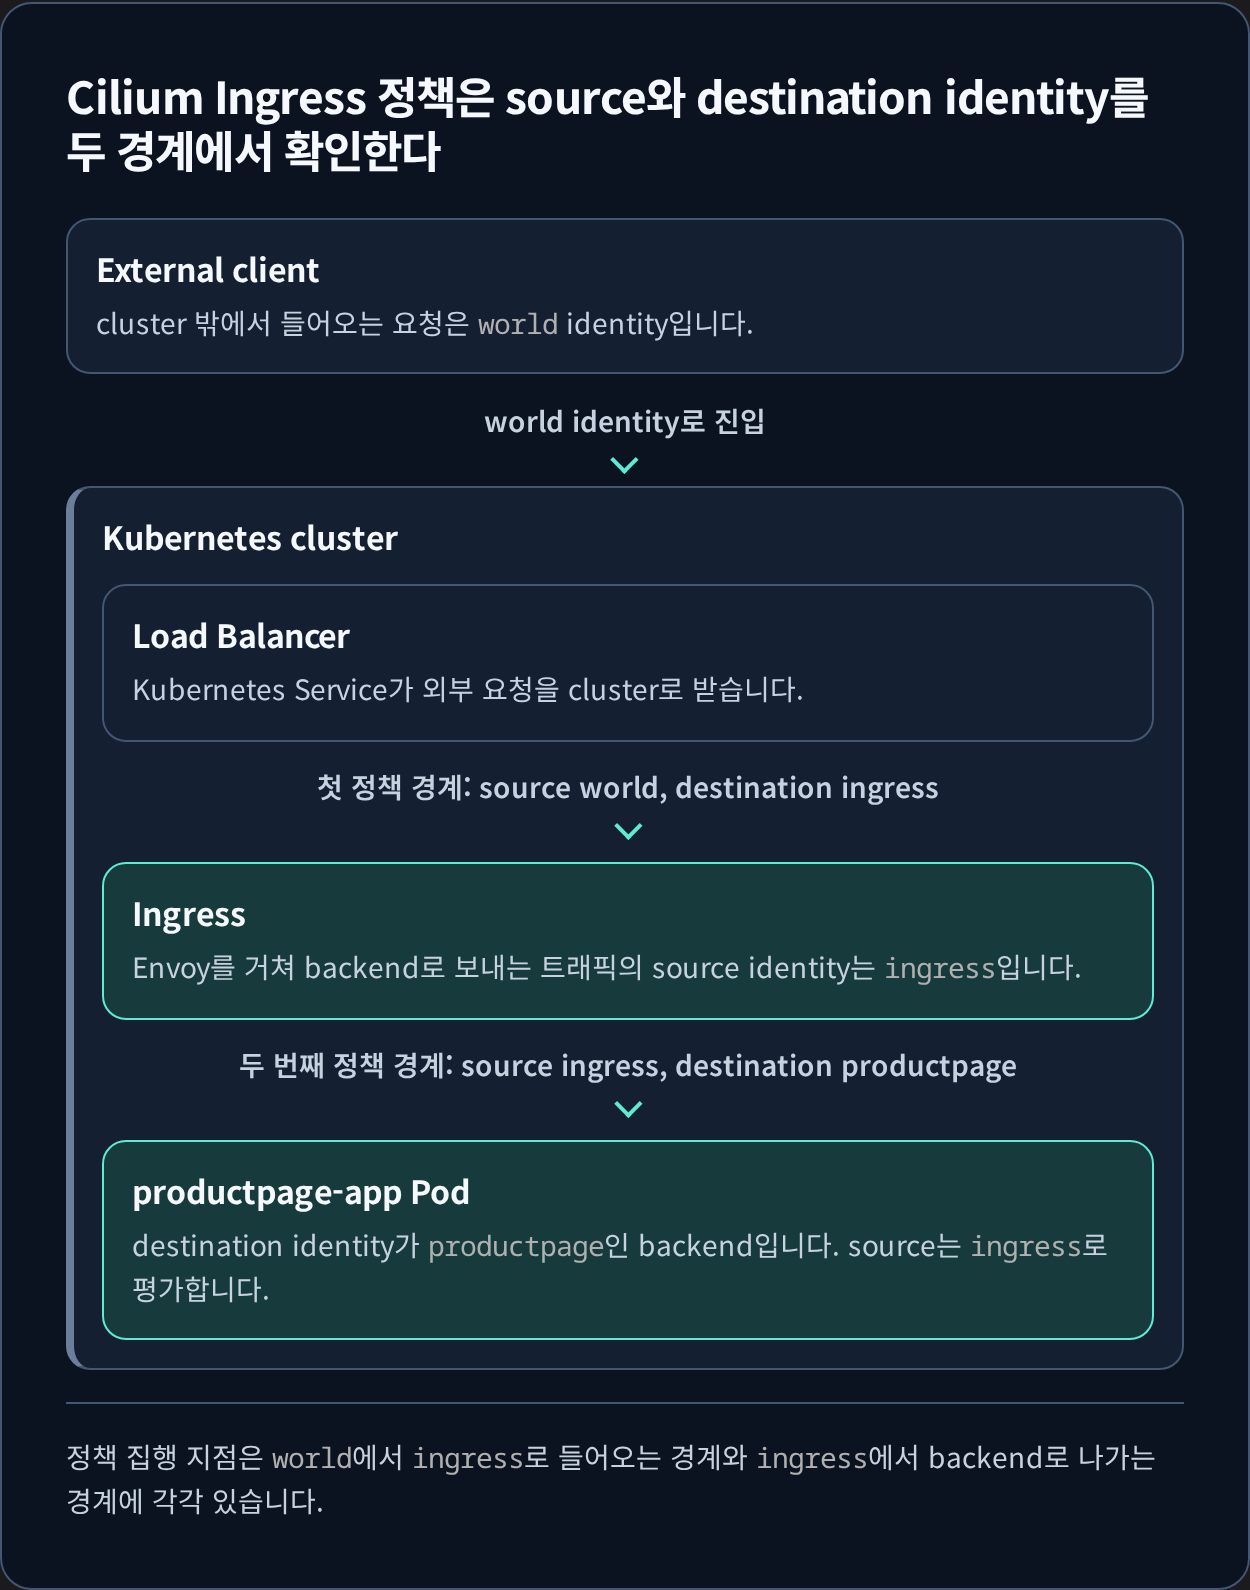
- 결과적으로 아래와 같은 두 단계의 정책 집행 지점이 존재
- world -> ingress
- ingress -> backend service identity
5.5. Source IP Visibility
- 기본 설정
- Envoy는 수신 HTTP 연결의 소스 주소를
X-Forwarded-For헤더에 추가 X-Envoy-External-Address헤더에도 신뢰된 클라이언트 주소를 기록- 기본
trusted hops값은 0이므로, Envoy는 실제 연결의 peer 주소를 사용
- Envoy는 수신 HTTP 연결의 소스 주소를
5.6. externalTrafficPolicy for Loadbalancer or NodePort Services
Cilium의 Ingress 지원(Ingress와 Gateway API 모두)은 Envoy Daemonset을 외부에 노출하기 위해 LoadBalancer 또는 NodePort Service를 자주 사용합니다.
이때 클라이언트 Source IP 가시성과 관련하여 중요한 설정이 바로 externalTrafficPolicy 필드입니다.
5.6.1. Local Mode
- 노드는 로컬에 실행 중인 Pod로만 트래픽을 전달
- 이 과정에서 Source IP를
Masquerading하지 않기 때문에 백엔드 Pod가 실제 클라이언트 IP를 볼 수 있음 - kube-proxy를 사용하는 환경에서는 보통 이 방법이 Source IP를 보장하는 유일한 방법
- 동작 규정
- Kubernetes는
externalTrafficPolicy: Local설정 시 자동으로healthCheckNodePort를 열어 둠 /healthz엔드포인트를 통해 로컬 Pod 유무를 확인할 수 있음- 로컬 Pod가 있으면 200, 없으면 200이 아닌 상태를 반환
- Kubernetes는
5.6.2. Cluster Mode
- 노드는 클러스터 전체의 모든 엔드포인트로 트래픽을 균등하게 전달
- 장점: 트래픽이 특정 노드에 집중되지 않음
- 단점: 일부 경우 Source IP를
Masquerading할 수 있어, 백엔드 Pod가 클라이언트 IP를 보지 못할 수 있음
5.6.3. Cilium Ingress 구성의 externalTrafficPolicy 동작 차이
- Cilium Ingress 구성의 경우(Ingress와 Gateway API 모두) 조금 다르게 동작합니다:
- Envoy를 노출하는 Service에 도착한 모든 트래픽은 항상 로컬 노드로 들어옵니다.
- 그리고 Linux Kernel의 TPROXY 기능을 통해 Envoy로 전달됩니다.
- 따라서 소스 IP는 유지된 채 Envoy에 전달되고, 이후 정책 및 L7 라우팅 처리가 적용됩니다.
- 결론적으로, Cilium에서는
externalTrafficPolicy의 Local/Cluster 설정에 따라 기본 동작이 조금 달라지지만, 소스 IP는 항상 Envoy로 보존됩니다.
5.6.4. TLS Passthrough and Source IP Visibility
Cilium Ingress와 Gateway API 모두 TLS Passthrough 구성을 지원합니다.
- Ingress: annotation 기반
- Gateway API:
TLSRoute리소스 기반
이 구성을 통해 여러 TLS Passthrough 백엔드가 동일한 TLS 포트를 공유할 수 있습니다. Envoy는 TLS 핸드셰이크에서 SNI(Server Name Indication) 필드를 검사해 어떤 백엔드로 TLS 스트림을 전달할지 결정합니다.
문제: 소스 IP 가시성(Source IP Visibility)
Envoy는 TLS 트래픽을 TCP 프록시로 처리하기 때문에, 백엔드 Pod 입장에서 원래 클라이언트 IP를 확인하기 어렵습니다.
- 동작 방식:
- TLS 트래픽이 Envoy에 도착하면 기존 TCP 스트림을 종료
- Envoy는 Client Hello 패킷을 검사하여 SNI 값을 확인
- 선택된 백엔드로 새로운 TCP 스트림을 시작
- 다운스트림(외부) TLS 패킷은 업스트림(백엔드) TCP 스트림 내부로 전달
- 결과적으로, 이는 새로운 TCP 연결이기 때문에 백엔드 입장에서는 소스 IP가 Envoy의 IP(보통 Node IP)로 보임
5.7. Ingress Path Types and Precedence
- Ingress가 지원하는 Path 타입
- Exact: 경로 전체가 정확히 일치
- Prefix:
/단위 접두사 일치 - ImplementationSpecific: IngressClass에 위임. Cilium은 이를 Regex로 해석한다.
- Cilium이 Envoy에 적용하는 우선순위 1) Exact 2) ImplementationSpecific (Regex) 3) Prefix 4)
/Prefix 는 항상 마지막 - 주의
- Regex 사용 시 길이가 긴 패턴이 먼저 매칭될 수 있다. 예:
/impl.*가/impl보다 먼저 매칭되어/impl이 도달하지 못할 수 있다.
- Regex 사용 시 길이가 긴 패턴이 먼저 매칭될 수 있다. 예:
6. Reference
궁금하신 점이나 추가해야 할 부분은 댓글이나 아래의 링크를 통해 문의해주세요.
Written with KKamJi